
Variation Inference(VI, ELBO)
개요
복잡한 데이터를 이해하고싶어서 어떤 요인들이 데이터에 영향을 주는지 알고 싶다. 즉 우리가 보는 데이터가 왜 그렇게 나왔는지 숨은 원인을 알고 싶은 것. (데이터 x가 주어졌을때 숨은 요인 z가 어떻게 나오는지를 알고싶은 것이다. p(z|x))
그런데 p(z|x)의 실제 정답은 복잡한 다봉분포처럼 생겼다.
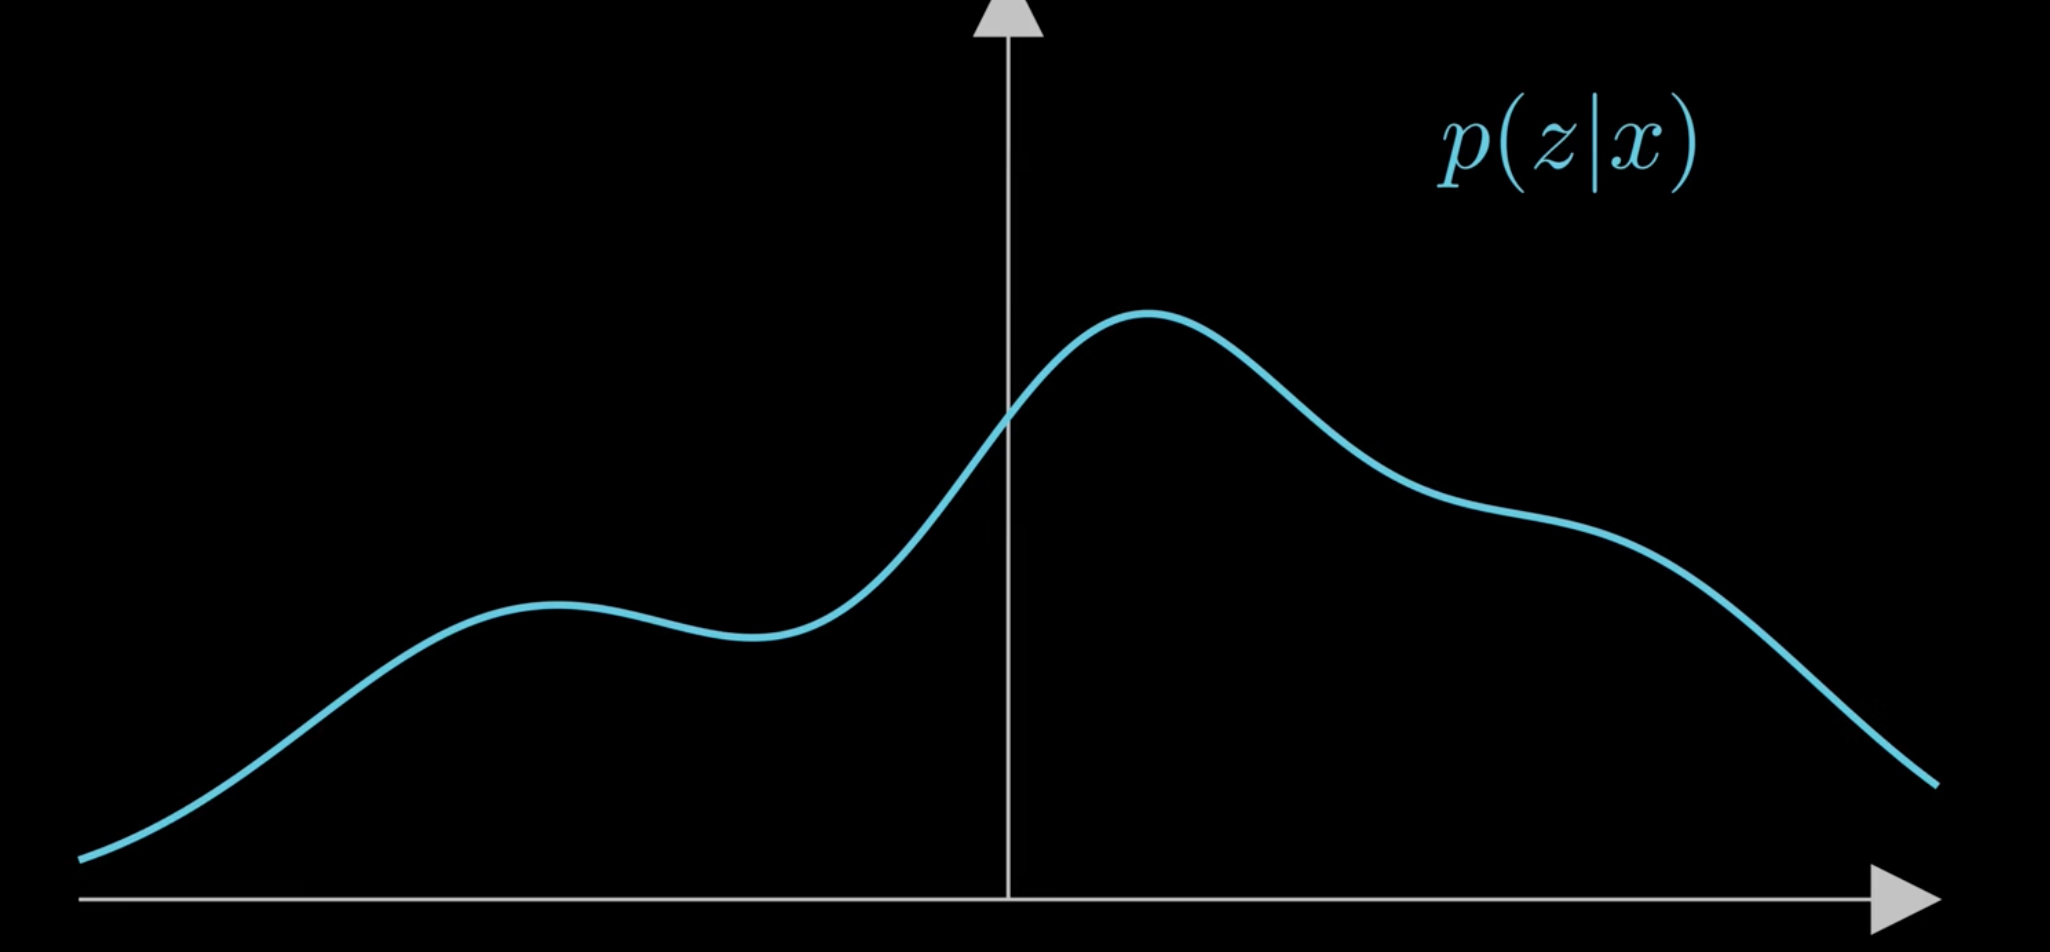
그래서 정확한 분포를 그대로 계산하려면 너무 복잡하다.
이러한 복잡한 분포중에서 중요한 정보를 대부분 담을 수 있는 단순한 분포를 사용할 수 있다면 어떨까? (예 가우시안 분포) 즉 복잡한 분포를 단순한 정규분포로 근사하자는 아이디어이다.
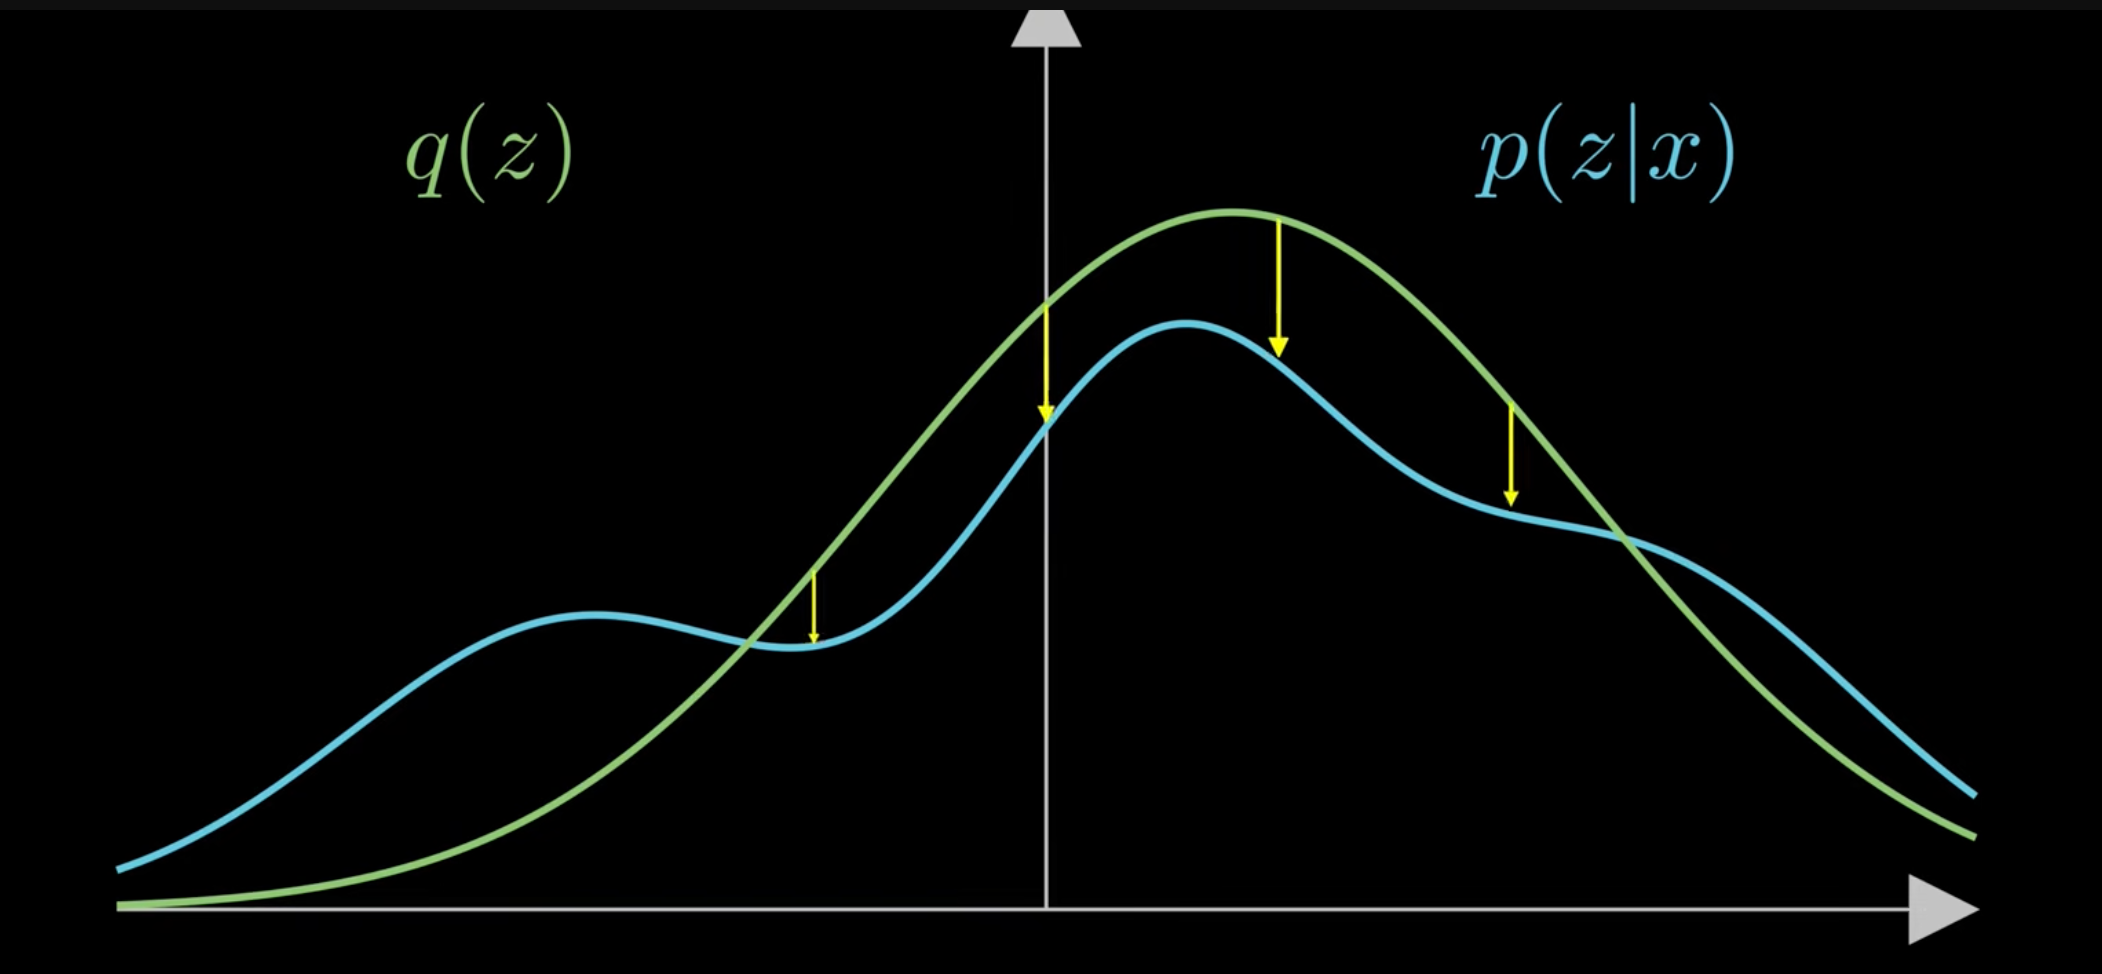
이것이 바로 변분추론(Variational inference)이다.
따라서 핵심은 가능한 가장 좋은 근사분포를 어떻게 찾을 것인가?
이것이 왜 필요한가?
머신러닝과 통계에서는 이미지나 측정값처럼 직접 관측한 데이터를 자주 다루며, 이를 X라고하자
그리고 직접 관측할 수는 없지만 데이터에 영향을 주는 어떤 잠재변수가 있으며, 이를 Z라고 하자
예를 들어 이미지(X)가 데이터라면 잠재 변수는 사진이 찍힌 각도(Z) 등이 있다.
우리의 목표는 사후분포 P(Z|X)를 구하는 것 입니다.
이는 관측된 X가 주어졌을 때 어떤 Z 값들이 그럴듯한지를 알려준다.
즉, 데이터를 보고 그 데이터를 만든 숨은 원인이 무엇일지 추정하는 것이다.
Bayes rule을 써보자
P(Z|X)를 구하기 위해 베이즈 정리에 따르면 다음과 같이 쓸 수 있다.
사후분포 = 우도 × 사전분포 ÷ 증거로 계산된다.
문제는 분모 P(X)이다. 이를 구하려면 잠재변수 Z가 가질 수 있는 모든 차원에 대해 적분해야 하는데
가능한 모든 숨은 원인을 다 고려했더니 z의 차원이 많아지면 이 적분은 현실적으로 계산이 어려워진다.
P(X)를 latent variable z를 이용해 표현하는 이유는, z라는 숨은 원인으로부터 x가 생성된다고 생성 과정을 모델링했기 때문이다.
따라서 베이지안 정리로 부터 p(z|x)를 계산하기가 어렵다.
Variation Inference
정확한 p(z|x)를 계산할 수 없다면 계산하기 쉬운 다른 분포를 하나 만들어서 p(z|x)와 비슷하게 만들자. 라는 변분 추론의 핵심 아이디어가 등장한다.
바로 p(z|x) 사후분포를 직접 계산하는 대신, 실제로 다룰 수 있는 더 단순한 분포 q(z)로 근사합니다. (예를들면 q(z)는 가우시안, 지수분포, 감마분포 처럼 단순한 분포라고 가정한다.)
q(z) 분포를 우리가 선택하면 사후분포에 최대한 가까운 q분포의 파라미터를 찾아야한다. 그러기 위해서는 먼저 q가 어떤 분포인지 선택해야 한다.
예를들어 X가 이미지이고 Z가 촬영각도(우리가 정함)라면 [-무한대, 무한대]의 범위를 설정하면됨으로 정규분포로 선택한다. 즉, z의 서포트를 바탕으로 q분포의 family를 선택하면 된다.
Q 분포가 선택되면 파라미터(ex. \(\mu, \sigma\)) 를 바꿔가면서 정답 사후분포 모양과 최대한 유사하게 만든다.
이를 수학적으로 formulation 하면 Q 확률분포와 정답 사후 분포가 얼마나 가까운지 측정가능한 KL divergence를 사용하고 이 값을 최소화하면 된다.
그러면 KL divergence를 직접 계산해서 최소화해보자.
계산하려 봤더니 여저닣 구하기 어려운 정답 사후분포인 P(Z|X)가 필요하다.
이를 베이지안 룰을 사용하면
ELBO(Evidence Lower Bound)
여기서 대괄호 부분을 아래와 같이 정의하고 이것을 ELBO라고 한다.
ELBO라고 부르는 이유는
처럼 되서 ELBO는 p(x)의 Lower bound의 조건이 된다고 해서 지어진 이름이다.
식을 다시 써보면
라 쓸 수 있다.
위 식에서 q를 바꾼다고 해보자.
그러면 좌항에 q가 들어있으니 바뀔 것이고 ELBO도 q를 포함하고 있으니 값이 바뀔 것이다.
하지만 \(\log p(x)\)는 바뀌지 않는다( \(p(x) = \int p(x|z)p(z)dz\) 임으로 q가 포함되어있지 않음)
따라서 q의 파라미터를 업데이트해 나아가면서 좌항의 KL을 최소하하고 싶다면 ELBO를 최대화하면 된다!
첫 번째 항 의미
에서 첫 번째 항을 봐보면 q(z)에서 어떤 z를 뽑았다고 해보자.
그러면 그 z가 주어졌을 때 현재 관측된 데이터 x가 나타날 가능성은 p(x|z)가 된다. 따라서
가 크다는 것은 현재 선택한 z관측 데이터 x를 잘 설명한다는 것이다.
예를 들어 현재 x가 숫자 6 이미지라고 해보자.
우리가 q(z)에서 어떤 z를 뽑았는데, 이 z로부터 숫자 6과 매우 비슷한 이미지를 생성할 수 있다면
p(x|z)는 큰 값을 가지게 된다. 반대로 z를 이용했더니 숫자 6과 전혀 다른 이미지가 생성된다면 p(x|z)는 작아진다.
따라서 첫 번째항의 역할은 q(z)가 실제 데이터 x를 잘 설명할 수 있는 z에 높은 확률을 주도록 만드는 것이다.
기댓값이 붙는 이유는 하나의 z에 대해서만 평가하는 것이 아니라 z ~ q(z)에서 나올 수 있는 여러 z에 대해 평균적으로 p(x|z)가 얼마나 높은지 보는 것이다.
두 번째 항 의미
\(p(z)\)는 잠재변수 z에 대한 prior distribution이다. 따라서 q(z)분포 처럼 우리가 z의 support를 바탕으로 z의 분포를 결정해주면된다.
베이지안 추정에서는 likelihood와 conjugate 관계에 있는 사전분포를 선택하면 posterior 계산이 쉬워진다. 하지만 항상 conjugate prior를 써야 하는 것은 아니다.
일반적으로 계산이 쉽고 해석이 편한 표준정규분포로 z~N(0, 1)를 많이 사용한다.
x를 잘 설명하는 것은 좋은데, 우리가 미리 정한 사전분포 p(z)에서 너무 멀리 벗어나지 못하게 하는 항이다.(우리가 정한 사전분포(믿음)에서 너무 크게 벗어나지 않도록 어느정도 영향을 받는다.)
따라서 ELBO를 최대화 하기 위해서는 첫 번째 항은 크게 하고 두 번째 KL은 작게 만들어야 한다.
따라서 L(q)를 가장 크게 만드는 q를 찾으면(q를 가우시안 분포로 가정하면) 초기에는
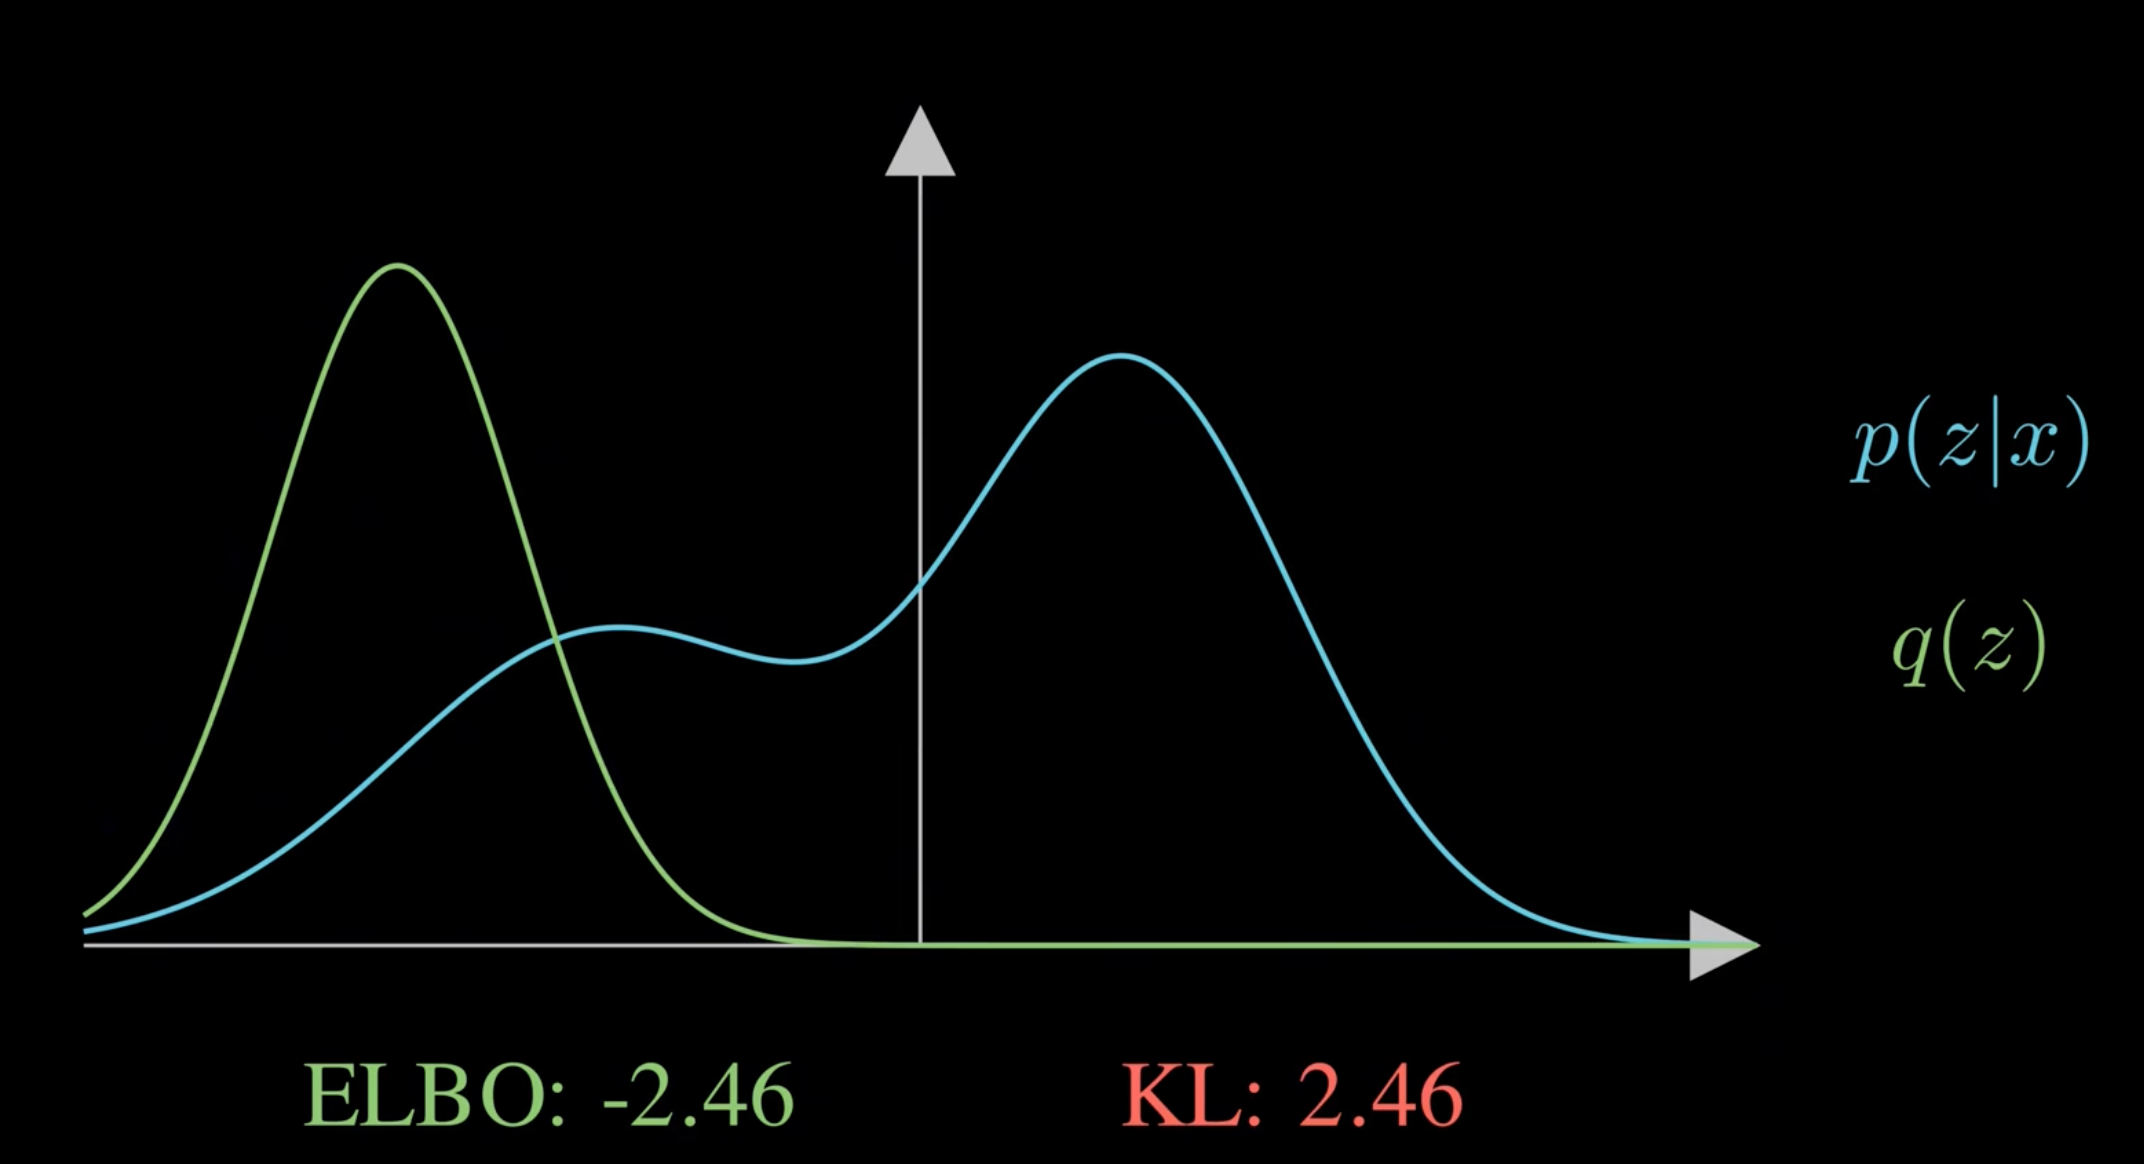
에서 KL을 줄여갈 수록
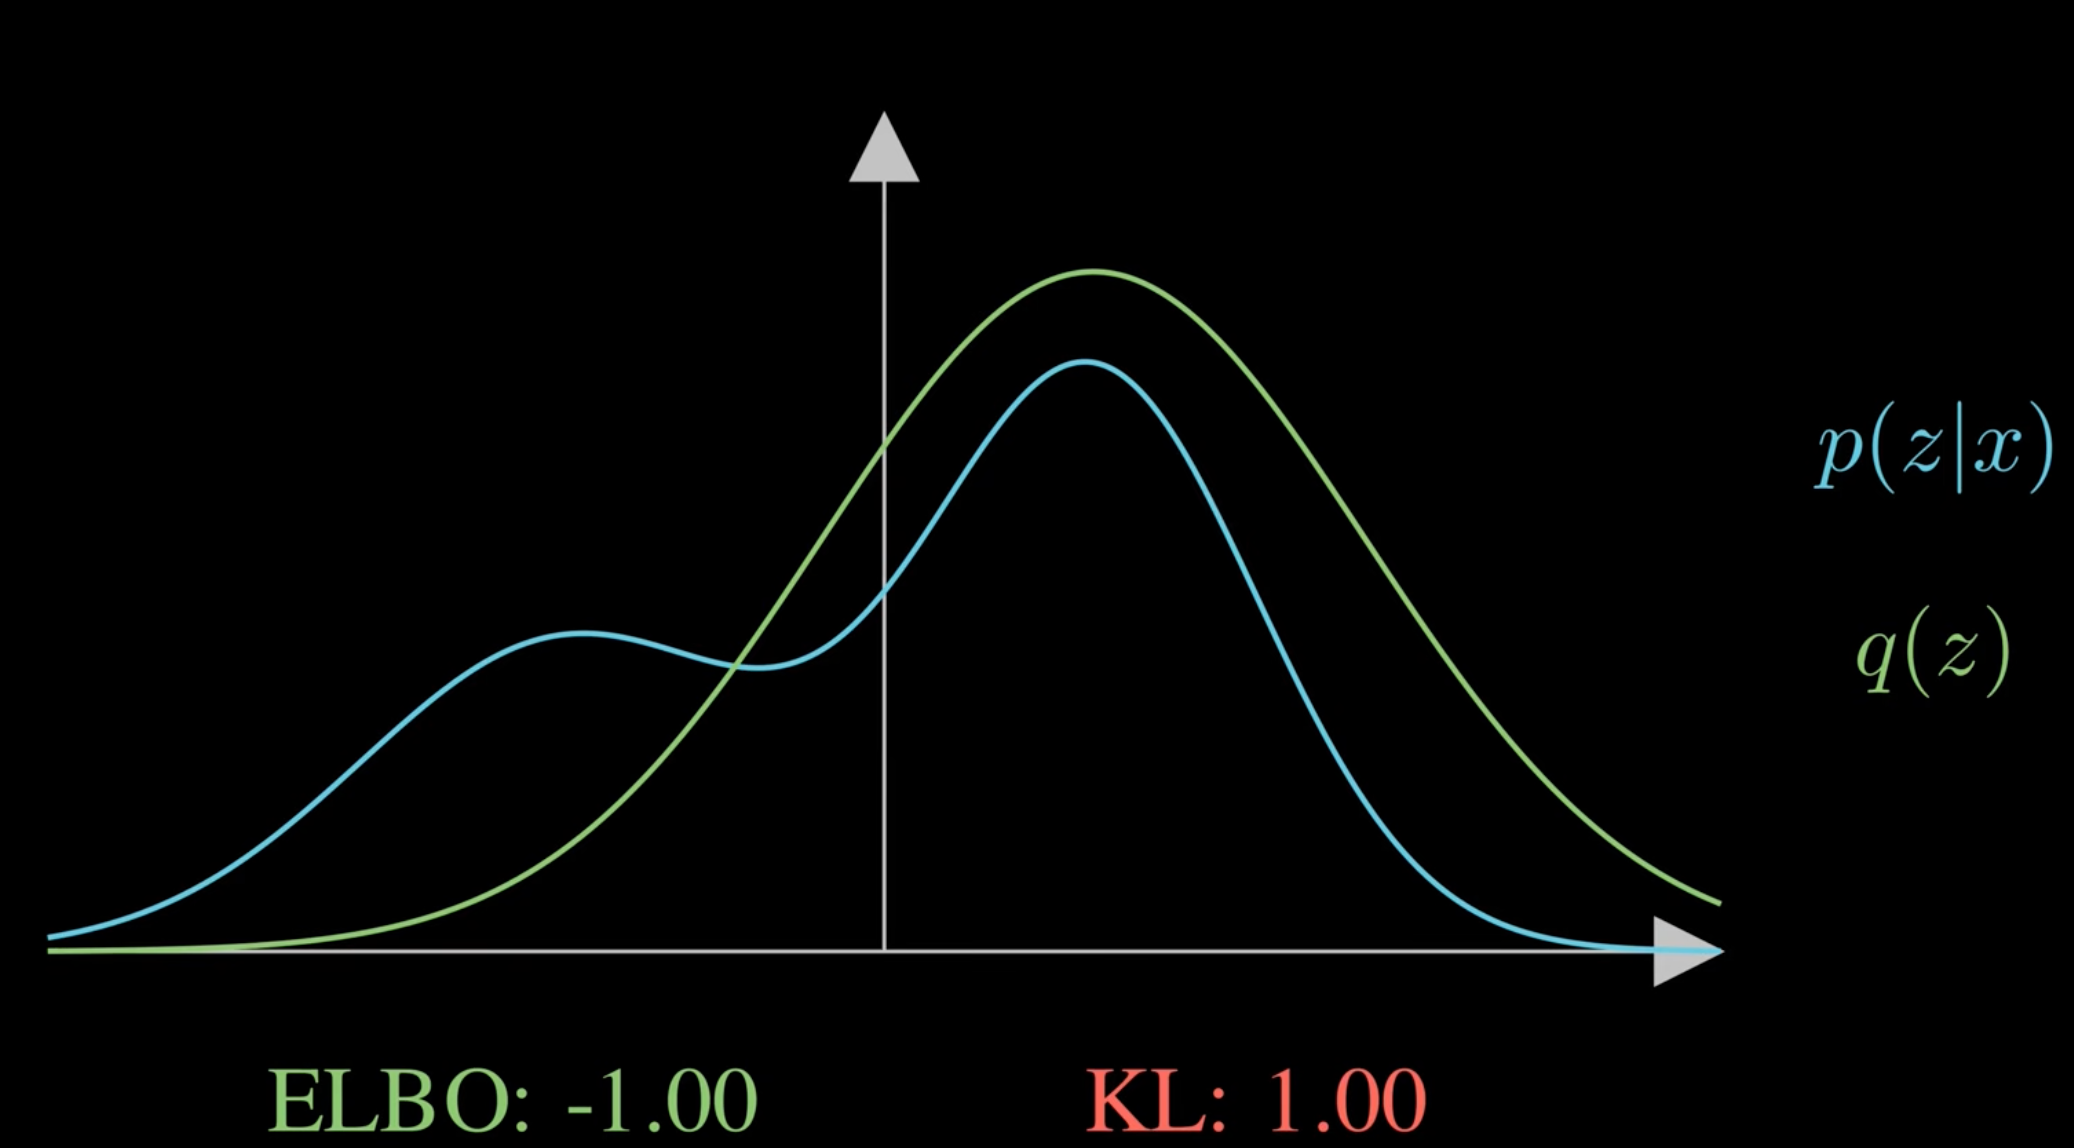
가 된다.
[reference]
Comment