
서론
학습도중
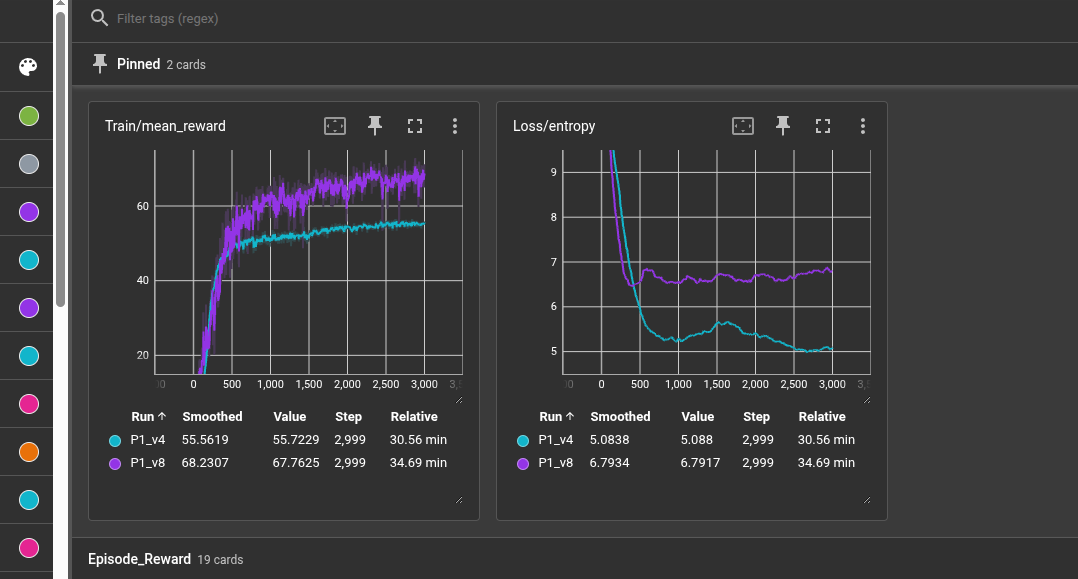
P1_v8(보라색) 그래프의 개형이 Reward는 상승하는데 Entropy가 감소하지 않는 것이 어떻게 발생하는지에 대해서 알아본다.
본론
\( L^{CLIP} = \mathbb E_t \left[ \min \left( r_tA_t,\; \operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A_t \right) \right] \)
여기서 가장 중요한 정의가 \(\boxed{ r_t = \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{\rm old}}(a_t|s_t)} }\) 이다.
즉, \(r_t>1\) 이면 \(\pi_\theta(a_t|s_t)> \pi_{\rm old}(a_t|s_t)\) 이므로 현재 policy가 그 action의 확률을 높인 것이고,
\(r_t<1\) 이면 그 action의 확률을 낮춘 것이다.
PPO에서는 목적함수를 최대화하는 것임으로 \(r_tA_t\)를 최대화 하려고 한다.
\(A_t\)는 현재 했던 행동이 평균적으로 좋았는가를 양수와 음수를 통해서 나타낸다
따라서 \(+\)였다면 현재 행동이 좋은 행동임으로 \(r_t\)를 키워야함으로 \(\pi_\theta(a_t|s_t)\)를 키우려고 한다.
반대로 \(-\)였다면 현재 행동이 나쁜 행동임으로 \(r_t\)를 줄여야함으로 \(\pi_\theta(a_t|s_t)\)를 작게 만들려고 한다.
이제 예를통해 알아본다.
Example
어떤 상태 \(s_t\)가 들어왔을 때 policy가 action 하나를 딱 정해서 내는 것이 아니라,
\(a_t\sim\mathcal N(\mu_t,\sigma_t^2)\) 라고 하자.
예를 들어 현재 policy가 \(\mu=0,\; \sigma=1\) 라면 이 파라미터를 갖는 가우시안 분포에서 action을 뽑는다.
대부분 0 근처가 나오지만 가끔 1.5, 2 같은 값도 나올 수 있다.
그런데 우연히 a=2가 나왔는데 리워드가 좋아졌다고 하자. (이 경우 \(A_t > 0\)) 이다.
그러면 PPO는 \(a=2\)라는 행동 괜찮네 이 action이 나올 확률을 높여야겠다. 라고 생각한다.
그러면 Gaussian에서 \(a=2\) 확률을 어떻게 높일까?
방법 1. 평균 \(\mu\)를 오른쪽으로 이동
가우시안 정책을 \(a\sim \mathcal N(\mu,\sigma^2)\) 라고 하면, action \(a\)의 확률밀도는 \(\pi(a) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left( -\frac{(a-\mu)^2}{2\sigma^2} \right)\)
PPO에서는 Gaussian loglikelihood를 사용함으로 양변에 로그를 취함.
\(\mu\)를 변화시켰을 때 action a의 log-probability가 최대가 되도록 하기 위해 어느방향으로 이동해야하는지 미분한다.
\( \frac{\partial \log\pi}{\partial\mu} = \frac{\partial}{\partial\mu} \left[ -\frac{(a-\mu)^2}{2\sigma^2} \right]\) 가 되고 최종적으로 \( \frac{\partial\log\pi}{\partial\mu} = \frac{a-\mu}{\sigma^2} \) 가 나온다. 여기서 a=2이고 \(\mu=0\)이였음으로
\( \frac{\partial\log\pi}{\partial\mu} = \frac{2-0}{1^2} = 2\) 이 의미는 \(\mu\) 를 조금 변화시켰을 때 a가 나올 확률밀도가 2\(d\mu\) 만큼 커진다.
예를 들어 \(\mu:0\rightarrow0.01 \) 만큼 움직이면 \(d\mu =0.01 \) 이므로 \( 2(0.01)=0.02 \) 만큼 a=2일 log-probability가 증가한다.
반대로 \(a=-2\)가 좋은 action이었다고 하자.
\(\mu=0,\quad a=-2\) 이면 \(\frac{\partial\log\pi}{\partial\mu} = \frac{-2-0}{1^2} =-2 \) 이므로
기울기가 음수이므로 \(\mu\downarrow\) 즉 평균을 왼쪽으로 움직이면 \(a=-2\)의 확률이 증가한다.
그래서 식 \(\frac{\partial\log\pi}{\partial\mu}= \frac{a-\mu}{\sigma^2}\) 는 평균 \(\mu\)에서 action이 어느 방향(오른쪽, 왼쪽)에 있는가?를 나타낸다.
\( L^{CLIP} = \mathbb E_t \left[ \min \left( r_tA_t,\; \operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A_t \right) \right] \) 에서 \( \)\(r_t = \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{\rm old}}(a_t|s_t)} \) 인데 분모는 상수.
우리는 파라미터 \(\mu\)를 조정해서 \(\pi_\theta(a_t|s_t)\)의 확률을 키우거나/낮추거나 해야한다.
a는 가우시안 분포를 따름으로 확률밀도를 \(\mu\)에 대해서 미분하면 \( \frac{\partial\log\pi}{\partial\mu} = \frac{a-\mu}{\sigma^2} \) 였다.
\(A_t > 0\) 이면 \(\pi_\theta(a_t|s_t)\)의 확률을 키워야하고 \(A_t < 0\) 이면 \(\pi_\theta(a_t|s_t) \)를 작게 만들어야 한다.
\( L^{CLIP} = \mathbb E_t \left[ \min \left( r_tA_t,\; \operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A_t \right) \right] \)
\(A_t\)는 \( \nabla_\theta J = E\left[ A_t\nabla_\theta\log\pi_\theta(a_t|s_t) \right] \) 로 쓸 수 있고 \(\nabla_\theta J=E\left[A_t\frac{a-\mu}{\sigma^2}\right]\) 로 쓸 수 있다.
- \(a=2\)를 했더니 \(A_t > 0\) 인 경우 (Action이 좋았음)
- \(\mu\) —— a 에 위치한 경우
- \(\frac{a-\mu}{\sigma^2} > 0\)
- \(A_t > 0\)
- \(\mu\) → \(a\)방향으로
- \(\mu\) —— a 에 위치한 경우
- \(a=2\)를 했더니 \(A_t < 0\) 인 경우 (Action이 나쁨)
- \(\mu\) —— a 에 위치한 경우
- \(\frac{a-\mu}{\sigma^2} > 0\)
- \(A_t < 0\)
- \(\mu\) → \(-a\)방향으로 오히려 평균을 a의 방향과 멀어지도록 함
- \(\mu\) —— a 에 위치한 경우
방법 2. \(\sigma\)로 \(a=2\)의 확률을 바꿀 수 있다.
Case 1
현재 분포가 아주 좁다고 해보자.
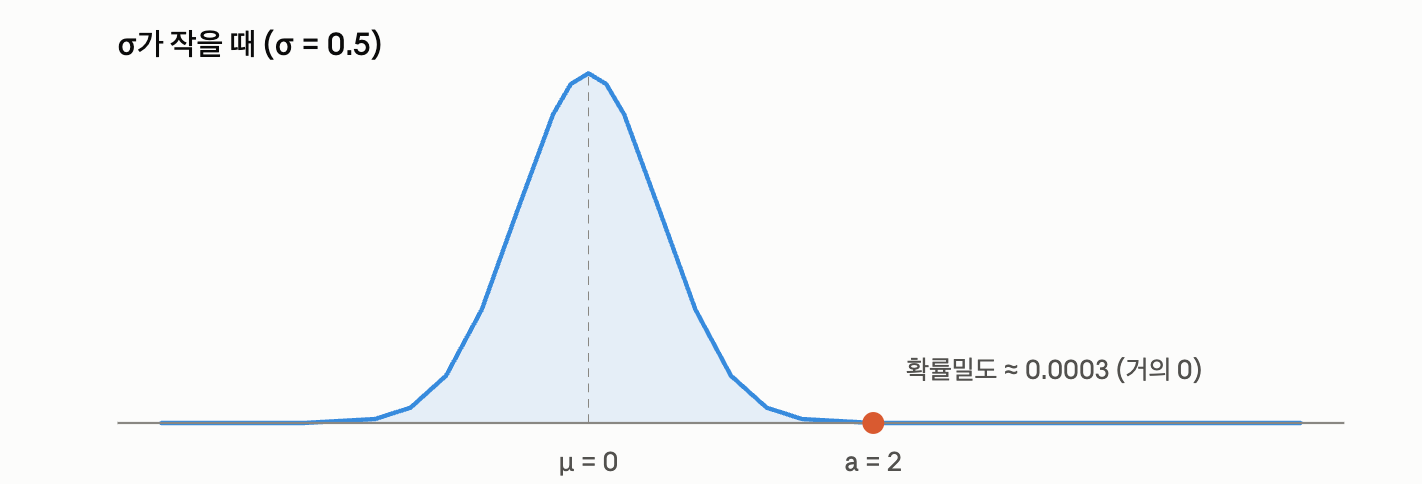
그런데 \(\sigma\)를 키우면?
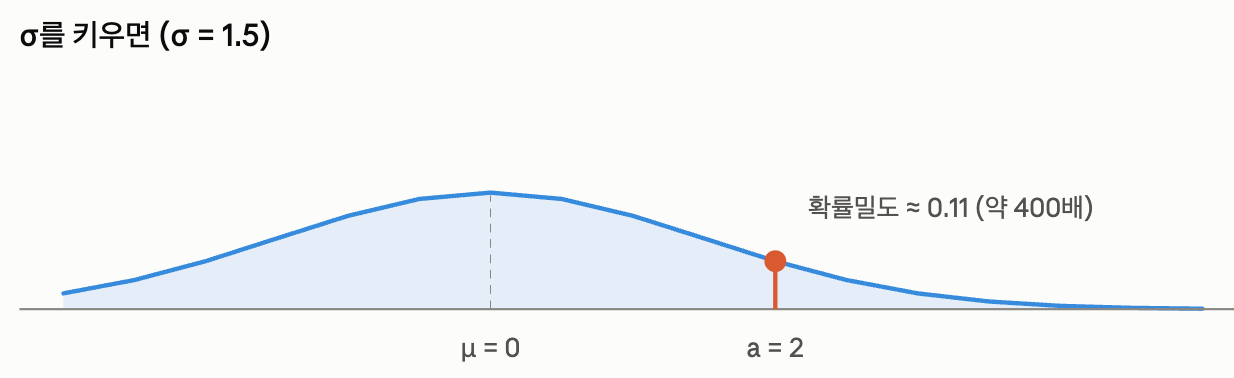
따라서 분산을 키우면 \(a=2\)가 나올 확률이 커진다.
Case 2
반대로 좋은 action이 이미 평균 바로 근처에 있다?
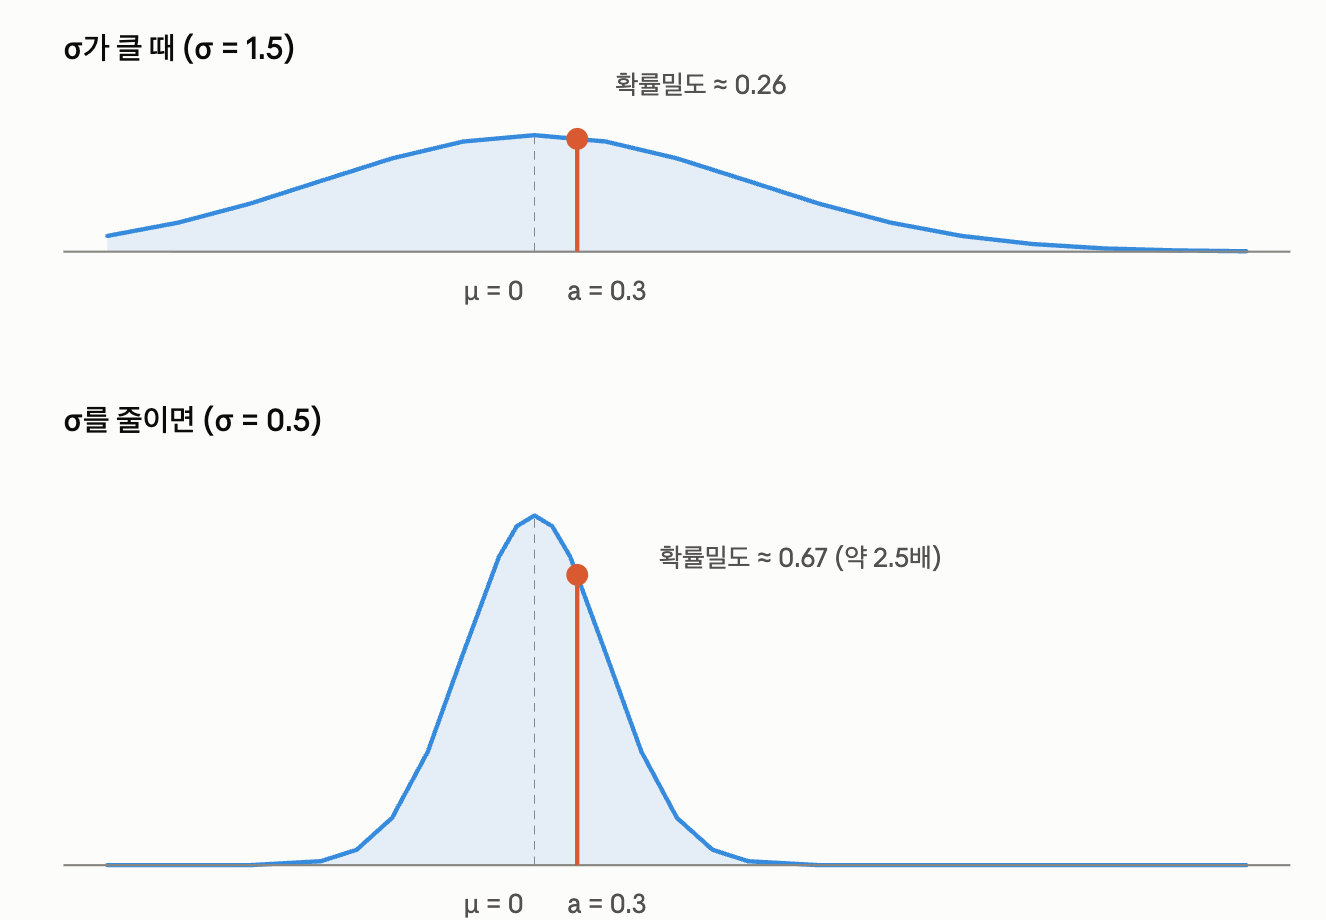
따라서
직접 미분
Gaussian 확률밀도는 다음과 같았다: \( \log\pi(a|s) = -\frac12 \left[ \frac{(a-\mu)^2}{\sigma^2} + 2\log\sigma + \log(2\pi) \right] \)
\(\sigma\)를 조금 바꾸면 이 action의 log probability가 증가하나 감소하나? 를 보기위해 \(\sigma\)로 미분하면
\( \frac{\partial\log\pi} {\partial\log\sigma} = \frac{(a-\mu)^2}{\sigma^2}-1 \) 가 나온다.
\( z = \frac{a-\mu}{\sigma} \) 로 두면 이 식은 \(z\)는 action이 평균에서 몇 \(\sigma\)만큼 떨어졌는가를 의미한다.
- Action이 평균에서 2σ 떨어져 있음
예를 들어 \(\mu=0,\quad\sigma=1,\quad a=2\) 이면 \(z=\frac{2-0}{1}=2\) 따라서 \(z^2-1 = 4 - 1 = 3\)
\(\frac{\partial\log\pi}{\partial\log\sigma}=3>0\) 이므로 만약 \(a=2\)가 좋았다면(\(A_t > 0)\)이라면 gradient는 \(\sigma\)를 키워 \(a=2\) 가 나올 확률을 키우는 방향으로 움직인다.
2. 이번에는 좋은 action이 평균 바로 옆이라고 해보자
\(\mu=0,\quad\sigma=1,\quad a=0.2\) 이면 \(z=0.2\) 이다.
따라서 \(z^2-1 = 0.04-1 = -0.96.\)
즉 \(\frac{\partial\log\pi}{\partial\log\sigma}<0\) 이 action이 좋았다면 \(A_t>0\) 이므로 \(A_t \cdot (-0.96)<0\) 가 되서
gradient가 \(\log\sigma\downarrow\) 를 낮춰 \(a=2\)가 나올 확률을 키운다.
이는 좋은 action이 이미 평균 근처에 있으니 굳이 넓게 탐색할 필요가 없다.
“지금 평균 주변이 좋구나. 그러면 이 주변에 더 집중하자.”
로 해석된다.
따라서 단, 이것은 \(A_t>0\) 인 좋은 action일때
대략적으로 \(|a-\mu|>\sigma\) 라면 \(\sigma\)를 키우는 방향이고, \(|a-\mu|<\sigma\) 라면 \(\sigma\)를 줄이는 방향이다.
자 그럼 왜 리워드는 올라가는데 \(\sigma\)를 담당하는 entropy는 감소하지 않는지 봐보자.
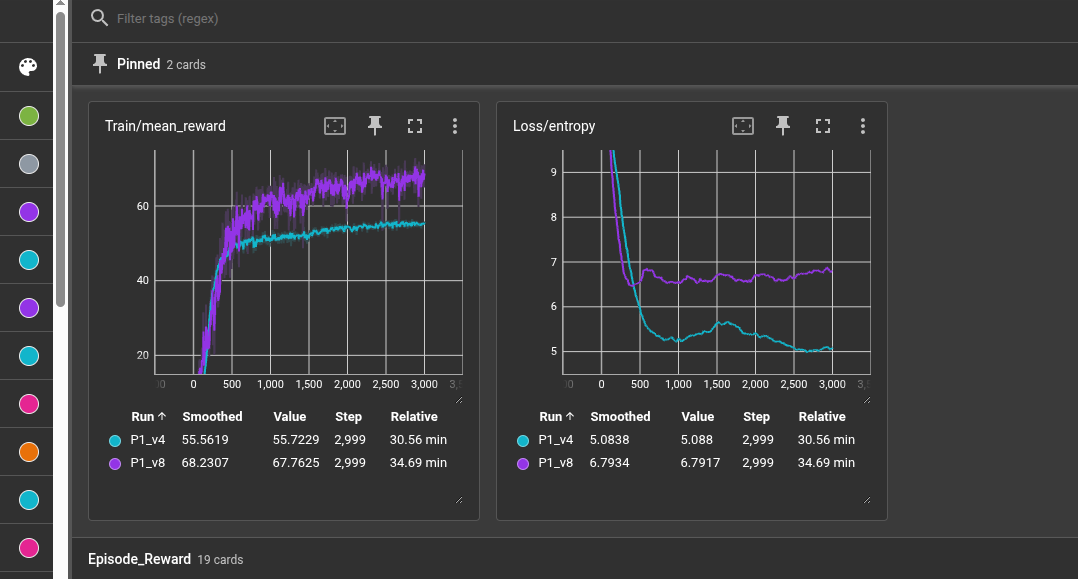
Policy gradient를 봐보면 \(\sigma\uparrow\) 시키려는 sample과 \(\sigma\downarrow\) 시키려는 sample이 계속 존재한다.
- \(\pi(a_t|s_t= \text{walk1})\) walk1상태에서는 \(a_t\)가 높은 리워드를 받아 좋은 상태. 근데 평균과 \(a_t\)가 멀리 있음
- 따라서 평균을 이동시키며 분산도 키움 그래서 인트로피가 증가
- \(\pi(a_t|s_t= \text{walk2})\) walk2상태에서는 \(a_t\)가 좋은 리워드를 받았는데 평균과 \(a_t\)가 가까이 있음 따라서 분산을 줄임 그래서 엔트로피가 감소
\(A_t>0\), 즉 좋은 action을 뽑은 경우에도 두 가지가 동시에 존재함.
분산을 키워좋은 액션이나올 확률을 키움 \(|a_t-\mu_t|>\sigma_t\) 라면 \(\frac{(a_t-\mu_t)^2}{\sigma_t^2}-1>0\)
이므로 \(\sigma\uparrow\) 방향의 gradient가 생김
반대로 \(|a_t-\mu_t|<\sigma_t\) 라면 \(\frac{(a_t-\mu_t)^2}{\sigma_t^2}-1<0\) 이므로 \(\sigma\downarrow\) 방향의 gradient가 생김.
Conculsion
Reward는 계속 증가하고 있지만, 모든 관절에서 \(\sigma\)가 동시에 감소할 필요는 없다. 어떤 상태·관절에서는 평균에서 멀리 떨어진 좋은 action 때문에 \(\sigma\)를 증가시키는 gradient가 발생하고, 다른 상태·관절에서는 평균 근처의 좋은 action 때문에 \(\sigma\)를 감소시키는 gradient가 발생한다. 이러한 gradient들이 전체 batch와 12개의 action dimension에 걸쳐 서로 균형을 이루면, policy의 평균 \(\mu\)는 계속 개선되어 reward가 상승하면서도 전체 entropy는 일정한 수준에 머물 수 있다.
- 위 말이 성립하려면 엔트로피 보너스가 영향을 미치지 않는다에 가정한다.
그런데 초록색 P1_v4는 리워드 그래프의 기울기가 보라색 그래프보다 낮으며 상승폭이 매우 느슨하면서 엔트로피는 매우 감소한 상태임으로 이는 어떤 특정분포에 수렴했다고 해석할 수 있다.
Comment