
서론
PFD는 “미래 영상을 예측하도록 학습시키는 것이 실제 행동 성능에 왜 도움이 되는가?”라는 질문에서 출발한다.
학습할 때 World Action Model은 보통 두 가지를 같이 학습한다.
- 현재 장면을 보고 로봇 action 예측
- 현재 장면을 보고 미래 영상 예측
그런데 최근 연구에서 학습이 끝난 뒤 실제 로봇을 움직이는 추론 단계에서 미래 영상을 예측하는 branch를 제거해도 성능이 거의 떨어지지 않았다.
그래서 기존에는 미래 영상 예측이 실제 action 결정에 직접 필요한 것이 아니라, 학습 과정에서 visual backbone이 더 좋은 feature를 배우도록 도와주는 보조적인 regularizer 역할을 한 것 아닐까?라는 해석이 제기되었다.
- 보조적인 regularizer: 모델이 한 가지 목표에만 과하게 맞춰지지 않고, 더 좋은 특징을 배우도록 옆에서 도와주는 추가 학습 신호입니다.
하지만 PFD는 이에 대해, 미래 정보가 단순히 backbone을 잘 학습시키는 보조 역할만 하는 것이 아니라,
미래를 보았기 때문에 action을 어떻게 수정해야 하는지에 대한 실제 행동 보정 정보(action correction)가 생긴다고 주장한다.
Introtuction
Teacher는 현재 장면뿐 아니라 실제 미래 장면이라는 특권정보(privileged information)까지 볼 수 있기 때문에, 현재 장면만 보는 Student보다 더 정확한 행동 방향을 예측할 수 있다.
PFD의 핵심은 Teacher의 행동을 그대로 Student가 따라 하도록 만드는 것이 아니라, 미래 정보를 보았을 때와 보지 않았을 때의 행동 예측 차이(residual)를 계산하여 Student에게 학습시키는 것이다.
예를 들어 현재 장면만 본 모델이 “오른쪽으로 5만큼 움직여야 한다”고 예측하고, 미래 장면까지 본 Teacher가 “오른쪽으로 7만큼 움직여야 한다”고 예측했다고 하자. 이때
7−5=27-5=2
라는 차이가 바로 미래 정보가 제공한 행동 보정량(residual correction)이다.
PFD는 이 보정량을 Student에게 증류한다. 따라서 실제 추론 시 Student는 미래 영상을 볼 수 없지만, 학습 과정에서 “현재 상황이 이러할 때 행동을 어느 방향으로 얼마나 보정해야 하는가”라는 패턴을 학습할 수 있다.
구조적으로 Teacher와 Student는 동일한 backbone을 사용하며, 차이는 video token에 적용되는 attention mask이다. Teacher는 mask를 통해 현재 영상과 미래 영상을 모두 볼 수 있지만, Student는 현재 영상만 볼 수 있다.
따라서 PFD의 핵심 주장은, 미래 예측을 이용한 보조 학습의 효과가 단순히 visual backbone을 더 잘 학습시키는 regularization에만 있는 것이 아니라, 미래 정보가 제공하는 action-relevant correction을 Student에게 전달하기 때문에 성능이 향상된다는 것이다. 저자들은 이를 통제 실험을 통해 검증하였다.
Method
Student와 Teacher는 같은 backbone을 쓰지만, 볼 수 있는 정보의 범위만 다르다
Student의 action token은 현재 프레임의 video token과 action token만 참조하며, 이는 Fast-WAM의 현재 프레임 기반 inference 방식과 동일하다.
- 현재 영상만 보고 action을 결정
반면 Teacher의 action token은 학습 중에만 사용할 수 있는 실제 미래 프레임을 포함하여 모든 video token을 참조한다.
- Teacher는 \(X_1, X_2, X_3, ...\)
를 모두 볼 수 있어서 Student보다 더 많은 정보를 가지고 있다.
학습 중 같은 MoT backbone에 두 종류의 mask를 적용하여 Student의 \(v_{\text{base}}\)와 stop-gradient된 Teacher의 \(v_{\text{teacher}}\) 를 얻는다.
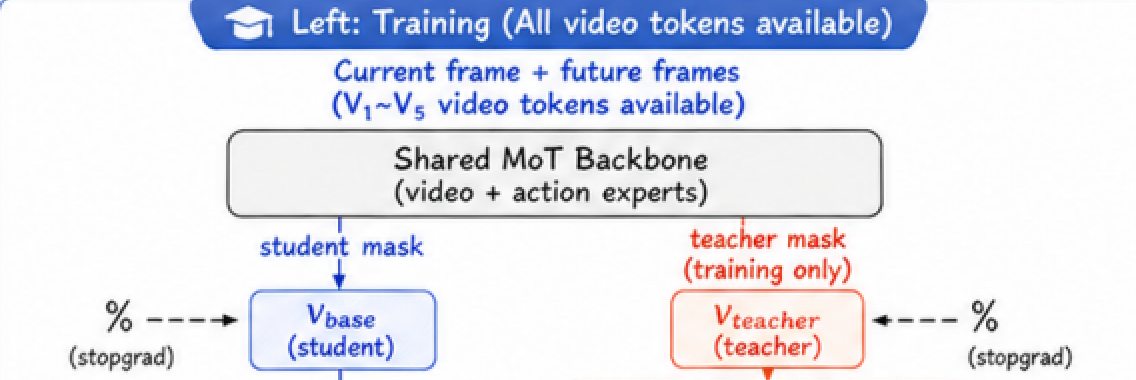
분리된 residual target \(r=\operatorname{sg}(v_{\text{teacher}}-v_{\text{base}})\)은 미래 정보를 봄으로써 생긴 action-denoising 보정량으로 미래를 보면 stduent의 행동 예측을 얼마나 보정해야 하는가를 계산한 GT 값이다.
이고 \(v_{\text{base}} = 0.4,\;\;v_{\text{teacher}} = 0.7 \) 이이라면 \(\delta = 0.3\) 임으로 미래 정보 때문에 +0.3 만큼 행동 예측이 바뀐 것
이를 예측하기 위해 작은 adapter를 학습시킨다.
작은 adapter \(g_\phi\)는 \(v_{\text{base}}\) 를 입력으로 받아 residual \(\delta\) 을 맞추기 위한 \(\hat{\delta}\)를 예측한다.
즉, Student가 미래 영상을 직접 볼 수 없으므로 미래를 봤다면 생겼을 보정량”을 adapter가 예측하도록 학습하여
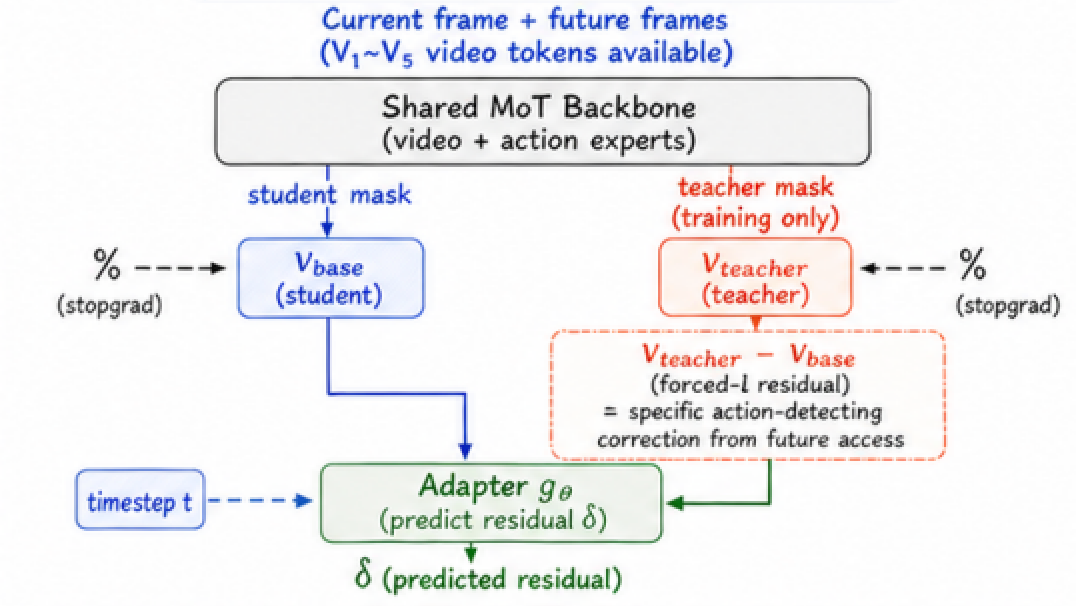
최종적으로 \(v_{\text{final}}=v_{\text{base}}+\hat{\delta}\) 를 만든다.
inference 시 Teacher 경로와 미래 video token은 모두 제거하여 Student mask(입력)만 사용하고 adapter의 correction을 적용한다.
PFD의 핵심 철학은 Future 자체를 배우지 말고, Future(특권정보)가 Action을 얼마나 수정했는지를 배우자
Loss
현재 장면을 조건으로 주었을 때, noise가 섞인 미래 영상 latent를 실제 미래 영상 쪽으로 복원하는 방법을 Video backbone이 배우게 하는 Loss
최종 action prediction \(v_{\text{final}}\)이 실제 action flow target \(v_{\text{target}}\)과 가까워지도록 학습한다.
Adapter가 에측한 residual \(\hat \delta\)가 Teacher로부터 얻은 residual target \(r\)과 가까워지도록 학습한다.
Student의 최종 prediction \(v_{\text{final}}\)이 Teacher prediction \(v_{\text{teacher}}\)과 가까워지도록 하는 loss이다.
전체 PFD loss는 다음 네 loss의 weighted sum이다
L_gt: 실제 데이터의 정답에서 벗어나지 않게 anchorL_teacher: future를 본 Teacher가 알아낸 foresight 방향을 Student에게 전달
Limitation
PFD는
- Future를 어떻게 전달할까?
에서
- Future가 action에 만든 correction을 전달하자.
이렇게 feature를 직접 복원하는 대신 이 residual을 Student의 adapter에 학습한다.
이를 제안한 논문에서는
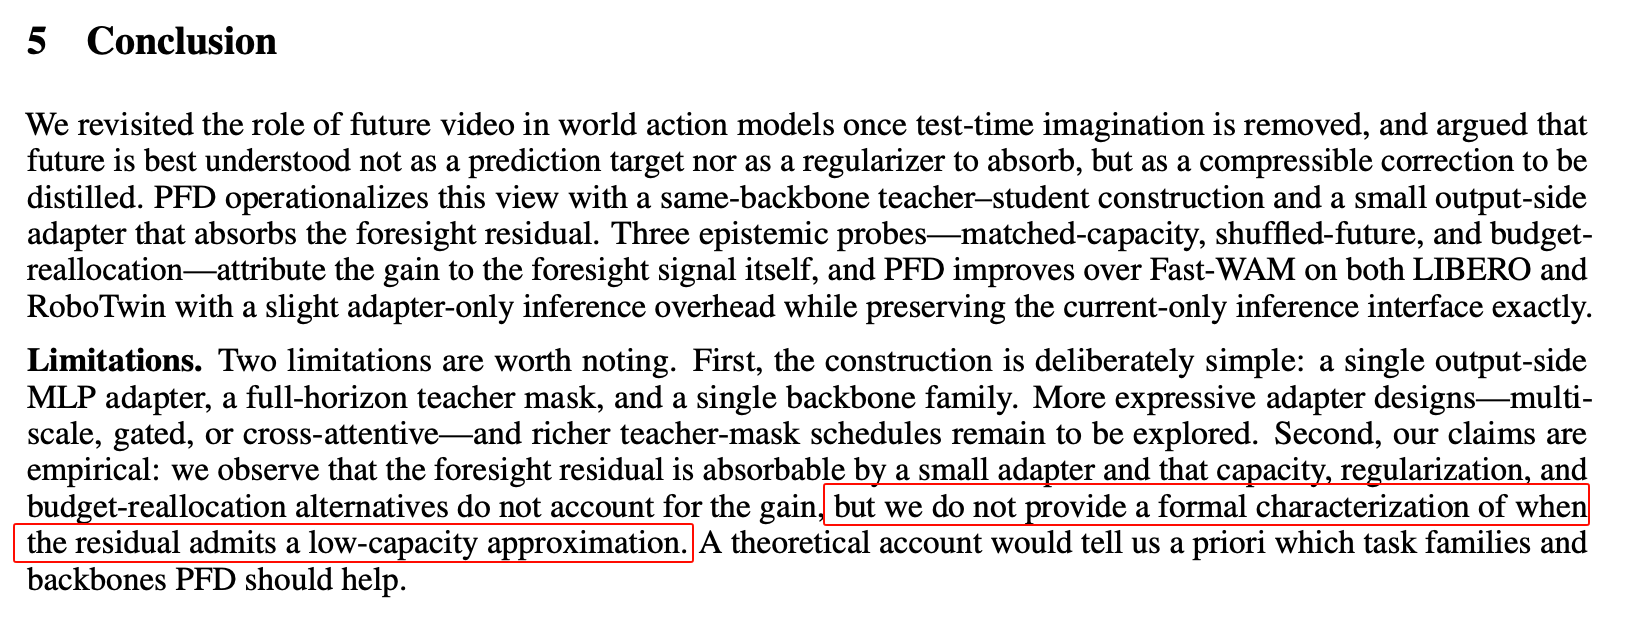
한계를 “실험에서는 small adapter가 residual을 잘 absorb하는 것을 보였으나 어떤 조건에서 residual이 small adapter로 근사 가능한지는 모른다.”
이에 생각해볼 질문은
- 그 correction \(r^F_t\) 중 history(\(H_t \))로 예측 가능한 residual과 예측 불가능한 residual을 분석해보자.
- 그리고 예측 가능한 경우에만 골라서 distilation하자.
로 나가볼 수 있다.
Comment