서론
이 장에선는 Jacobian이 다루는 함수 구조에 대해서 자세히 알아본다.
Jacobian shape
다변수 벡터 함수 \(f: \mathbb{R}^n \to \mathbb{R}^m\) 은 \(n\times1\) 차원의 실수 성분을 입력받아 \(m\times1\)개의 실수 성분을 출력하는 구조를 가진다. 따라서 Jacobian은 n차원 입력 변화 벡터를 받아 m차원 출력 변화 벡터를 만들어야 합니다.
행렬곱의 크기를 맞추면 \((𝑚×𝑛)(𝑛×1)=𝑚×1\) 이 되므로 Jacobian의 Shape은 ‘출력 차원 x 입력 차원’ 이라 할 수 있다.
component function
다음과 같은 함수가 있다고 해보자.
\[\mathbf{f}(x_1, x_2) = \begin{bmatrix} x_1 + x_2 \\ x_1 x_2 \\ x_1^2 - x_2 \end{bmatrix}\]
출력 벡터의 각 성분을 만들어내는 함수를 따로 이름을 붙이면
\[\begin{align}
f_1(x_1, x_2) &= x_1 + x_2 \\[0.2em]f_2(x_1, x_2) &= x_1 x_2 \\[0.2em]f_3(x_1, x_2) &= x_1^2 - x_2 \end{align}\]
이러한 \(f_1,\;f_2,\;f_3\)을 Component Functions, 즉 성분함수라고 한다. 벡터값 함수는 각 성분함수의 출력을 하나의 벡터로 묶어 표현할 수 있다.
여기서 각 성분함수는 같은 입력 벡터 전체를 받는다. 한 출력만 살펴본다고 해서 입력 변수가 하나로 줄어드는 것이 아니다.
\[f_1: \mathbb{R}^2 \to \mathbb{R}, \quad f_2: \mathbb{R}^2 \to \mathbb{R}, \quad f_3: \mathbb{R}^2 \to \mathbb{R}\]
그렇다면, 우리는 각 성분함수의 Gradient가 Jacobian의 한 행(row)이 됨을 알 수 있다.
각 \(f_i\)는 실수값 함수이므로, 입력에 대한 Gradient는 아래와 같다.
\[\nabla f_i(\mathbf{x}) = \begin{bmatrix} \frac{\partial f_i}{\partial x_1} \\[0.5em] \frac{\partial f_i}{\partial x_2} \\[0.5em] \vdots \\[0.5em] \frac{\partial f_i}{\partial x_n} \end{bmatrix}\]
이 Gradient는 “i번째 출력 하나가 각 입력 방향의 변화에 어떻게 반응하는가?”를 나타내고 이를 전치(transpose)하여 행벡터로 만들고 출력 순서대로 쌓으면,
\[J_{\mathbf{f}}(\mathbf{x}) = \begin{bmatrix} \nabla f_1(\mathbf{x})^T \\ \nabla f_2(\mathbf{x})^T \\ \vdots \\ \nabla f_m(\mathbf{x})^T \end{bmatrix}\]
예를 들어 각 Gradient가 다음과 같다면 자코비안은 다음과 같이 표현된다.
\[\nabla f_1 = \begin{bmatrix} 1 \\ 1 \end{bmatrix}, \quad \nabla f_2 = \begin{bmatrix} x_2 \\ x_1 \end{bmatrix}, \quad \nabla f_3 = \begin{bmatrix} 2x_1 \\ -1 \end{bmatrix} \\[1.5em]
J_{\mathbf{f}}(x_1, x_2) = \begin{bmatrix} 1 & 1 \\ x_2 & x_1 \\ 2x_1 & -1 \end{bmatrix}\]
점(2,3)에서는
를 해석하면, 마지막 행 [4, -1]은 세번째 출력 \(f_3\)에 관한 정보로 이 점 근처에서 다른 입력은 고정하고, \(x_1\)만 조금 증가시키면, \(f_3\)는 증가하고, \(x_2\)만 조금 증가시키면 \(f_3\)는 감소한다는 뜻이다.
본론
신경망
그럼 이를 바탕으로 Jacobian 계산을 AI관점으로 적용하여 봐보자.
은닉층을 통과하는 연산 \(h = \phi(Wx + b)\) 역시 \(\mathbb{R}^n \to \mathbb{R}^m\) 형태의 벡터 함수입니다. 이곳에서의 Jacobian은 특정 입력 변화에 은닉 성분이 어떻게 반응하는지를 나타낸다.
여기서 \(Wx+b\)는 입력 성분들을 가중합과 편향으로 변환하는 단계이고, \(\phi\)는 그 결과에 적용하는 활성화 함수이다. 이러한 변환을 통해 입력 벡터로부터 새로운 표현 벡터를 만든다.
절에서는 입력에 대한 변화를 살펴보기 위해 W, b를 고정해 두자. 입력이 n차원이고, 층의 출력이 m차원이라면 다음과 같다.
\[\mathbf{x} \in \mathbb{R}^n, \quad W \in \mathbb{R}^{m \times n}, \quad \mathbf{b} \in \mathbb{R}^m, \quad \mathbf{h} \in \mathbb{R}^m\]
그리고 행렬곱의 크기를 확인하면
\[W\mathbf{x}: \quad (m \times n)(n \times 1) = m \times 1\]
이다. 여기에 같은 Shape의 b를 더하고, 각 성분에 활성화 함수를 적용하면 m차원 출력 벡터를 얻는다.
따라서 차원수를 다음과 같이 표현할 수 있다.
\[F: \mathbb{R}^n \to \mathbb{R}^m\]
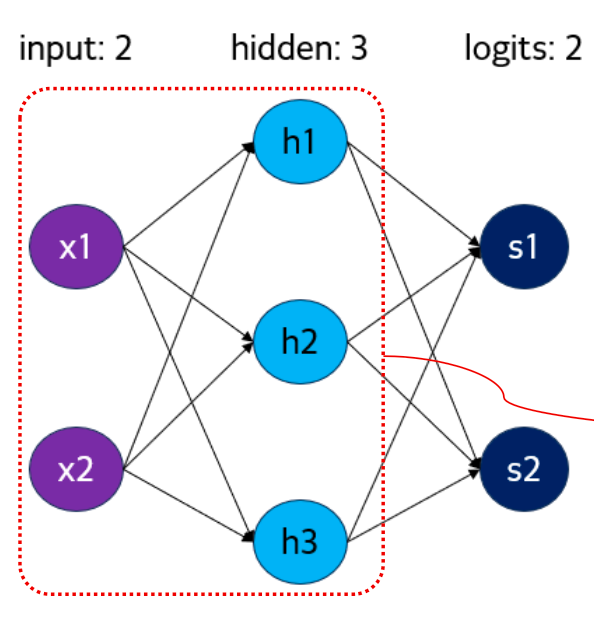
예를들어 다음과 같은 구조를 가지는 신경망이 있다고해보자.
빨강 박스를 봐보면 \(F: \mathbb{R}^2 \to \mathbb{R}^3\) 이다.
활성화 함수 까지 적용하면 x1, x2를 입력으로 하는 수식은 다음과 같다.
\[h_1 = \phi(w_{11} x_1 + w_{12} x_2 + b_1) \\h_2 = \phi(w_{21} x_1 + w_{22} x_2 + b_2) \\h_3 = \phi(w_{31} x_1 + w_{32} x_2 + b_3)\]
이 층의 자코비안은 \(J_F(\mathbf{x}) \in \mathbb{R}^{3 \times 2}\)가 된다.
z는 다음 수식을 치환한 기호이다(ex \(z_1 = w_{11} x_1 + w_{12} x_2 + b_1\))
\[J_F(\mathbf{x}) = \begin{bmatrix}
\phi'(z_1) w_{11} & \phi'(z_1) w_{12} \\
\phi'(z_2) w_{21} & \phi'(z_2) w_{22} \\
\phi'(z_3) w_{31} & \phi'(z_3) w_{32}
\end{bmatrix}
\]
저렇게 표현되는 이유는
\[J_F(\mathbf{x}) = \begin{bmatrix}\frac{\partial h_1}{\partial x_1} & \frac{\partial h_1}{\partial x_2} \\[0.5em] \frac{\partial h_2}{\partial x_1} & \frac{\partial h_2}{\partial x_2} \\[0.5em] \frac{\partial h_3}{\partial x_1} & \frac{\partial h_3}{\partial x_2}\end{bmatrix}\]
임으로 하나만 계산해보면
\[\frac{\partial h_1}{\partial x_1} = \phi'(w_{11} x_1 + w_{12} x_2 + b_1) \cdot w_{11} = \phi'(z_1) w_{11}\]
가 되기 때문이다. 따라서 저 자코비안 값들은 현재 점에서의 모델의 민감도라 볼 수 있다.
선형/아핀 함수
함수가 \(g(x) = Ax + b\)라고 하자. 여기서 A와 b는 입력 x에 의존하지 않는 고정된 행렬과 벡터이다.
여기서는 미분을 따로 계산하지 않아도 Jacobian을 바로 구할 수 있으며 자코비안 행렬이 바로 A이다.
왜 그런지 봐보자.
행렬 A는 다음과 같이 구성된다.
\[A=\begin{bmatrix}a_{11} & a_{12} & \cdots & a_{1n} \\a_{21} & a_{22} & \cdots & a_{2n} \\\vdots & \vdots & \ddots & \vdots \\a_{m1} & a_{m2} & \cdots & a_{mn}\end{bmatrix}\]
그리고 입력 데이터와 bias는 다음과 같이 구성된다.
\[\mathbf{x}=\begin{bmatrix}x_1 \\x_2 \\\vdots \\x_n\end{bmatrix},\qquad\mathbf{b}=\begin{bmatrix}b_1 \\b_2 \\\vdots \\b_m\end{bmatrix}\]
이 둘의 곱셈을 하면
\[\mathbf{g}(\mathbf{x})=A\mathbf{x}+\mathbf{b}=\begin{bmatrix}a_{11} & a_{12} & \cdots & a_{1n} \\a_{21} & a_{22} & \cdots & a_{2n} \\\vdots & \vdots & \ddots & \vdots \\a_{m1} & a_{m2} & \cdots & a_{mn}\end{bmatrix}\begin{bmatrix}x_1 \\x_2 \\\vdots \\x_n\end{bmatrix}+\begin{bmatrix}b_1 \\b_2 \\\vdots \\b_m\end{bmatrix}\]
\[\begin{align}
&=\begin{bmatrix}a_{11}x_1 + a_{12}x_2 + \cdots + a_{1n}x_n \\a_{21}x_1 + a_{22}x_2 + \cdots + a_{2n}x_n \\\vdots \\a_{m1}x_1 + a_{m2}x_2 + \cdots + a_{mn}x_n\end{bmatrix}+\begin{bmatrix}b_1 \\b_2 \\\vdots \\b_m\end{bmatrix}\\[3.5em]&=\begin{bmatrix}a_{11}x_1 + a_{12}x_2 + \cdots + a_{1n}x_n + b_1 \\a_{21}x_1 + a_{22}x_2 + \cdots + a_{2n}x_n + b_2 \\\vdots \\a_{m1}x_1 + a_{m2}x_2 + \cdots + a_{mn}x_n + b_m\end{bmatrix}
\end{align}\]
위 연산 결과에서 \(i\)번째 행만 뽑아내면 성분함수를 봐보자.
\[g_i(\mathbf{x})=a_{i1}x_1 + a_{i2}x_2 + \cdots + a_{ij}x_j + \cdots + a_{in}x_n + b_i\]
이 식을 \(j\)번째 입력 변수 \(x_j\)로 편미분하면, \(x_j\)가 포함되지 않은 다른 모든 항들(\(x_1, x_2, \dots\) 및 상수 \(b_i\))은 상수 취급되어 0으로 사라지고 \(x_j\)의 계수만 남는다.
\[\frac{\partial g_i}{\partial x_j}=\frac{\partial}{\partial x_j}\left(a_{i1}x_1 + \cdots + a_{ij}x_j + \cdots + a_{in}x_n + b_i\right)=a_{ij}\]
위 처럼 모든 \(i\)(\(1 \le i \le m\))와 \(j\)(\(1 \le j \le n\))에 대해 미분한 결과 \(\frac{\partial g_i}{\partial x_j} = a_{ij}\)를 원래 위치에 배치하여 Jacobian 행렬을 만들어보면
\[J_g(\mathbf{x})=\begin{bmatrix}\dfrac{\partial g_1}{\partial x_1}&\dfrac{\partial g_1}{\partial x_2}&\cdots&\dfrac{\partial g_1}{\partial x_n}\\[6pt]\dfrac{\partial g_2}{\partial x_1}&\dfrac{\partial g_2}{\partial x_2}&\cdots&\dfrac{\partial g_2}{\partial x_n}\\\vdots & \vdots & \ddots & \vdots\\\dfrac{\partial g_m}{\partial x_1}&\dfrac{\partial g_m}{\partial x_2}&\cdots&\dfrac{\partial g_m}{\partial x_n}\end{bmatrix}=\begin{bmatrix}a_{11} & a_{12} & \cdots & a_{1n}\\a_{21} & a_{22} & \cdots & a_{2n}\\\vdots & \vdots & \ddots & \vdots\\a_{m1} & a_{m2} & \cdots & a_{mn}\end{bmatrix}=A\]
가 되어 원래 행렬 A와 같다는 것을 볼 수 있다.
따라서 Jacobian의 모든 원소가 𝐴의 대응하는 원소와 같아집니다. 이 경우, 출력의 변화도 정확히 계산할 수 있다.
\[\mathbf{g}(\mathbf{x}+\Delta\mathbf{x})-\mathbf{g}(\mathbf{x})=A(\mathbf{x}+\Delta\mathbf{x})+\mathbf{b}-(A\mathbf{x}+\mathbf{b})=A\Delta\mathbf{x}\]
Jacobian이 입력 \(\mathbf{x}\)와 상관없이 고정된 상수 행렬(\(A\))로 나오고, \(\Delta \mathbf{g} = A\Delta \mathbf{x}\)가 근사가 아닌 완벽한 등식으로 성립하는 것은 함수의 모든 성분 이 1차식(아핀 함수)일 때만 가능하다.
그 이유는 함수의 각 성분 \(g_i(\mathbf{x})\)가 입력 변수들의 1차(1차식) 결합으로만 이루어져 있어야 편미분 시 변수가 모두 사라지고 계수(상수)만 남기 때문이다.
예시로 봐보자.
Example
다음과 같은 비선형 함수를 생각하자.
\[f(x)=x^2\]
입력값이 \(x \)에서 \(x+\Delta x\) 로 변할 때, 실제 출력 변화량은
\[\Delta f_{\mathrm{real}}
=
f(x+\Delta x)-f(x)\]
이고 각각을 함수 \(f(x)=x^2\)에 대입하면,
\[\begin{aligned}\Delta f_{\mathrm{real}}&=(x+\Delta x)^2-x^2 \\&=x^2+2x\Delta x+(\Delta x)^2-x^2 \\&=2x\Delta x+(\Delta x)^2\end{aligned}\]
가 된다.
이번에는 우리가 실제함수가 너무 복잡해 미분을 이용한 1차 근사를 통해 출력 변화량을 알아 내고자 한다면 다음과 같이 표기가 가능하다(Jacobian1장 참조)
\[\Delta f_{\mathrm{approx}}=f'(x)\Delta x\]
이렇게 근사 형태로 표현된다.
따라서 출력의 변화량이 실제와 근사한 것과 다르다는 것을 알 수 있다.
\[\Delta f_{\mathrm{real}}\neq\Delta f_{\mathrm{approx}}\]
만약 \(\Delta x\)가 충분히 작다면 \(\Delta x^2\)은 매우 작아짐으로
\[\Delta f_{\mathrm{real}}\approx \Delta f_{\mathrm{approx}}\]
라고 근사할 수 있다.
실제 값을 대입해서 확인해보면
\[x=2,\qquad\Delta x=0.1\]
이라고 하자.
\[f'(2)=2(2)=4\]
이므로 실제 출력 변화량은
\[\begin{aligned}\Delta f_{\mathrm{real}}&=4(0.1)+(0.1)^2 \\&=0.4+0.01 \\&=0.41\end{aligned}\]
이다.
반면, 미분을 이용한 근사 출력 변화량은
\[\begin{aligned}\Delta f_{\mathrm{approx}}&=f'(2)\Delta x \\&=4(0.1) \\&=0.4\end{aligned}\]
이다.
따라서 실제값과 근사한 값이 완전히 같지는 않지만 근사하다고 볼 수 있다.
\[0.41 \neq 0.4\]
그리고 두 값의 차이는
\[(\Delta x)^2=0.01\]
임으로 \(\Delta x\)가 작으면 작을 수록 더 실제값에 가까워진다 볼 수 있다.
Affine Function(아핀 함수)는 선형변환을 한 뒤, 일정한 값을 더하는 함수이다.
따라서 다음과 같은 함수는 선형함수가 아닌 아핀함수가 된다.
\[f(x)=2x+3\]
선형함수 조건 \[\text{1. } f(u+v)=f(u)+f(v)\\[1.5em]
\text{2. } f(cu)=c\,f(u)\]
f(x) = 2x는 이 조건을 성립하나 g(x) = 2x + 3은 성립하지 않는다.
위 아핀함수로 예시를 들어보자.
입력값이 \(x \)에서 \(x+\Delta x\) 로 변할 때, 실제 출력 변화량은
\[\Delta f_{\mathrm{real}}=f(x+\Delta x)-f(x)\]
이다.
함수를 대입하면,
\[\begin{aligned}\Delta f_{\mathrm{real}}&=\left[2(x+\Delta x)+3\right]-(2x+3) \\&=2x+2\Delta x+3-2x-3 \\&=2\Delta x\end{aligned}\]
이다.
이제 근사식의 형태를 써보자.
\[f'(x)=2\]
이므로 미분을 이용한 출력 변화량은
\[\begin{aligned}\Delta f_{\mathrm{approx}}&=f'(x)\Delta x \\&=2\Delta x\end{aligned}\]
따라서 Affine 함수에서는
\[\Delta f_{\mathrm{real}}=\Delta f_{\mathrm{approx}}\]
가 성립한다.
즉, 아래식은 정확한 등식의 형태다.
\[\Delta f=f'(x)\Delta x\]
이렇게 비선형 함수에서는 현재시점 \(x \)에서의 기울기와 \(x+\Delta x\)에서의 기울기가 비선형임으로 다르지만 선형함수의 경우 직선형태의 꼴을 가지기 때문에 현재지점 \(x \)와 \(x+\Delta x\)에서의 기울기가 같을 수 밖에 없기 때문이다.
함수 선형대수에서의 분류 \(f(x) = 2x\) 선형 함수이자 아핀 함수 \(f(x) = 2x + 3\) 아핀 함수이나 선형 함수는 아님 \(f(x) = x^2\) 아핀 함수가 아님
Jacobian 단위/영 행렬
Jacobian은 "입력이 1만큼 변할 때 출력이 얼마나 변하는가(민감도)"를 나타내는 행렬이다.
2차원 공간(\(n=2\))을 예시로 들어보자.
입력 벡터를 그대로 출력하는 2차원 항등함수 \(\mathbf{g}(\mathbf{x}) = \mathbf{x}\)가 있다.
\[\mathbf{g}\left(\begin{bmatrix}x_1\\x_2\end{bmatrix}\right)=\begin{bmatrix}g_1(x_1,x_2)\\g_2(x_1,x_2)\end{bmatrix}=\begin{bmatrix}x_1\\x_2\end{bmatrix}\]
각 성분함수의 편미분을 구한다.
첫 번째 출력 \(g_1=x_1:\)\(\frac{\partial g_1}{\partial x_1}=1\) \(\frac{\partial g_1}{\partial x_1}=0\) 첫 번째 출력 \(g_2=x_2:\)\(\frac{\partial g_2}{\partial x_1}=0\) \(\frac{\partial g_1}{\partial x_2}=1\) 각각 계산한 것을 행렬로 보면
\[J_g=\begin{bmatrix}\dfrac{\partial g_1}{\partial x_1} & \dfrac{\partial g_1}{\partial x_2} \\\dfrac{\partial g_2}{\partial x_1} & \dfrac{\partial g_2}{\partial x_2}\end{bmatrix}=\begin{bmatrix}1 & 0 \\0 & 1\end{bmatrix}=I\]
이처럼 단위 행렬이 된다.
입력과 무관하게 항상 고정된 값 \(\mathbf{b} = \begin{bmatrix} 3 \ 5 \end{bmatrix}\)를 출력하는 함수를 정의해 보자.
첫 번째 출력 \(g_1=3:\)\(\frac{\partial g_1}{\partial x_1}=0\) \(\frac{\partial g_1}{\partial x_1}=0\) 첫 번째 출력 \(g_2=5:\)\(\frac{\partial g_2}{\partial x_1}=0\) \(\frac{\partial g_1}{\partial x_2}=0\) 각각 계산한 것을 행렬로 보면
\[J_{\mathbf{g}}=\begin{bmatrix}\frac{\partial g_1}{\partial x_1} & \frac{\partial g_1}{\partial x_2} \\\frac{\partial g_2}{\partial x_1} & \frac{\partial g_2}{\partial x_2}\end{bmatrix}=\begin{bmatrix}0 & 0 \\0 & 0\end{bmatrix}\]
0행렬이 되는 것을 볼 수 있다.
Jacobian에서 0의 의미는 그 점에서의 1차 변화율 이 0이라는 것이다.
예시를 가지고 살펴보자
다음과 같은 함수가 있다.
\[\mathbf{f}(x_1, x_2, x_3)=\begin{bmatrix}f_1(x_1, x_2, x_3) \\f_2(x_1, x_2, x_3)\end{bmatrix}=\begin{bmatrix}x_1^2 + x_2 x_3 \\e^{x_1} + x_3\end{bmatrix}\]
기준점이
\[\mathbf{a} = (0,1,2)\]
라고 하자. 먼저 첫 번째 출력
\[f_1 = x_1^2 + x_2x_3\]
을 첫 번째 출력을 \(x_1\)에 대해서 미분하면
\[\frac{\partial f_1}{\partial x_1} = 2x_1\]
기준점 \(x_1=0\) 을 대입하면
\[\left.\frac{\partial f_1}{\partial x_1}\right|_{\mathbf{a}}= 2(0) = 0\]
이다. 여기까지만 보면
\(x_1\)은 \(f_1\)에 영향을 안 준다고 생각하기 쉽다.
라고 생각하기 쉽다. 그런데 실제 함수를 보면
\[f_1 = x_1^2 + x_2x_3\]
이므로 분명히\(x_1^2\)이 들어가 있다. 즉 \(x_1\)을 사용하고 있다.
이를 확인하기위해 \(x_1\)을 조금 변화시켜 출력변화량을 확인한다.
기준점을 대입하여 함수값을 봐보면 다음과 같다.
\[f_1(0,1,2) = 0^2 + (1)(2) = 2\]
이제 \(x_1\)을 0.1만큼 바꿔보자.
\[(0,1,2) \rightarrow (0.1,1,2)\]
그러면 출력은 다음과 같다.
\[f_1(0.1,1,2) = (0.1)^2 + (1)(2) = 2.01\]
따라서 출력 변화량은
\[\Delta f_1 = 2.01 - 2 = 0.01\]
분명히 출력이 변했다.
왜 그런지 알아보자. Jacobian을 이용한 1차 근사는 다음과 같이 쓸 수 있다.
\[\Delta f_1 \approx \frac{\partial f_1}{\partial x_1}\Delta x_1\]
\(\Delta x_1\)는 0.1이고 \(\frac{\partial f_1}{\partial x_1}=0\) 임으로
\[\Delta f_1 \approx 0 \times 0.1 = 0\]
이 된다. 분명 실제 계산했을 때는 2 → 2.01로 변했는데 말이다.
바로 그 이유는 Jacobian은 1차(선형) 변화율에 대한 근사이기 때문에 1차항에서의 변화량만 보인다.
\(x_1=0\)에서 \(x_1\)을 \(t\)만큼 변화시킨다고 해보자
\[x_1 : 0 \rightarrow t\]
그러면
\[f_1(t,1,2) = t^2 + 2\]
이고 원래 값은
\[f_1(0,1,2) = 2\]
이므로
\[\Delta f_1 = (t^2 + 2) - 2 = \boxed{t^2}\]
이다.
즉 출력 변화가 \(t\)에 비례하는 것이 아니라 \(t^2\)에 비례한다.
Jacobian이 잡아내는 것은 1차 변화임으로 1차항이 없어 0으로 나타난 것이다.
Taylor전개 관점에서 보면
\[\Delta f_1=\underbrace{0 \cdot t}_{\text{1차항}}+\underbrace{t^2}_{\text{2차항}}\]
따라서 Jacobian에는 0이라고 나오지만 실제 함수는 2차적으로 변한다.
그러므로 Jacobian이 0이라고 해서 대응되는 입력이 출력에 영향이 없는 것은 아니다.
(한 점에서 1차 민감도가 없다는 것과, 함수가 해당 입력을 전혀 사용하지 않는다는 것은 같은 뜻이 아님)
Jacobian의 각 원소는 전달 비율
\[\frac{\partial f_i}{\partial x_j}\]
는 현재 점 \(x_j\)가 조금 변할 때 \(f_i\)가 얼마나 변하는지를 뜻한다.
예를들어
\[J_{\mathbf{f}}=\begin{bmatrix}4 & 1 \\3 & 2\end{bmatrix}\]
이면 첫 번째 출력은
\[\Delta f_1 \approx 4\Delta x_1 + 1\Delta x_2\]
두 번째 출력은
\[\Delta f_2 \approx 3\Delta x_1 + 2\Delta x_2\]
처럼 변한다.
\[J_{\mathbf{f}}(\mathbf{a})\]
는 기준점 a에서의 기울기 정보이다. 비선형 함수에서는 위치가 바뀌면 Jacobian도 바뀐다.
따라서 현재 점 근처에서 근사가 실제값과 정확해지고 멀어질 수록 부정확해진다.
입력 변화가
\[\Delta \mathbf{x}\]
라면 출력 변화는
\[
\Delta \mathbf{f}
\approx
J_{\mathbf{f}}(\mathbf{a})\Delta \mathbf{x}
\]
로 근사한다.
예를 들어
\[J=\begin{bmatrix}4 & 1 \\3 & 2\end{bmatrix} \quad\Delta \mathbf{x}
=
\begin{bmatrix}
0.01 \\
-0.02
\end{bmatrix}\]
이면
\[\Delta \mathbf{f}\approx\begin{bmatrix}0.02 \\-0.01\end{bmatrix}\]
가 나오듯이 행렬곱을 통해 알 수 있었다.
Jacobian은 현재 위치 근처에서는 \(\Delta \mathbf{f} \approx J_{\mathbf{f}}(\mathbf{a})\Delta \mathbf{x}\) 라는 한 번의 행렬곱을 통해 입력 변화에 따른 출력의 변화량을 선형적(1차 근사)으로 간단히 예측할 수 있다.

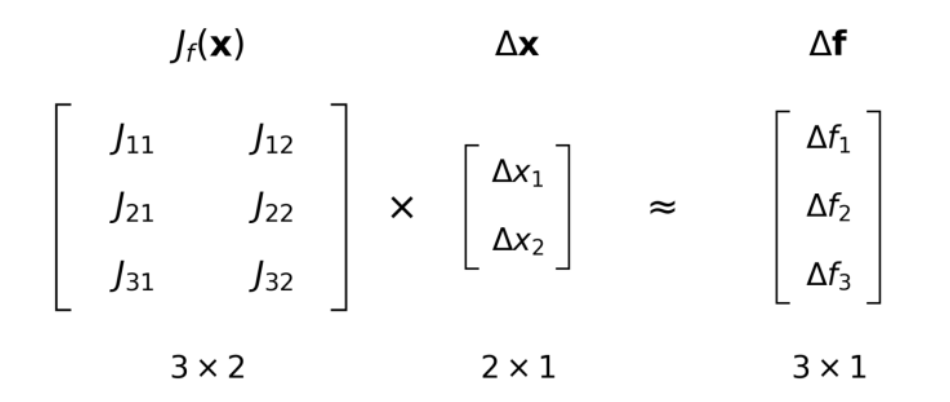
Comment