
서론
1. 기존 문제점
- VLA가 정교하고 안전한 접촉 작업을 수행하려면 촉각 정보가 중요하지만, 전용 촉각 센서는 비용이 높고 로봇 플랫폼 간 재현성이 떨어진다.
2. 핵심 아이디어
- 학습 단계에서는 촉각 센서를 활용하되, 추론 단계에서는 촉각 센서 없이도 촉각을 고려한 행동을 수행하는 VLA를 제안한다.
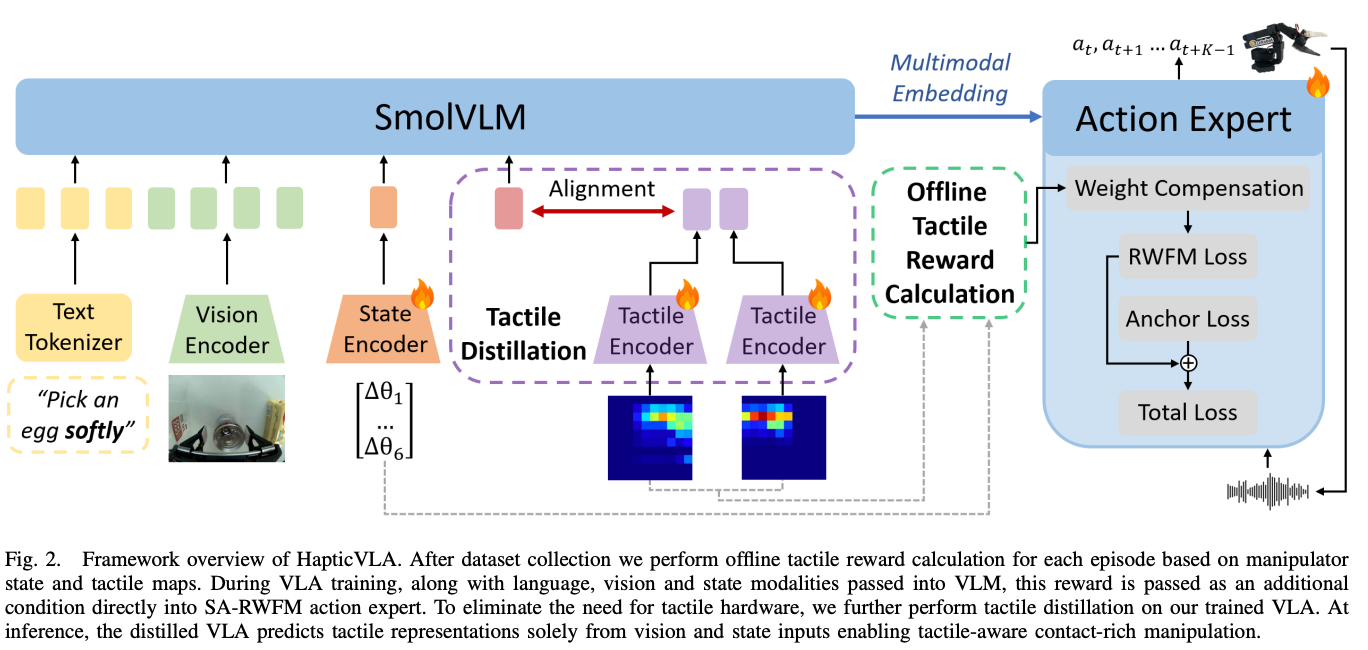
- 이를 위해 SA-RWFM(Teacher 학습) 과 Tactile Distillation(Student 학습) 의 두 단계로 구성한다.
3. 제안 방법
- SA-RWFM: 사전에 계산된 촉각 보상으로 Flow Matching 학습에 가중치를 부여하여, 과도한 파지력과 비효율적인 파지 궤적을 억제하는 Teacher를 학습한다.
- Tactile Distillation: Teacher의 Tactile Token을 정답으로 사용하여, Student가 카메라 영상과 로봇 상태만으로 해당 Token을 예측하도록 학습한다.
4. 실험 결과
- 실제 로봇 실험에서 평균 86.7%의 작업 성공률을 달성했다.
- 추론 시 실제 촉각 센서를 사용하는 기존 VLA 모델보다도 높은 작업 성공률을 보였다.
본론
HapticVLA는 연구진이 실제 로봇을 원격 조작하여 성공한 행동과 실패한 행동 모두 수집한다. 이후 촉각 센서값으로 행동의 안전성을 평가하고, 그 평가 결과를 Loss Weight로 사용하여 사전학습된 VLA가 안전한 행동을 더 중요하게 모방하도록 오프라인 미세조정하는 방법이다.
- Backbone으로 SmolVLA를 사용한다.
| 작업 | 성공 시연 | 실패 시연 |
|---|---|---|
| 잼병 집어 옮기기 | 70 | 20 |
| 와플 집어 옮기기 | 70 | 20 |
| 달걀 옮기기 (양팔) | 100 | 30 |
| 합계 | 240 | 70 |
- 성공 시연: 와플을 적절한 힘으로 잡아 손상 없이 옮김.
- 실패 시연: 와플을 지나치게 강하게 잡아 부서뜨리거나 변형시킴.
일반 모방학습에서는 사람이 수행한 행동을 모두 비슷한 중요도로 학습한다.
그런데 연구진이 수집한 시연에는 안전한 행동도 있고, 물체를 손상시킨 행동도 존재한다.
따라서 두 행동을 똑같이 모방시키는 것보다, 안전하게 달걀을 잡은 행동을 더 중요하게 학습시키는 것이 좋지 않을까? 라는 아이디어로 접근한다.
그래서 이미 수집해 놓은 촉각 센서 데이터와 작업 성공·실패 정보를 이용해 보상을 계산한다.
따라서 RWFM은 각 시연을 모방하는 손실의 중요도를 조절하며 학습한다.
그리고 Anchor Loss를 함께 적용해 기존 모델의 파라미터가 지나치게 변하는 것을 억제한다.
그리고 이렇게 학습한 모델이 촉각 정보를 활용하는 SA-RWFM Teacher이다.
Safety-Aware Reward-Weighted Flow Matching
촉각 센서(Tactile Sensor)로 물체를 얼마나 안전하게 잡고 있는지 평가하고, 그 결과를 보상으로 계산하는 방법을 설명한다.
Dataset Collection
제안한 SA-RWFM 목적함수를 지원하기 위해, 촉각 피드백과 파지 후 물체의 손상 여부를 기반으로 명시적인 보상 가중치를 부여할 수 있도록 성공 시연과 실패 상황의 시연 데이터를 의도적으로 모두 수집하였다.
각 단일 로봇 팔의 Pick-and-Place 작업에 대해 성공 에피소드 70개와 실패 에피소드 20개를 수집하였다. 여기서 실패 에피소드는 과도한 파지 힘으로 인해 물체에 영구적인 구조적 손상이 발생하거나 상당한 변형이 생긴 경우를 의미한다.
양팔 조작 작업에서는 성공 에피소드 100개와 실패 에피소드 30개를 수집하였다.
이러한 부정적 사례는 SA-RWFM Action Expert에 매우 중요하다. 실패 데이터는 목표 분포에서 높은 보상을 받는 영역을 제한하고 더욱 명확하게 만들어, 모델이 안전하고 보상이 높은 궤적과 안전하지 않은 궤적을 구별하는 능력을 향상시킨다.
1. Safety-Reward from Tactile Maps (촉각 맵 기반 보상)
1-1. 촉각 센서로 안전 보상 계산
촉각 센서로 수집된 데이터를 바탕으로 각 행동의 안전성을 평가하고, 안전한 행동을 더 중요하게 학습시킨다. 이 안전 보상은 학습할 때만 사용하며, 실제 로봇이 행동을 생성할 때는 계산하지 않는다.
예를들면 촉각 센서로 인한 보상은 다음과 같을 수 있다.
| 행동 | 촉각 센서 측정 결과 | 안전 보상(예시) |
|---|---|---|
| A | 적절한 힘으로 잡음 | +1.0 |
| B | 너무 강하게 누름 | -1.0 |
| C | 한쪽에 압력이 집중됨 | -0.5 |
| D | 너무 약하게 잡음 | -0.8 |
1-2. 촉각 맵 정의
로봇 그리퍼의 왼쪽과 오른쪽에 촉각 센서가 있고, 각 센서는 물체와 접촉하는 위치 및 압력의 분포를 2차원 이미지처럼 표현한다. 각 위치의 값은 0~1로 정규화되어 있다.
- \(M_t^L,M_t^R\in[0,1]^{H\times W}\)
- \(H,\;W\)는 촉각 맵의 높이와 너비
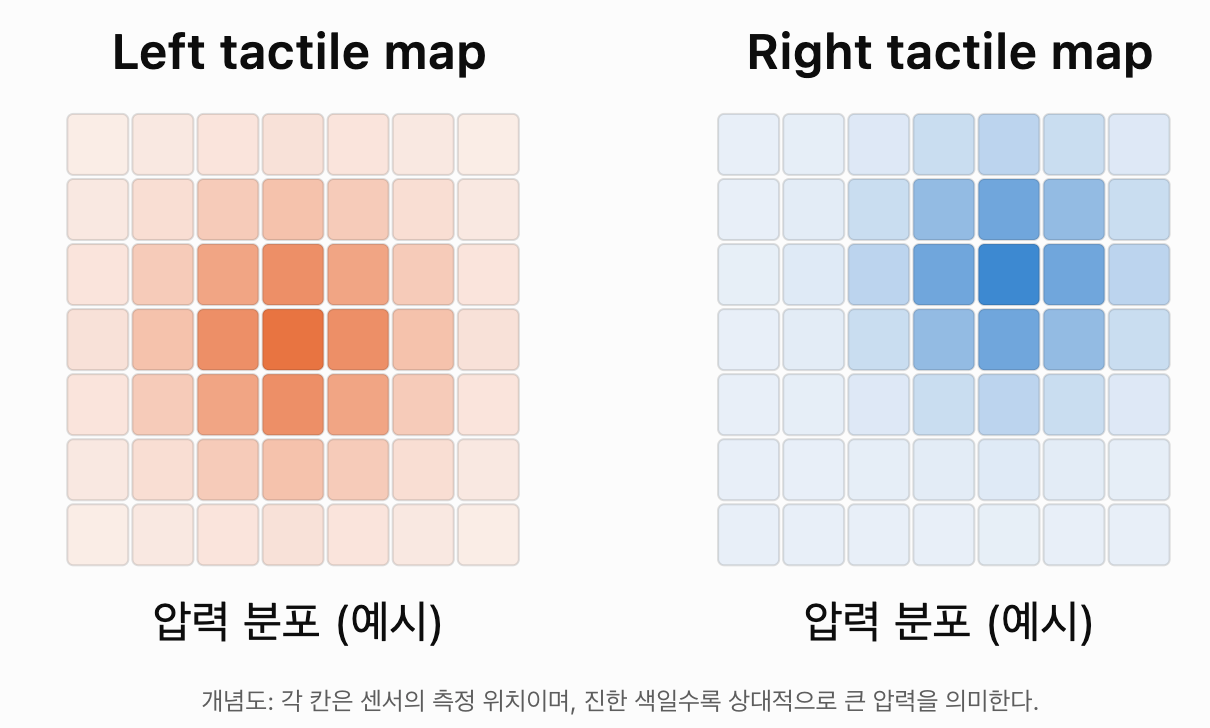
Normalization, activation, and calibration
촉각 센서의 원래 값은 크기가 일정하지 않을 수 있으므로 정규화가 필요하다.
이때 극단적으로 큰 값 하나에 영향을 받지 않도록, 전체 데이터의 99%가 그 이하에 해당하는 값을 기준으로 스케일을 정한다.
예를들어 p99의 백분위수가 10이였다면 10을 기준으로 스케일을 정한다는 뜻이다.
데이터셋의 모든 에피소드에 걸쳐 강건성을 확보하기 위해, 모든 보상 임계값을 데이터셋의 접촉 통계량과 분위수를 기반으로 보정한다.
1-4. 임계값 설정
여기에는 안전한 힘의 범위 \([f_{\min},f_{\max}]\), 최대 압력 한계 \(p_{\max}\), 압력 집중도 한계 \(c_{\max}\), 그리고 양쪽 촉각 패드가 모두 활성화되었을 때 허용되는 패드 간 힘의 비대칭 정도 \(\delta\)가 포함된다.
| 기호 | 의미 | 판단 목적 |
|---|---|---|
| \(f_{\min}\) | 최소 힘 | 너무 약하게 잡는지 |
| \(f_{\max}\) | 최대 힘 | 너무 강하게 잡는지 |
| \(p_{\max}\) | 최대 압력 | 특정 지점의 압력이 너무 큰지 |
| \(c_{\max}\) | 압력 집중도 한계 | 압력이 좁은 영역에 몰리는지 |
| \(\delta\) | 양쪽 힘 차이 허용 범위 | 좌우 힘의 불균형이 큰지 |
1-5. 활성화된 센서 정의
왼쪽과 오른쪽 촉각 센서 중 실제로 접촉이 발생했다고 판단된 센서만 선택한다.
예를 들어 왼쪽만 접촉했다면 \(A=\{L\}\), 양쪽 모두 접촉했다면 \(A=\{L,R\}\)가 된다.
Contact statistics (접촉 통계량)
2차원 촉각 맵 전체를 직접 평가하는 대신, 물체를 얼마나 세게 잡는지, 가장 강하게 누르는 곳은 어디인지, 압력이 한 곳에 몰려 있는지를 세 숫자로 표현한다.
수식 (1): 평균 힘의 대리 지표
촉각 맵의 모든 값을 더한 다음 전체 셀 개수로 나눈다. 즉, 평균적인 접촉 강도를 나타낸다.
실제 물리적 힘(N)이 아니라 정규화된 촉각 값의 평균이다.
수식 (2): 최대 압력
촉각 맵에서 가장 큰 값을 선택한다. 특정 위치가 지나치게 강하게 눌리는지 확인하기 위한 것이다.
수식 (3): 압력 집중도
최대 압력을 촉각 맵 전체 값의 합으로 나눈다. 전체 접촉 강도 중 가장 강한 한 지점이 차지하는 비중을 나타내며, \(\varepsilon\)은 0으로 나누는 것을 방지하는 작은 값이다.
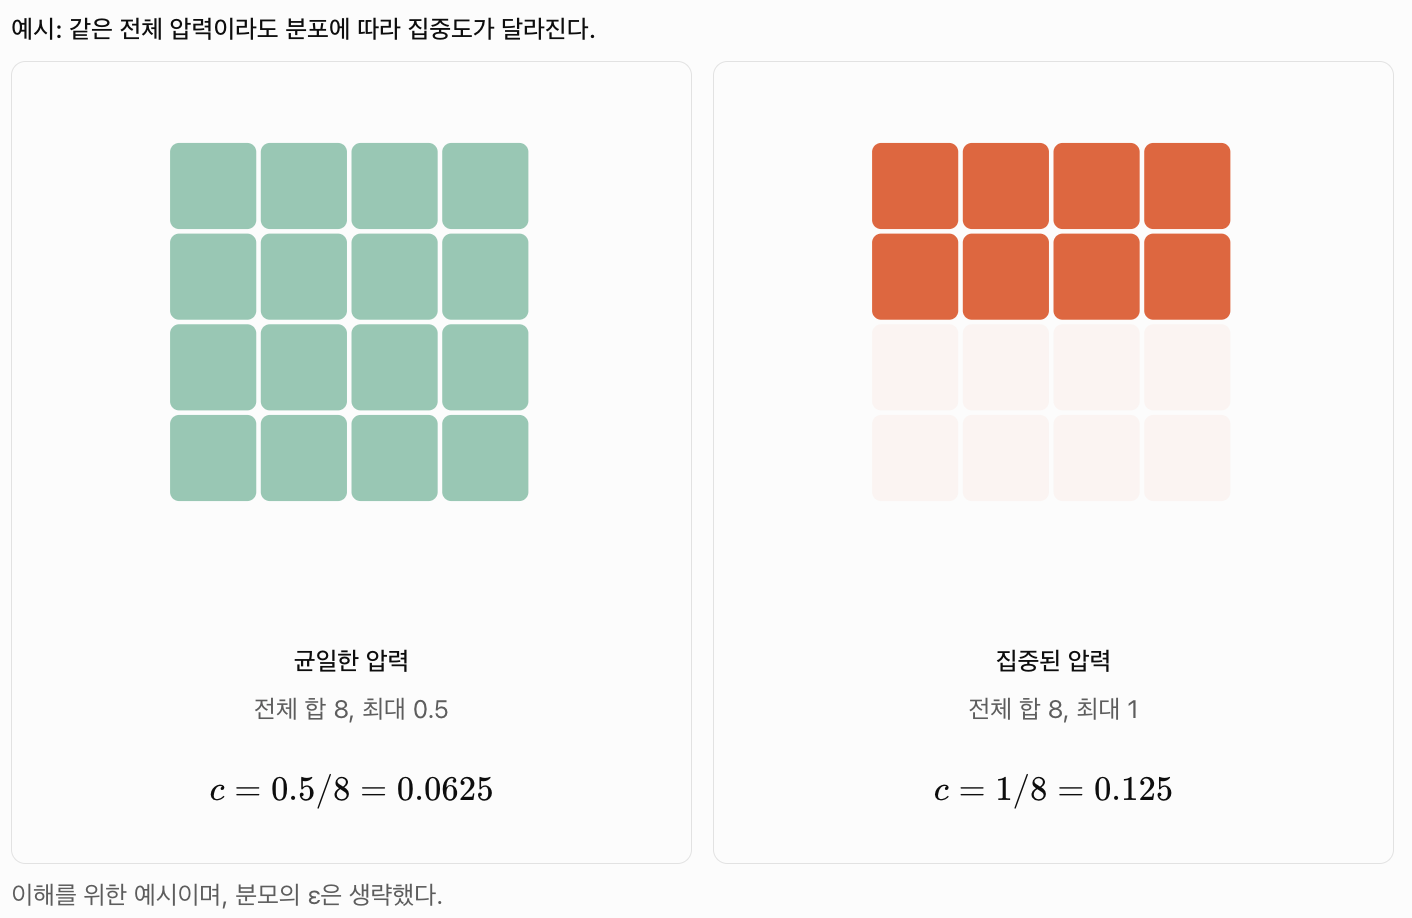
1. 첫 번째: 균일한 압력
- 16개 칸 모두 압력 0.5
- 전체 압력 합: \(16\times0.5=8\)
- 최대 압력: 0.5
2. 두 번째: 집중된 압력
- 8개 칸에는 압력 1, 나머지칸은 0
- 나머지 8개 칸에는 압력 0
- 전체 압력 합: \(8\times1+8\times0=8\)
- 최대 압력: 1
두 그림의 전체 압력 합은 8로 동일하지만, 압력 집중도는 다르다.
- \(c_{\text{균일}}=\frac{0.5}{8}=0.0625\)
- \(c_{\text{집중}}=\frac{1}{8}=0.125\)
따라서 두 번째 그림의 압력 집중도가 두 배 높다.
1-6. 압력 중심 계산
촉각 센서의 각 위치에서 측정된 압력을 가중치로 사용하여 압력이 집중된 중심 위치를 계산한다.
이를 통해 물체와의 접촉 위치가 시간에 따라 이동하는지 확인할 수 있다.
수식 (4)
각 위치에 해당 위치의 압력을 곱하고 전체 압력으로 나눈다.
즉, 압력이 큰 위치일수록 중심 위치 계산에 더 큰 영향을 준다.
| 기호 | 의미 |
|---|---|
| \(M_{t,ij}^{s}\) | 시간 \(t\), 센서 \(s\)의 \((i,j)\) 칸에서 측정된 압력 |
| \(X_{ij}\) | 해당 칸의 X 좌표 (0~1) |
| \(Y_{ij}\) | 해당 칸의 Y 좌표 (0~1) |
| \(\sum_{i,j}\) | 모든 센서 칸의 값을 합산 |
| \(\varepsilon\) | 0으로 나누는 것을 막기 위한 매우 작은 값 |
| \(s\) | 왼쪽 또는 오른쪽 촉각 센서 |
간단한 예시로 가로 3칸짜리 센서로 생각해 보자.
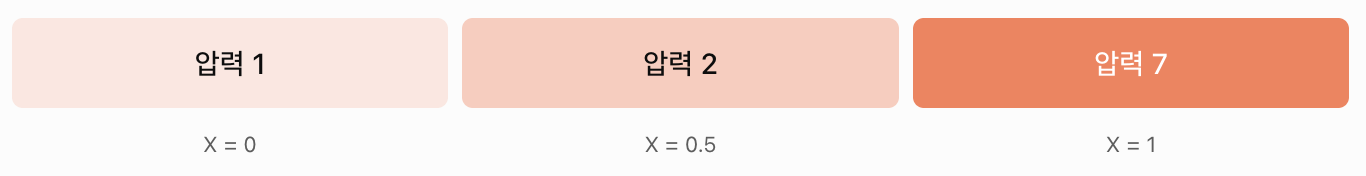
| 칸 | X 좌표 | 압력 M | 압력 \(\times X\) |
|---|---|---|---|
| 왼쪽 | 0 | 1 | 0 |
| 가운데 | 0.5 | 2 | 1 |
| 오른쪽 | 1 | 7 | 7 |
| 합계 | 10 | 8 |
따라서 X 방향 압력 중심은
즉, X 좌표 범위가 0~1일 때 압력 중심은 0.8이다.
이렇게 보면 잘 수식의 의미가 안 와닿을 수 있는데 결국 아래 수식과 동일하다.
Holding and slip (파지 및 미끄러짐)
로봇이 물체를 잡고 있는 상태인지 판단한다. 안정적으로 잡고 있으면 \(h_t=1\), 그렇지 않으면 \(h_t=0\)으로 표현한다.
수식 (5)
- \(\mathbb I[\cdot]\): 조건이 참이면 1, 거짓이면 0
- \(\tau_{\mathrm{cop}}\): 허용되는 압력 중심 이동량
- \(d_f\): 허용되는 힘 감소량
- \(\lor\): OR 조건, 둘 중 하나만 만족해도 참
즉, 잡고 있는 상태에서 압력 중심이 크게 이동하거나 접촉 힘이 급격히 감소하면 미끄러짐으로 판정한다.
1-7. 압력 중심 이동량 계산
여기서 \(\Delta\operatorname{cop}_t^s\)는 현재 시간과 이전 시간의 압력 중심 사이의 유클리드 거리를 의미한다.
수식 (6)
예를 들어 압력 중심이 \((0.3,0.5)\)에서 \((0.7,0.5)\)로 이동했다면 이동 거리는 0.4이다. 이 값이 임계값보다 크면 미끄러짐을 의심한다.
- \( \|x\|_2=\sqrt{x_1^2+x_2^2+\cdots+x_n^2} \)
2. Per-step Reward and Episode Risk
시간 단계별 보상 및 에피소드 위험도
2-1. 안전하지 않은 행동에 대한 패널티
로봇이 물체를 잡는 과정에서 안전 기준을 위반할 때마다 음수 보상을 부여한다. 안전한 범위에서 물체를 잡으면 패널티가 없고, 위험한 정도가 커질수록 패널티도 증가한다.
수식 (7)
| 패널티 | 언제 발생하는가? | 목적 |
|---|---|---|
| Over-force | \(f_t^s>f_{\max}\) | 너무 세게 잡는 행동 억제 |
| Under-force | \(h_t=1이고 f_t^s<f_{\min}\) | 잡는 중 힘이 부족한 행동 억제 |
| Peak pressure | \(p_t^s>p_{\max}\) | 한 지점에 과한 압력 방지 |
| Concentration | \(c_t^s>c_{\max}\) | 압력이 특정 지점에 몰리는 현상 방지 |
| Asymmetry | 양쪽 활성화 및 힘 차이 >\(\delta\) | 좌우 파지 힘의 균형 유지 |
| Slip | \(\mathrm{slip}_t=1\) | 미끄러짐 방지 |
ReLU는 다음과 같다: \(\operatorname{ReLU}(x)=\max(0,x)\)
예를 들어 최대 허용 힘이 \(f_{\max}=0.6\),
실제 평균 힘이 \(f_t^s=0.8\)이라면 다음과 같다: \(\operatorname{ReLU}(0.8-0.6)^2=0.04\)
반면 실제 힘이 0.5라면 다음과 같다: \(\operatorname{ReLU}(0.5-0.6)^2=0\)
따라서 허용 범위를 넘지 않으면 해당 패널티가 발생하지 않는다. \(\lambda\)는 각 위험 요소의 중요도를 조절하는 가중치이다.
2-2. 에피소드 전체 위험도 계산
매 순간 위험한 행동을 평가하는 것뿐만 아니라, 물체를 잡고 이동하는 전체 과정에서 얼마나 위험한 상황이 발생했는지도 하나의 점수로 평가한다.
- \(e_t\): 가장 심각한 안전 기준 초과량
- \(M\): 전체 시간 중 실제로 물체를 잡고 있었던 시점은 언제인가?
로봇이 컵을 잡을 때 다음 세 가지를 확인한다고 가정한다.
| 평가 항목 | 안전 기준 (예시) | 실제 측정값 |
|---|---|---|
| 힘 (Force) | 10 | 12 |
| 최대 압력 (Peak pressure) | 0.8 | 1.0 |
| 압력 집중도 (Concentration) | 0.2 | 0.3 |
| 항목 | 계산 | 초과량 |
|---|---|---|
| 힘 | \((12-10)/10\) | 0.20 |
| 최대 압력 | \((1.0-0.8)/0.8\) | 0.25 |
| 압력 집중도 | \((0.3-0.2)/0.2\) | 0.50 |
이 중 가장 큰 초과량을 \(e_t\)로 정의한다.
여기서 주의할 점은 세 항목의 초과량을 모두 더하는 것이 아니라, 가장 큰 값 하나를 선택한다는 것이다.
이번에는 로봇이 10초 동안 컵을 잡는 작업을 수행한다고 가정하자. 그리고 초 단위로 측정했다고하자.
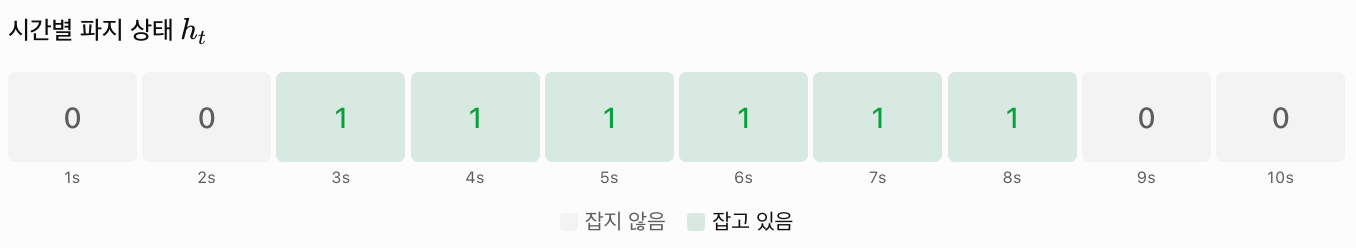
전체 에피소드 길이는 \(T=10\)이다.
하지만 실제로 컵을 잡고 있었던 시점은 3~8초이다. → 따라서 \( |M|=6 \).
\(e_t\)와 \(M\)을 함께 사용하면?
| 시간 \(t\) | 파지 상태 \(h_t\) | 최대 초과량 \(e_t\) | 파지 중 평가 대상 |
|---|---|---|---|
| 1 | 0 | 0.0 | 제외 |
| 2 | 0 | 0.0 | 제외 |
| 3 | 1 | 0.0 | 포함 |
| 4 | 1 | 0.2 | 포함 |
| 5 | 1 | 0.5 | 포함 |
| 6 | 1 | 0.1 | 포함 |
| 7 | 1 | 0.0 | 포함 |
| 8 | 1 | 0.4 | 포함 |
| 9 | 0 | 0.0 | 제외 |
| 10 | 0 | 0.0 | 제외 |
파지 중 \(e_t\)는 다음과 같다.
2-4. 최종 위험 점수
전체 파지 구간에서 심각한 위험 수준과 미끄러짐 발생 정도를 합산하고, 최종 위험도를 0~1 범위로 제한한다.
수식 (8)
| 기호 | 의미 |
|---|---|
| \(e_t\) | 시간 \(t\)에서 가장 큰 정규화된 안전 기준 초과량 |
| \(M\) | 실제로 물체를 잡고 있는 시간 단계의 집합 |
| \(P_{95}\) | 파지 구간의 초과량 중 95번째 백분위수 |
| \(\mathrm{slip}_t\) | 시간 \(t\)에서 미끄러짐이 감지되면 1, 아니면 0 |
| \(T\) | 전체 에피소드의 시간 단계 수 |
| \(\mathrm{clip}(\cdot,0,1)\) | 계산 결과를 0~1 범위로 제한 |
- 임계값 초과 위험
물체를 잡고 있는 동안 측정한 임계값 초과량의 95번째 백분위수를 사용한다. 순간적인 극단값 하나만 사용하는 대신 위험 수준이 높은 구간을 반영한다.
위의 예시를 가져오면 95번째 백분위수를 계산하기 위해 오름차순으로 정렬한다.
여기서는 선형 보간 방식으로 95번째 백분위수를 계산한다.
따라서 이 에피소드의 심각한 안전 기준 초과 정도는 0.475로 평가된다.
참고로 95번째 백분위수는 계산 방식에 따라 달라질 수 있다. 논문에서는 따로 표기하지 않았다.
- 미끄러짐 위험
에피소드 전체에서 미끄러짐으로 판정된 시간 단계의 비율에 0.5를 곱한다.
마지막으로 \(\operatorname{clip}(\cdot,0,1)\)을 적용해 결과를 0~1로 제한한다.
논문에서는 CoP의 갑작스러운 이동이나 힘의 급격한 감소를 이용해 미끄러짐을 감지한다.
이번 예시에서는 5초와 8초에 각각 한 번씩 미끄러짐이 감지되었다고 가정하자.
| 시간 \(t\) | \(h_t\) | \(e_t\) | \(\mathrm{slip}_t\) |
|---|---|---|---|
| 1 | 0 | 0.0 | 0 |
| 2 | 0 | 0.0 | 0 |
| 3 | 1 | 0.0 | 0 |
| 4 | 1 | 0.2 | 0 |
| 5 | 1 | 0.5 | 1 |
| 6 | 1 | 0.1 | 0 |
| 7 | 1 | 0.0 | 0 |
| 8 | 1 | 0.4 | 1 |
| 9 | 0 | 0.0 | 0 |
| 10 | 0 | 0.0 | 0 |
전체 에피소드에서 미끄러짐은 2회 발생했다.
따라서 미끄러짐 페널티는
최종 에피소드 위험도 계산
앞에서 계산한 두 값을 논문 수식 (8)에 대입한다.
3. Episode Reward (에피소드 보상)
3-1. 최종 에피소드 보상 정의
앞에서는 로봇이 매 순간 얼마나 안전하게 물체를 잡았는지를 평가했다.
하지만 안전하게 잡았더라도 물체를 옮기는 작업 자체에 실패했다면 좋은 행동이라고 할 수 없음으로
에피소드 전체의 보상을 계산할 때는 다음을 함께 고려한다.
- 물체를 안전하게 잡았는가?
- 작업을 성공했는가?
- 물체를 떨어뜨리거나 손상했는가?
- 전체 과정에서 얼마나 위험한 상황이 발생했는가?
수식 (9): 평균 Step Reward
전체 에피소드에서 각 시간 단계의 보상 \(r_t\)를 모두 더한 후 에피소드 길이 \(T\)로 나누어 평균을 계산한다.
여기에 \(R_{\mathrm{step\ scale}}\)이라는 조절 계수를 곱한다.
수식 (10): 최종 Episode Reward
앞서 계산한 평균 안전 보상에 작업 성공 보상을 더하고, 물체를 떨어뜨리거나 손상한 경우와 전체 위험도에 대한 패널티를 준다.
| 항목 | 의미 | 보상에 미치는 영향 |
|---|---|---|
| \(R_{\mathrm{step}}\) | 평균 촉각 안전 보상 | 안전 위반 시 감소 |
| success | 작업 성공 여부 | 성공하면 증가 |
| drop | 물체 낙하 여부 | 낙하하면 감소 |
| damage | 물체 손상 여부 | 손상하면 감소 |
| risk | 전체 에피소드 위험도 | 위험도가 높으면 감소 |
- \(R_{\mathrm{succ}},R_{\mathrm{drop}},R_{\mathrm{damage}},R_{\mathrm{risk}}\) 는 각 항목의 중요도를 조절하는 계수
4. SA-RWFM Fine-Tuning
오프라인 데이터셋 \(D=(o_t,a_{t:t+K-1},\tau,r_t,R_{\mathrm{episode}})\)가 주어졌을 때, 각 학습 샘플에서 계산된 보상에 따라 가중치를 부여하여 Flow Matching 기반 VLA 정책을 미세조정한다.
따라서 모든 샘플을 동일한 중요도로 학습시키지 않고, 보상이 높은 샘플을 더 강하게 학습하도록 가중치를 부여한다.
예를 들어 다음과 같다.
| 학습 데이터 | 행동 평가 | 학습 가중치 예시 |
|---|---|---|
| A | 안전하게 작업 성공 | 1.5 |
| B | 작업 성공, 압력 과다 | 0.9 |
| C | 물체를 떨어뜨림 | 0.4 |
여기서 \(o_t\) 시간 단계 \(t\)에서의 관측값, \(a_{t:t+K-1}\)은 \(K\)개 시간 단계에 걸친 행동 시퀀스, \(\tau\)는 데이터셋 샘플의 시간 단계, \(r_t\)는 시간 단계별 보상, \(R_{\mathrm{episode}}\)는 에피소드 보상을 의미한다.
Per-sample FM loss with task masking
VLA가 예측하는 행동은 여러 차원으로 구성될 수 있지만, 모든 작업에서 모든 행동 차원이 사용되는 것은 아니다.
따라서 해당 작업에서 사용하지 않는 행동 차원은 손실 계산에서 제외한다.
수식 (11)
- \(L_i\): 샘플 \(i\)의 Flow Matching 손실
- \(\ell_{i,h,j}\): 샘플 \(i\)의 시간 위치 \(h\), 행동 차원 \(j\)에 대한 손실
- \(m_{i,j}\): 해당 행동 차원을 학습할지 결정하는 \(\in\{0,1\}\) 마스크
- \(H\): 손실 계산에 사용하는 행동 시퀀스 길이
예를 들어 행동이 4차원이고 특정 작업에서는 앞의 2차원만 사용한다면,
로 정의한다.
행동을 연속으로 2번 예측한다고 가정하면: \(H=2\)
| 행동 차원 | 첫 번째 행동 h=1 | 두 번째 행동 h=2 | 마스크 |
|---|---|---|---|
| X | 1 | 9 | 1 |
| Y | 4 | 16 | 1 |
| Z | 100 | 100 | 0 |
| Gripper | 100 | 100 | 0 |
그리고 현재 에피소드에서 X, Y에 대한 액션만 필요했다면 필요한 행동 차원의 손실만 합산한다.
분자
마스크가 0인 Z와 Gripper의 손실은 아무리 크더라도 합산되지 않는다.
분모
여기서 4라는 값은 다음과 같다: \(\underbrace{2}{\text{행동 시퀀스 길이}} \times \underbrace{2}{\text{사용하는 행동 차원}} =4\)
\(\varepsilon\)은 매우 작은 값이므로 이 예시에서는 생략하면
결국 X와 Y에 해당하는 네 개 손실값 \(1,4,9,16\)의 평균을 계산한 것.
행동 청크 단위 할인 보상
하나의 학습 샘플이 여러 행동으로 이루어진 시퀀스를 예측한다면, 그 행동 시퀀스가 수행되는 동안의 보상을 하나로 합산한다.
수식 (12)
에피소드 보상을 이용한 전역 평가
청크 보상은 짧은 구간에서 얼마나 안전한 행동을 했는지를 평가한다.
반면 에피소드 보상은 전체 작업을 성공적으로 수행했는지를 평가한다.
따라서 두 보상을 함께 사용하면 짧은 구간에서의 행동 안전성과 전체 작업의 성공 여부를 모두 고려할 수 있다.
데이터셋 간 보상 크기 차이 보정
데이터셋 간 보상 크기 차이로 발생하는 편향을 방지하기 위해, 각 그룹 \(g\)내부에서 강건하게 정규화된 점수를 계산한다.
예를 들어 A 작업의 보상은 0~10, B 작업의 보상은 0~100이라면 B 작업의 보상이 단순히 더 크다는 이유로 높은 가중치를 받을 수 있다.
작업마다 보상 점수의 기준이 다르기 때문에, 같은 작업에서 다른 행동들보다 얼마나 잘했는지를 비교할 수 있도록 점수를 조정한다.
수식 (13)
- \(x\): 정규화하려는 보상 점수
- \(\operatorname{median}_g(x)\): 그룹 \(g\)의 보상 중앙값
- \(\operatorname{scale}_g\): 그룹의 보상 분포 크기를 나타내는 값
- \(z\): 정규화된 보상 점수
여기서 스케일은 다음과 같이 정의한다.
수식 (14)
MAD는 중앙값을 기준으로 데이터가 얼마나 퍼져 있는지 나타내는 통계량
즉,
- 전체 데이터의 중앙값을 구한다.
- 각 데이터가 중앙값에서 얼마나 떨어져 있는지 계산한다.
- 그 차이들의 중앙값을 구한다.
이 방식은 이상치에 비교적 강건하다.
여기서 1.4826은 데이터가 정규분포를 따른다는 가정에서 MAD를 표준편차에 대응하는 크기로 보정하기 위한 계수.
MAD 계산이 불가능한 경우
예를 들어 데이터의 대부분이 동일한 값이라면 MAD가 0이 될 수 있다.
이 경우 MAD만으로 정규화하면 문제가 발생하므로 표준편차를 대신 사용한다.
Advantage-like score
앞에서는 두 종류의 보상을 계산했다.
- Episode Reward: 전체 작업을 얼마나 성공적이고 안전하게 수행했는가?
- Chunk Reward: 해당 행동 시퀀스가 얼마나 안전했는가?
이제 두 점수를 가중합하여 하나의 점수로 만든다.
수식 (15)
여기서 \(\beta=0.7\), \(c_A=6\)으로 설정한다.
따라서
보상 점수를 학습 가중치로 변환
초기 학습 가중치를 다음과 같이 정의한다.
수식 (16)
앞서 계산한 점수 \(A_i\)를 지수함수에 넣어서 학습 가중치로 변환한다.
점수가 높을수록 학습 가중치가 커지고, 점수가 낮을수록 작아진다.
지수함수를 사용하면 점수가 높은 샘플의 가중치가 과도하게 커질 수 있다.
따라서 특정 데이터 하나가 학습을 지나치게 지배하지 않도록 가중치의 범위를 제한한다.
본 연구에서는 하이퍼파라미터를 \(\alpha=0.25\), 최소 가중치 \(w_{\min}=0.25\), 최대 가중치 \(w_{\max}=4.0\)으로 설정하였다.
그다음 배치 전체에서 가중치의 평균이 1이 되도록 다시 정규화한다.
수식 (17)
보상 가중 Flow Matching 손실은 다음과 같이 정의한다.
수식 (18)
각 샘플의 보상에 따라 학습 가중치 \(w_i\)를 다르게 부여한다.
따라서 안전하고 성공적인 행동에서 발생한 손실은 더 크게 반영하고, 위험하거나 실패한 행동의 손실은 상대적으로 작게 반영한다.
이 방식은 데이터마다 학습 중요도를 다르게 설정하는 것이다.
HapticVLA가 실패 시연을 학습에 포함하는 이유는 실패 시연 속 유용한 행동과 접촉 데이터를 활용하면서, 보상이 낮은 행동의 영향을 줄이기 위해서이다.
실패 시연도 모든 행동이 잘못된 것은 아니다.
예를들어 데이터셋이 다음과 같이 구성되어있따면 안전한 부분에 대해서는 배울 것이 있다.
| 시간 | 로봇의 행동 | 안전성 |
|---|---|---|
| 1초 | 컵을 향해 팔 이동 | 안전 |
| 2초 | 컵에 손가락 접근 | 안전 |
| 3초 | 적절한 힘으로 컵 잡기 | 안전 |
| 4초 | 컵을 너무 강하게 누름 | 위험 |
| 5초 | 컵이 손상됨 | 실패 |
그러나 이 방식에는
- 실패한 행동을 완전히 배제하는 것이 아니라 모방하는 비중만 줄이고
- 실패 시연이 많거나 성공·실패 행동이 비슷하면 위험한 행동도 학습될 가능성이 있어
- 안전한 행동에 더 높은 가중치를 부여한다고 해서 위험한 행동의 생성이 완전히 방지되는 것은 아니다.
보상 가중 학습의 문제점
보상이 높은 행동을 지나치게 강조하여 학습하면 모델이 기존에 학습한 다양한 행동을 잃어버릴 수 있다.
예를 들어 기존 VLA가 여러 방식으로 물체를 잡을 수 있었는데 특정 안전한 행동에 높은 가중치를 계속 부여하면, 해당 행동만 반복적으로 생성하는 방향으로 정책이 치우칠 위험이 있다.
- Drift: 모델이 초기 모방학습 정책에서 크게 벗어나는 현상
- Mode Collapse: 모델이 다양한 행동을 생성하지 못하고 일부 행동 패턴에 치우치는 현상
보상 가중 학습으로 기존 정책을 개선하되, 원래 모방학습으로 습득한 행동 능력이 지나치게 변경되지 않도록 한다.
식 (19)
- \(\theta_p\): 현재 모델 파라미터
- \(\theta_p^0\): 초기 모방학습 모델 파라미터
- \(\Theta\): 정규화 대상 파라미터들의 집합
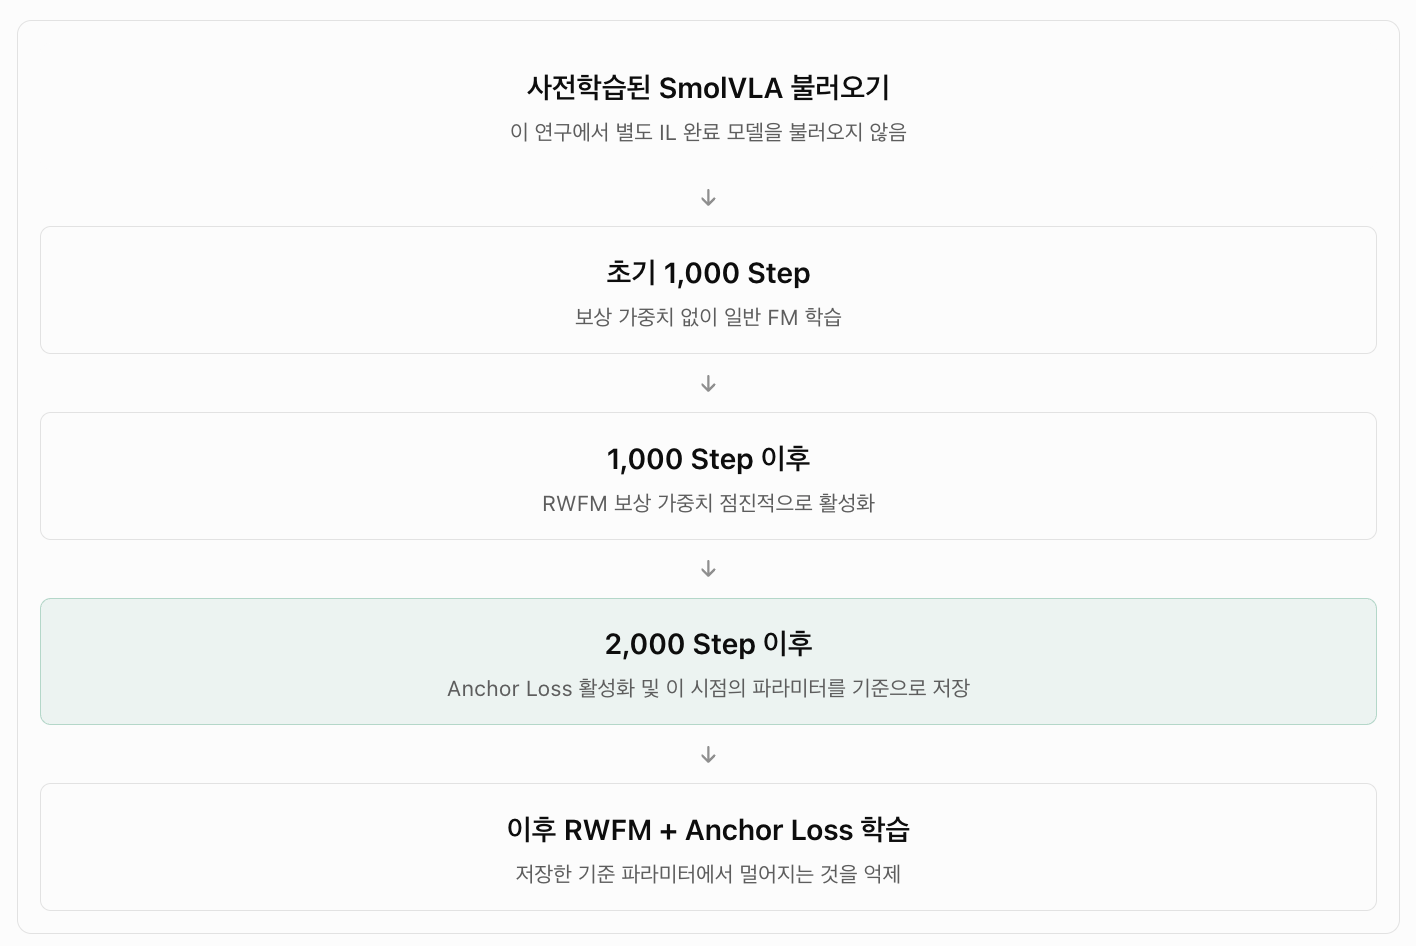
RWFM으로 보상항을 loss weight으로 활용해 모델을 학습시키다가 2000스탭 이후부터는 해당 모델의 가중치를 기 점으로 크게 변하지 않도록 학습한다.
최종 손실함수
수식 (20)
최종 학습 손실은 두 가지로 구성됩니다.
첫 번째는 보상을 이용해 안전하고 성공적인 행동을 더 강하게 학습하는 \(L_{\mathrm{rwfm}}\)이다.
두 번째는 모델이 초기 모방학습 정책에서 과도하게 벗어나는 것을 억제하는 \(L_{\mathrm{anchor}}\)이다,
\(\lambda_{\mathrm{anchor}}\)는 초기 정책에서 벗어나는 정도를 얼마나 강하게 제한할지 조절한다.
학습 초기에는 기존 정책의 행동을 유지할 수 있도록 \(\alpha\)를 점진적으로 증가시키고, \(\lambda_{\mathrm{anchor}}\)를 조절하는 Warm-up 스케줄을 적용한다.
- \(\alpha\): 좋은 행동과 나쁜 행동의 학습 가중치 차이를 얼마나 크게 만들지 결정
- \(\lambda_{\mathrm{anchor}}\): 현재 모델이 초기 정책에서 지나치게 벗어나지 않도록 제한하는 강도
Tactile Distillation (촉각 증류)
SA-RWFM Teacher는 촉각 정보를 고려한 물체 조작을 수행할 수 있지만, 추론 과정에서도 실제 촉각 센서가 필요하므로 촉각 센서가 장착된 하드웨어에서만 사용할 수 있다는 제약이 있다.
촉각 지식을 촉각 하드웨어와 분리하기 위해, Teacher의 촉각 인식 행동을 아키텍처 변경이 없는 기존 VLA Student에 증류하는 오프라인 Tactile Distillation(TD) 프레임워크를 제안한다.
Teacher 정책의 입력 정의
\(\pi_T(o,s_T)\)는 촉각 정보를 조건으로 사용하는 Teacher 정책을 나타낸다.
Teacher는 크게 세 종류의 정보를 사용해 행동을 결정한다.
- 카메라 이미지와 언어 명령
- 로봇의 관절 상태 6차원
- 촉각 센서를 인코딩한 특징 128차원
\(o=(I,\ell)\)은 시각 관측값 \(I\in\mathbb R^{H\times W\times3}\)와 언어 명령 \(\ell\)로 구성된다.
또한 \(s_T=[q;f]\in\mathbb R^{134}\)는 6차원의 관절 상태 \(q\in\mathbb R^6\)와 Dual Tactile Encoder에서 생성한 128차원의 촉각 임베딩 \(f\in\mathbb R^{128}\)을 연결한 것이다.
Flow Matching 기반 행동 시퀀스 예측
Teacher와 Student 모두 Conditional Flow Matching을 이용하여 행동 청크 \(a_{1:H}\in\mathbb R^{H\times d_a}\) 를 모델링하며, 행동 예측 구간은 \(K=50\), 로봇 팔당 관절 차원은 \(d_a=6\)이다.
논문에서 제시한 행동 예측 구간 \(K=50\), 팔당 행동 차원 \(d_a=6\)을 적용하면 한 팔 기준 행동 시퀀스는 다음과 같은 형태다.
즉, 50개 시간 단계에 걸쳐 6차원 관절 행동을 예측한다는 의미.
Offline Teacher Target Generation
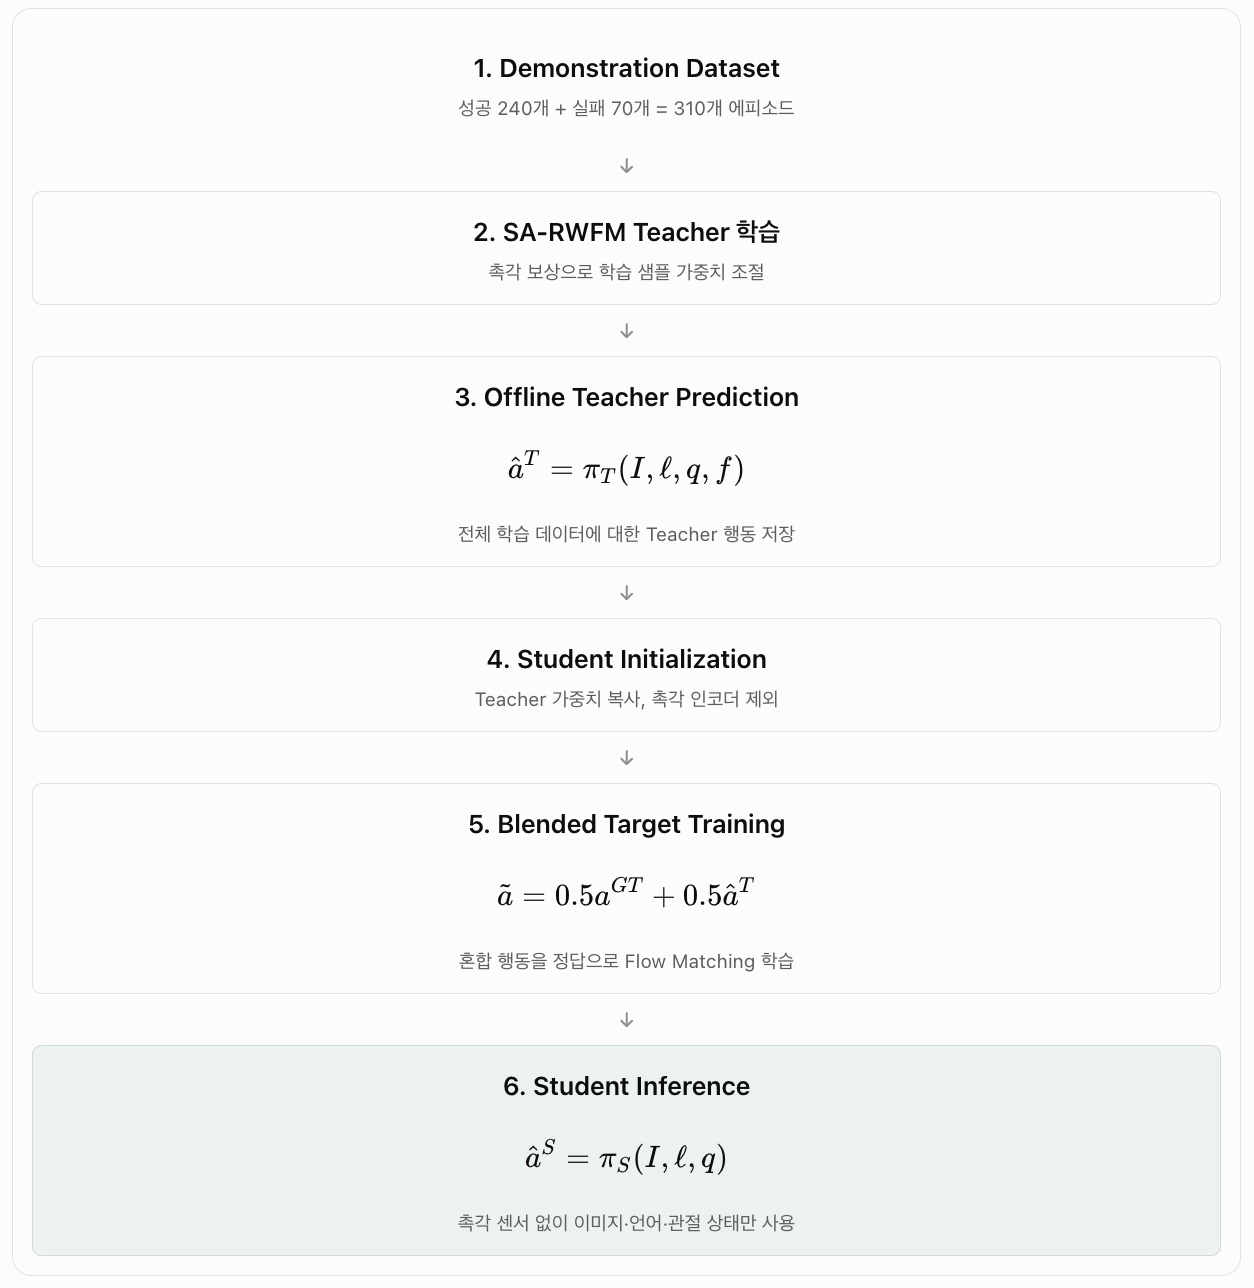
Student 학습 중에 Teacher를 계속 사용할 필요가 없도록 전체 학습 데이터셋에 대한 Teacher의 행동 예측값을 한 번 미리 계산하여, 증류 과정을 완전히 오프라인으로 수행한다.
관측값 \(o_i\)와 전체 상태 \(s_{T,i}\)를 포함하는 각 학습 샘플 \(i\)에 대해 Teacher 추론을 수행하여 예측된 행동 청크를 생성한다.
수식 (21)
- \(a_i^{GT}\): 실제 데이터 수집 과정에서 기록된 행동
- \(\hat a_i^T\): 촉각 정보를 활용해 학습한 Teacher가 예측한 행동
두 행동은 반드시 동일하지 않다.
예를 들어 시연 데이터에서 물체를 강하게 잡았더라도, Teacher는 학습 과정에서 얻은 안전성 정보를 바탕으로 다른 행동을 예측할 수 있다.
전체 학습 데이터에 대한 Teacher의 행동 예측 결과를 저장합니다.
이렇게 저장한 행동은 이후 Student를 학습할 때 정답 행동과 함께 사용된다.
Teacher 예측에 포함된 촉각 지식
Teacher는 앞선 SA-RWFM 학습에서 안전하고 성공적인 행동을 더 강하게 학습했다.
따라서 Teacher가 예측한 행동에는 다음과 같은 정보가 반영되기를 기대할 수 있다.
- 물체를 너무 강하게 잡지 않는 행동
- 미끄러짐을 줄이는 행동
- 작업을 성공적으로 수행하는 행동
논문에서 말하는 핵심은 Teacher가 생성한 행동 자체에 안전 보상 기반 학습 효과가 반영되어 있으므로,
Student는 그 행동을 학습함으로써 촉각 관련 지식을 간접적으로 습득할 수 있다는 것이다.
Teacher Backbone Initialization
Teacher와 Student는 사용하는 입력 정보가 서로 다르다.
- Teacher: 관절 상태 6차원 + 촉각 특징 128차원
- Student: 관절 상태 6차원
Teacher는 관절 상태 \(q\)와 촉각 특징 \(f\)를 Concatenation하여 134차원 벡터로 만든다.
그리고 State Projection을 통해 134차원 입력을 32차원 특징으로 변환한다.
입력 벡터를 행벡터로 표현하면 다음과 같다.
즉, \((1\times134)\times(134\times32) =(1\times32)\)
여기서 \(W_T\)는 관절 상태 6차원과 촉각 특징 128차원을 32차원으로 변환하기 위해 학습된 가중치 행렬이다.
Student는 촉각 센서를 사용하지 않으므로 관절 상태 6차원만 입력받는다.
따라서 Student의 Projection은 다음과 같아야 한다.
즉, \((1\times6)\times(6\times32) =(1\times32)\)
그런데 Teacher의 가중치 행렬은 \(134\times32\)이므로 Student에 그대로 복사할 수 없다.
따라서 Teacher가 학습한 가중치 중 관절 상태 6차원에 해당하는 부분만 추출하여 Student의 초기 가중치로 사용한다.
Teacher의 Projection 가중치는 입력에 따라 두 부분으로 나눌 수 있다.
따라서 Student의 초기 가중치는
가 된다.
Bias는 입력 차원에 의존하지 않고 출력 차원이 동일하게 32차원이므로 그대로 복사한다: \(b_S=b_T\)
그런데 \( z_T=W_qq+W_ff+b \) 이렇게 학습시킨 것이 아님으로 \(W_q와 W_f\)를 독립이라고 하기 어렵다. 따라서 저렇게 자른다는 것이 관절 정보에 해당하는 웨이트만 살린다고 개인적으로는 볼 수 없다고 생각한다.
Blended Target Training
Student는 실제 시연 데이터의 정답 행동과 Teacher가 예측한 행동 사이를 보간하여 생성한 혼합 행동 타깃으로 학습한다.
수식 (24)
- \(a_i^{GT}\): 실제 시연에서 기록된 행동
- \(\hat a_i^T\): Teacher가 예측한 행동
- \(\alpha_d\): 두 행동의 혼합 비율
- \(\tilde a_i\): Student가 학습할 최종 행동 타깃
로봇이 물체를 잡기 위해 그리퍼를 닫는다고 가정하자.
이때 같은 관측 데이터에 대해 다음 두 행동이 있다고 하자.
- 사람이 실제로 수행한 행동: \(a^{GT}=0.8\)
- Teacher가 촉각 정보를 사용해 예측한 행동: \(\hat a^T=0.4\)
HapticVLA는 두 행동을 50:50으로 혼합한다.
즉, Student가 최종적으로 생성하도록 학습할 목표 행동은 0.6이다.
Flow Matching에서는 노이즈 \(x_0\)를 생성한 후, 그 노이즈가 목표 행동 \(\tilde a\)로 변하도록 학습한다.
Flow matching
Flow Matching은 초기 노이즈 \(x_0\)에서 정답 행동 \(a\)까지 이동하는 속도를 예측하도록 모델을 학습하는 방법이다.
Flow Matching에서는 초기 노이즈 \(x_0\)와 정답 행동 \(a\)사이의 경로를 다음과 같이 정의한다.
- \(x_0\): 초기 노이즈
- \(a\): 최종적으로 생성하려는 정답 행동
- \(t\in[0,1]\): 노이즈에서 정답 행동까지 이동하는 과정의 시간
- \(x_t\): 시간 \(t\)에서의 현재 위치
따라서 \(t=0\)이면 \(x_t=x_0\)이고, \(t=1\)이면 \(x_t=a\)가 된다.
현재 위치 \(x_t\)를 시간 \(t\)에 대해 미분하면 다음과 같다.
초기 노이즈에서 정답 행동으로 이동하기 위해 필요한 속도는 \(a-x_0\)이다.
여기서 속도는 로봇의 실제 움직임 속도가 아니라, 노이즈를 행동으로 변환하는 과정에서의 변화율이다.
속도는 위치의 시간에 따른 변화율이므로, 속도를 시간에 대해 적분하면 위치의 변화량을 구할 수 있다.
따라서 초기 노이즈 \(x_0\)에서 시작하여 \(t=0\)부터 \(t=1\)까지 속도를 적분하면 최종 위치를 구할 수 있다.
앞서 계산한 목표 속도 \(a-x_0\)를 대입하면
정답 행동으로 이동하는 속도를 정확하게 학습한다면, 초기 노이즈에서 시작하여 속도를 적분한 최종 위치가 정답 행동이 된다.
HapticVLA 적용
기존 Flow Matching에서는 사람의 실제 시연 행동 \(a^{GT}\)를 목표로 사용한다.
하지만 HapticVLA에서는 사람의 시연 행동과 Teacher가 예측한 행동을 혼합하여 새로운 목표 행동을 정의한다.
따라서 기존 정답 행동 \(a\)를 혼합 행동 \(\tilde a\)로 대체하면
이고, 목표 속도는
가 된다.
Student는 이 목표 속도를 예측하도록 다음 손실함수를 최소화한다.
- \(v_\theta(x_t,t)\): Student가 예측한 속도
- \(\tilde a-x_0\): 혼합 행동으로 이동하기 위한 목표 속도
기존 모방학습: \(x_0\longrightarrow a^{GT}\)
Tactile Distillation: \(x_0\longrightarrow \underbrace{0.5a^{GT}+0.5\hat a^T}_{\tilde a}\)
Ground-truth Anchoring
Teacher가 실제 시연과 크게 다른 행동을 예측하더라도, Student는 실제 시연 행동도 함께 학습하므로 Teacher의 오류에 과도하게 의존하는 위험을 줄일 수 있다.
여기서 Anchoring은 앞에서 소개한 파라미터 기반 Anchor Regularization과 다르다.
- Anchor Regularization: 모델의 파라미터가 초기 가중치에서 크게 달라지지 않도록 제한하는 것
- Ground-truth Anchoring: 행동 타깃에 실제 시연 행동을 포함하여 Teacher 예측에만 의존하지 않도록 함
Teacher Shaping \(\alpha_d\)은 SA-RWFM Teacher가 학습한 촉각 기반 힘 조절 특성을 Student의 행동 학습에 반영한다.
Validation
학습할 때는 Teacher 행동과 실제 시연 행동을 50%씩 혼합한다.
하지만 검증할 때는 실제 시연 행동을 기준으로 평가한다.
전체 학습과정
Hardware
카메라 사양
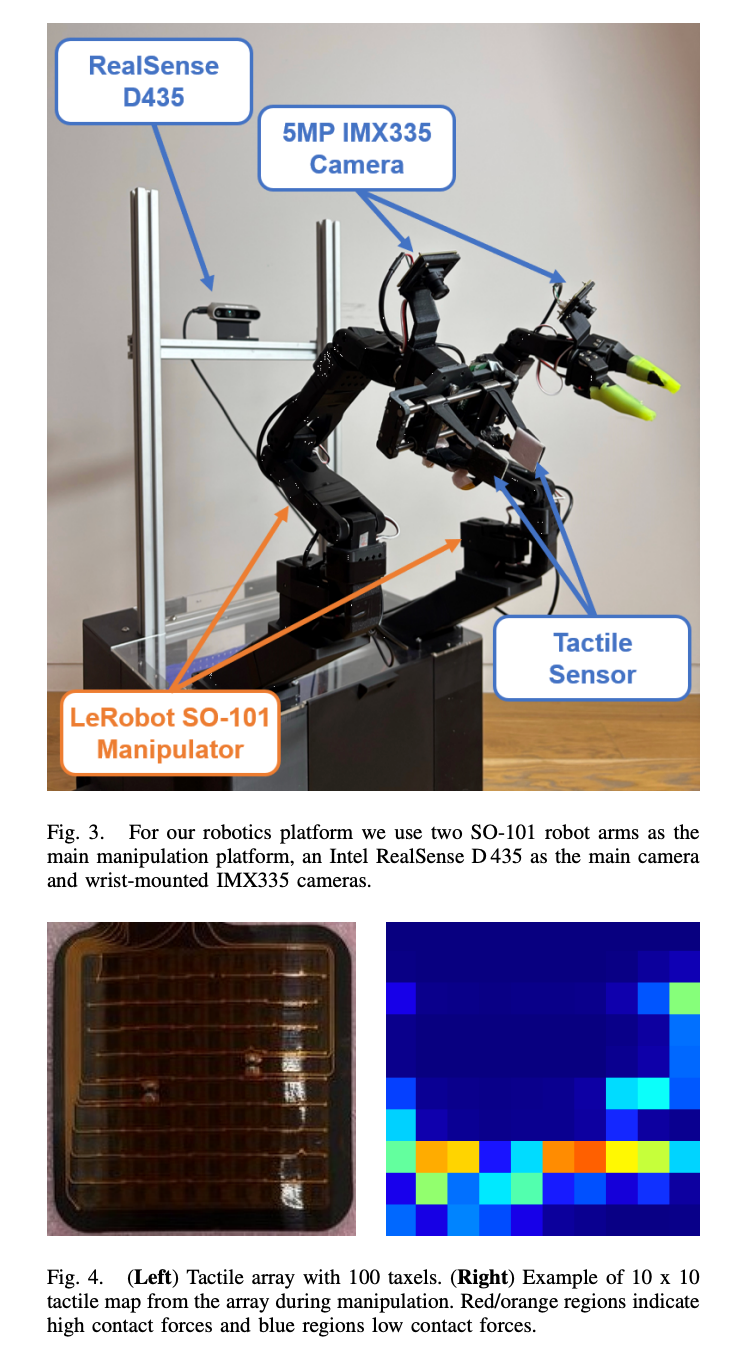
로봇 손목에 IMX335 5MP 카메라를 장착하였다.
영상 해상도
모든 카메라는 640 × 480 픽셀 해상도로 작동한다.
촉각 센서
접촉이 많은 물체 조작을 수행하기 위해, 그림 4와 같이 고밀도 촉각 센서 배열이 장착된 평행 그리퍼를 사용한다.
하나의 전극에는 10 × 10 형태로 배열된 100개의 독립적인 촉각 감지 요소(Taxel)가 있다.
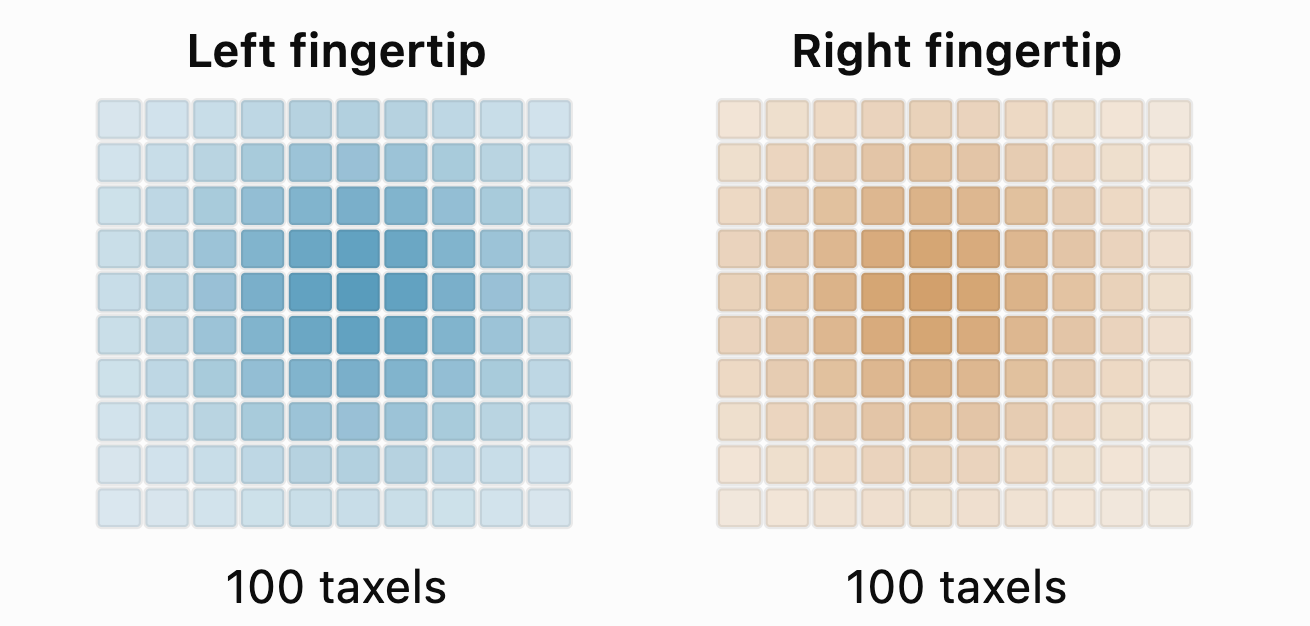
각 측정 지점에서 감지할 수 있는 힘의 범위는 1~9 N이다.
또한 초당 120번 촉각 데이터를 측정하므로, 접촉 힘이 시간에 따라 어떻게 변하는지 관측할 수 있다.
이러한 높은 시간 및 공간 해상도는 힘 분포의 이동, 미끄러짐의 초기 징후, 국소적인 압력 변화 등 접촉 동역학을 정밀하게 모니터링할 수 있도록 하며, 이는 접촉이 많은 상황에서 안전하고 안정적인 조작을 수행하는 데 중요하다.
Edge device
NVIDIA Jetson Orin NX 16GB 엣지 컴퓨터에서 수행된다.
Experiments
실험에서는 두 개의 로봇 팔을 이용합니다. 로봇 팔이 물체를 집거나 옮기는 작업을 수행하면서, 제안한 HapticVLA가 실제 환경에서도 잘 동작하는지 검증한다.
오른쪽 로봇 팔의 그리퍼에는 촉각 센서를 추가했다. 따라서 물체를 잡을 때 얼마나 강한 힘이 가해지는지, 압력이 어디에 집중되는지 측정할 수 있다.
왼쪽 로봇 팔은 7.4V Feetech STS3215 서보모터를 사용하며, 오른쪽 로봇 팔은 정밀한 파지 제어에 필요한 더 큰 토크를 확보하기 위해 12V 버전을 사용한다.
그림 3과 같이 인식 시스템은 세 개의 RGB 영상 스트림으로 구성된다.
Intel RealSense D435 카메라는 외부에서 전체 작업 공간을 관측하는 주요 시점을 제공하며, 각 로봇 팔의 손목에는 IMX335 5MP 카메라가 장착되어 있다.
접촉이 중요한 물체 조작 작업을 수행하기 위해, 그림 4와 같이 고밀도 촉각 센서 배열을 장착한 평행 그리퍼를 사용한다.
Task
HapticVLA의 효과를 평가하기 위해 깨지기 쉬운 정도와 단단함이 서로 다른 물체를 대상으로 세 가지 접촉 중심 조작 작업을 수행하였다.
- Jar: 플라스틱 잼 용기의 높은 변형 가능성을 고려하여 잼 용기를 집어 상자에 넣는다.
- Waffles: 쉽게 부서지는 와플의 특성 때문에 정확한 위치 정렬과 파지 힘 조절이 필요한 와플 집어 옮기기 작업을 수행한다.
- Egg: 달걀 상자를 열고 달걀을 집어 트레이에 옮기는 작업으로, 더욱 정밀한 파지 힘과 그리퍼 폭의 조절이 요구된다.
실험 횟수와 성공 조건
평가를 위해 하나의 모델은 Jar, Waffles, Egg 작업을 각각 20번씩 수행한다.
모델당 총 60번의 평가를 수행하며, 각 작업의 성공률은 다음과 같이 계산한다.
조작한 물체가 완전히 손상되지 않은 상태로 유지되면서 지정된 목표 위치에 놓인 경우 해당 에피소드를 성공으로 판단한다.
각 작업이 가진 고유한 특성을 고려하기 위해 작업별 성공 판정 기준을 추가로 구체화하였다.
Jar
플라스틱 용기는 쉽게 변형되므로, 조작이 끝난 뒤 원래 형태로 완전히 복원되고 눈에 보이는 구조적 손상이 없다면 파지 중 발생한 경미한 표면 변형은 중요하지 않은 것으로 판단하였다.
포장 내부의 와플은 균열이나 부스러짐 없이 완전한 형태를 유지해야 한다.
달걀은 조작이 끝난 후에도 손상되지 않은 상태를 유지해야 하며, 달걀 트레이의 올바른 칸에 놓여야 한다.
Main Results
제안한 HapticVLA를 공정하게 평가하기 위해 세 가지 대표적인 정책인 SmolVLA, X-VLA, VLA-0와 성능을 비교한다.
- SmolVLA와 비교하면 SA-RWFM과 Tactile Distillation을 추가했을 때 얼마나 성능이 개선되는지 확인할 수 있다.
- X-VLA(9억 파라미터)는 비교적 작은 모델 크기와 대규모의 다양한 데이터셋을 통한 사전학습으로 높은 로봇 플랫폼 간 적응 능력을 갖추고 있기 때문에 비교 대상으로 선정하였다.
- VLA-0를 Baseline에 포함함으로써, SO-101 로봇 팔에서 SmolVLA보다 높은 성능을 보였던 더 큰 모델과 비교할 수 있다.
실험에서는 모든 Baseline 모델을 HapticVLA의 미세조정에 사용한 것과 동일한 자체 구축 데이터셋으로 미세조정하였다.
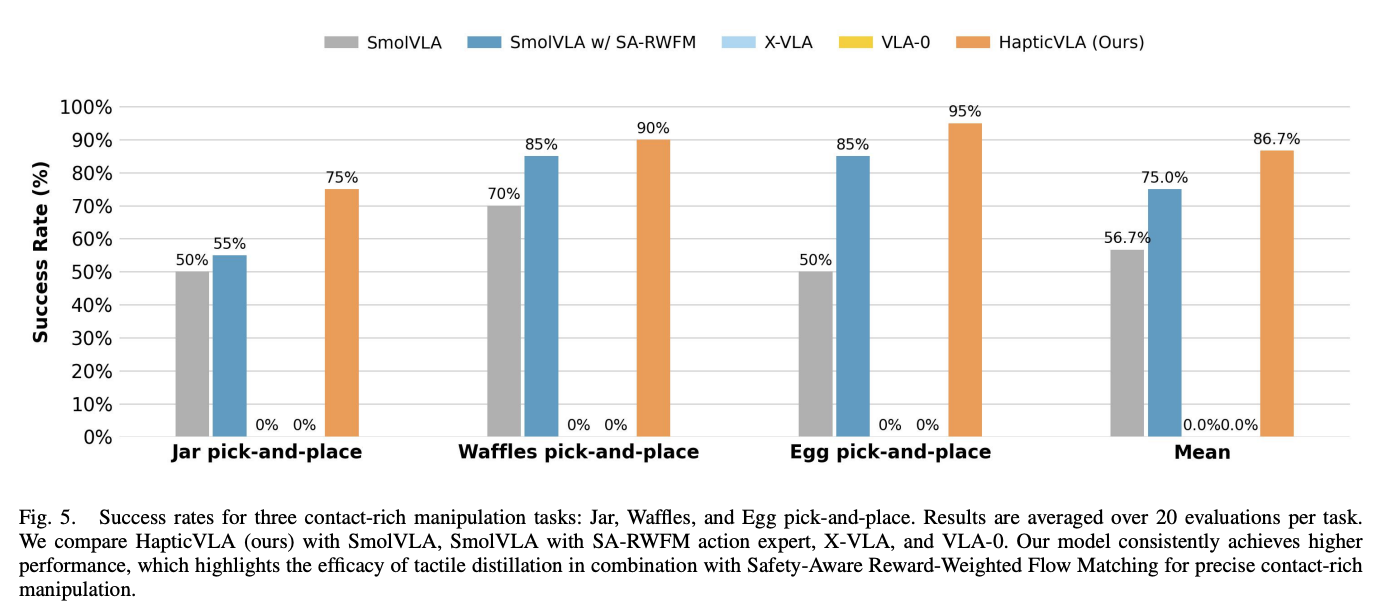
그림 5는 세 가지 접촉 중심 조작 작업에 대한 성공률을 보여준다.
기본 SmolVLA는 와플과 달걀처럼 매우 깨지기 쉬운 물체를 조작하는 데 어려움을 보였지만, HapticVLA는 큰 성능 향상을 나타냈으며 특히 달걀 조작에서는 기본 모델보다 성공률이 절대적으로 45%p 향상되었다.
제안한 SA-RWFM Action Expert를 SmolVLA에 통합한 경우에도 상당한 성능 향상이 나타났으며, 평균 성공률 75%를 달성하고 세 가지 작업 중 두 가지에서 85%의 성공률을 기록하였다.
놀랍게도 X-VLA와 VLA-0가 모두 0%의 성공률을 기록한 것은, 이 모델들이 본 연구의 높은 정밀도와 풍부한 접촉이 요구되는 작업에 충분히 일반화되지 못했음을 시사한다.
Ablation Study
Ablation Study에서는 Tactile Distillation을 적용했을 때와 적용하지 않았을 때의 차이, 그리고 동기 및 비동기 추론의 차이를 분석한다.
같은 작업을 네 가지 설정으로 수행합니다.
여기서 비교하는 주요 조건은 두 가지이다.
- TD 적용 여부: Teacher가 학습한 촉각 기반 행동을 Student에 증류했는가?
- Async 적용 여부: 비동기 방식으로 행동 청크를 추론하는가?
1. Without TD + Async
SA-RWFM으로 학습한 촉각 기반 정책을 사용하지만, Student로 증류하지는 않는다.
따라서 추론할 때 실제 촉각 센서가 필요하며, 행동 생성은 비동기적으로 수행한다.
2. Without TD
앞의 설정과 SA-RWFM Teacher를 촉각 센서와 함께 실행하여 행동을 생성하는 동기 추론 방식을 사용한다.
3. With TD + Async
Tactile Distillation을 적용하고, 비동기 SmolVLA 추론을 사용하는 설정이다.
4. With TD
Tactile Distillation을 적용하고, 동기 SmolVLA 추론을 사용하는 설정이다.
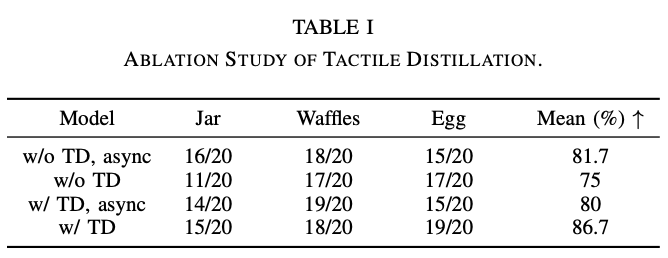
Table I는 Tactile Distillation이 접촉 중심 조작 성능을 상당히 개선하며, SA-RWFM과 TD를 함께 적용한 경우 세 가지 작업에서 가장 높은 평균 성공률을 달성함을 보여준다.
Async 추론의 영향
일반적으로 비동기 추론은 로봇이 행동을 수행하는 동안 다음 행동 청크를 미리 계산하여 추론 대기시간을 줄이기 위한 방법이다.
하지만 접촉이 중요한 작업에서는 빠른 추론뿐 아니라 현재 로봇 상태와 실제로 실행하는 행동의 시간적 일치가 중요하다.
예를 들어 로봇이 달걀을 잡는 상황을 생각해 보면
- 로봇이 달걀을 잡기 시작합니다.
- 다음 행동 청크가 이전 관측을 기준으로 미리 생성됩니다.
- 실제 달걀과 그리퍼 사이의 접촉 상태는 계속 변합니다.
- 미리 생성한 행동이 현재 상태와 맞지 않으면 과도하게 힘을 가하거나 물체를 놓칠 수 있습니다.
이러한 상황에서 동기 추론이 더 유리할 가능성이 있다.
| 비교 | 동기 | 비동기 | 비동기 효과 |
|---|---|---|---|
| TD 없음 (Teacher) | 75.0% | 81.7% | +6.7%p |
| TD 적용 (Student) | 86.7% | 80.0% | −6.7%p |
TD를 적용한 경우에는 비동기 추론이 성능을 낮췄지만, TD가 없는 경우에는 오히려 비동기 추론이 더 높은 성공률을 보였다.
따라서 이 실험만으로 비동기 추론이 항상 불리하다고 결론 내릴 수는 없다.
저자들은 비동기 추론을 사용할 때 관측 시점과 행동 실행 시점이 일치하지 않을 수 있다는 점을 원인으로 제시한다.
Comment