
서론
1. 기존 문제점
- VLA가 정밀한 접촉 작업을 수행하려면 힘(Force) 정보가 중요하지만, 힘-토크 센서는 비용이 높고 하드웨어 복잡성을 증가시킨다.
2. 핵심 아이디어
- 학습 단계에서는 실제 힘 센서 정보를 활용하되, 추론 단계에서는 카메라 영상과 로봇 상태만으로 힘과 관련된 특징을 예측하는 FDM을 학습한다.
- 이를 위해 Force Distillation Module(FDM) 을 도입하여 실제 힘 정보를 잠재 표현인 Force Token으로 증류한다.
3. 제안 방법
- Force Distillation Module(FDM): 학습 가능한 Query Token을 이용해 영상과 로봇 상태에서 힘 관련 특징을 추출하고, 실제 힘 센서로부터 얻은 특징과 유사해지도록 학습한다.
- Force Token 활용: 추론 단계에서 예측한 힘 관련 특징(Force Token)을 VLM에 추가로 입력하여, 실제 힘 센서 없이도 힘을 고려한 로봇 행동을 생성한다.
Query Token은 힘 정보를 찾아내기 위한 학습 가능한 벡터
4. 실험 결과
- 실제 로봇 실험에서 예측 Force Token을 사용하는 FD-VLA가 실제 힘 센서 정보를 직접 사용하는 기존 비교 모델보다 높은 작업 성능을 보였다.
- 추가적인 Force-Vision-State 융합을 통해 접촉 작업에서의 인식 및 행동 강건성을 향상시켰다고 보고한다.
본론
힘 센서를 모델의 입력에 추가하기 위해 대규모 시각-언어 모델을 직접 재학습하는 것은 계산 비용이 매우 크며, 기존에 잘 정렬된 시각-언어 표현을 손상시킬 위험이 있다.
따라서 우리는 사전학습된 VLM을 수정하지 않고 별도의 모듈을 통해 힘 정보를 사용할 수 있도록 한다.
1. 힘 센서의 문제
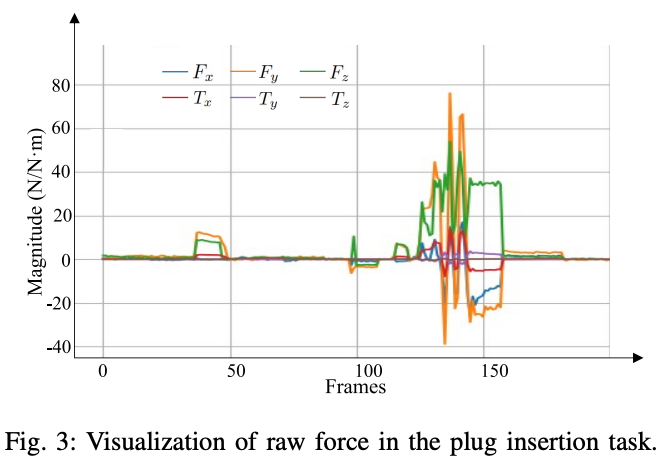
그림 3에서 보이는 것처럼, 실제 환경에서 수집한 힘 센서에는 고주파 잡음과 저주파 드리프트가 포함되는 경우가 많으므로 정책 학습에 적합하지 않을 수 있음을 관찰하였다.
고주파 잡음: 센서의 측정값이 잛은 시간에 빠르게 흔들리는 현상 저주파 드리프트: 센서의 기준값이 시간이 지나면서 천천히 변하는 현상
이런 신호를 그대로 모델에 입력하면, 실제 접촉 힘뿐 아니라 불필요한 잡음까지 학습할 수 있다.
2. FD-VLA
3가지 원칙
이러한 문제를 해결하기 위해 다음 세 가지 설계 원칙에 기반한 FD-VLA를 제안한다.
phase 1
학습 단계에서만 실제 힘 신호를 활용하여 지식 증류를 수행하고, 이를 통해 얻은 예측 힘 토큰을 사용한다.
phase 2
이미지, 언어, 로봇 상태, 예측된 힘 정보를 VLM 전후의 여러 단계에서 연관시켜 처리한다. 이를 통해 기존 VLM의 지식을 보존하면서도 힘을 고려한 행동을 생성하게 한다.
phase 3
실제 배포 환경에서는 힘 센서 없이 추론할 수 있도록 하여, 다양한 로봇 플랫폼에 실용적으로 적용할 수 있게 한다.
3. Framework
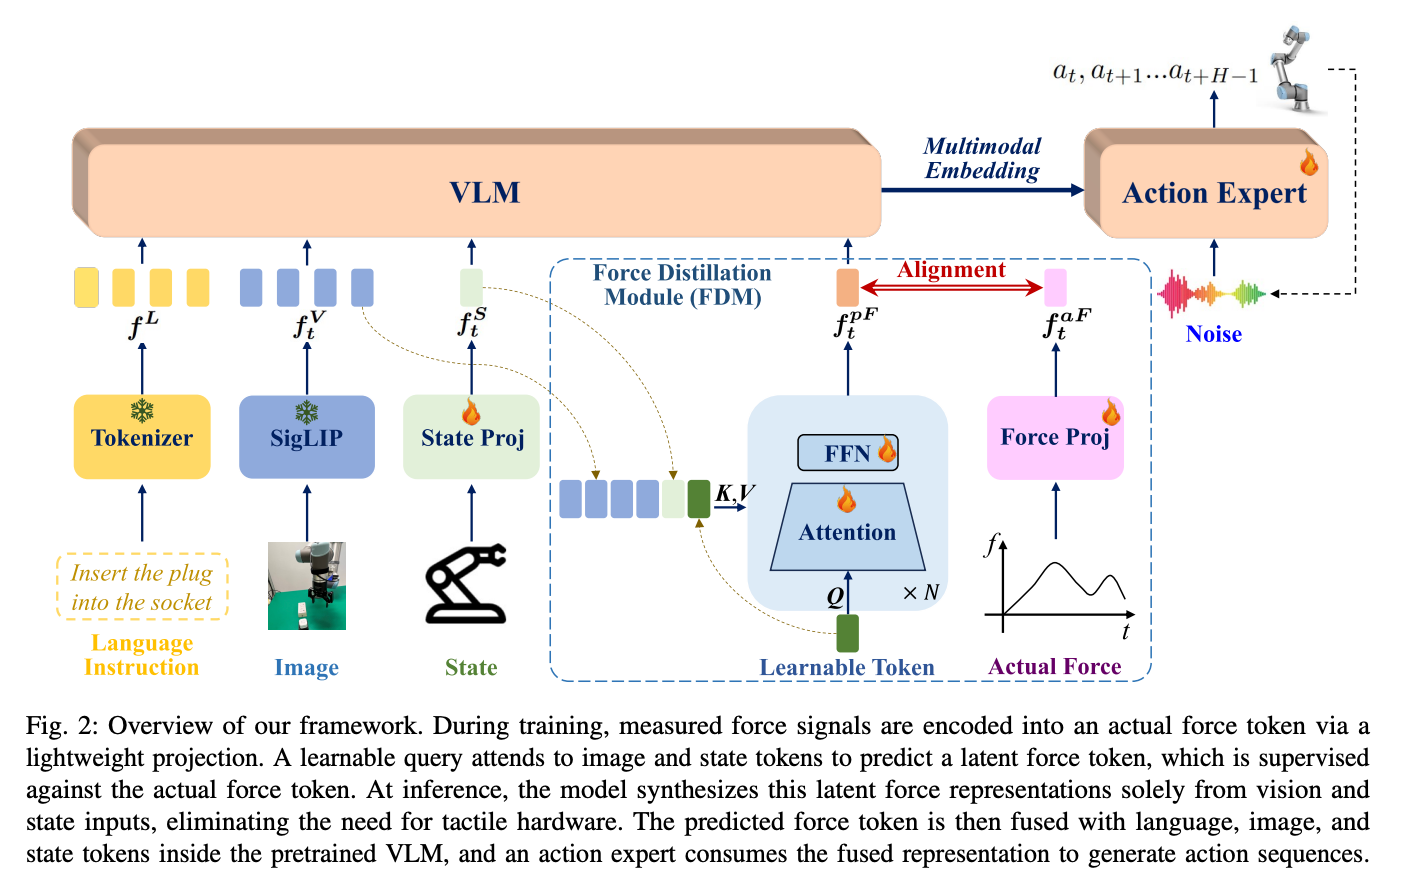
그림 2는 제안하는 FD-VLA의 전체 프레임워크를 보여준다.
Input
입력은
- 언어 명령: \(L\)
- 시각 관측 :\(V_t\)
- 로봇 상태: \(S_t\)
- 힘: \(F_t\)로 구성되며,
- \(t\)는 시간 인덱스를 의미한다.
Encoding
- \(L \) → pretrained Tokenizer → \(f^L \in \mathbb{R}^{N_l\times D}\)
- \(V_t\) → pretrained SigLIP → \(f_t^V \in \mathbb{R}^{N_v\times D}\)
- \(S_t\) → MLP → \(f_t^S \in \mathbb{R}^{N_s\times D}\)
여기서 \(N_v,N_l,N_s\)는 각각 이미지, 언어, 로봇 상태의 토큰 수이고 \(D\)는 각 토큰 벡터의 차원이다.
4. 사전학습 모델
이미 학습된 SmolVLM-2를 활용한다.
이미지 특징을 추출하는 데에는 SigLIP을 사용한다.
5. Force Distillation Module
기존 방식은 힘 센서에서 측정한 데이터를 VLM에 직접 넣었다면, FD-VLA는 이미지와 로봇 상태를 이용해 힘에 관한 특징 벡터를 먼저 예측한 뒤 VLM에 전달한다.
시각 특징 \(f_t^V\), 로봇 상태 특징 \(f_t^S\), 학습 가능한 토큰 \(p\)를 FDM에 입력하여 예측된 잠재 힘 표현 \(f_t^{pF}\)를 생성한다.
6. learnable token의 의미
\(p\)는 FDM이 이미지와 로봇 상태에서 힘 관련 정보를 추출할 때 사용하는 학습 가능한 Query 토큰이다.
- Query Weight: 지금 입력으로 부터 어떤 것을 내가 봐야하는가?
- Key Weight: 지금 입력의 특징을 잘 분해해서 Query와 내적했을 때 값이 커져 원하는 정보를 쉽게 가져갈 수 있도록 표현하는 역할
- Value weight: Attention score로부터 강조되는 토큰이 최종 출력에 유용한 형태로 가공되도록 하는 역할
처음에는 학습되지 않은 벡터이지만, 학습 과정에서 실제 힘과 관련된 특징을 잘 추출하도록 값이 갱신된다.
이미지와 로봇 상태 특징을 참조하여 힘 토큰을 생성한다.
7. 힘 예측
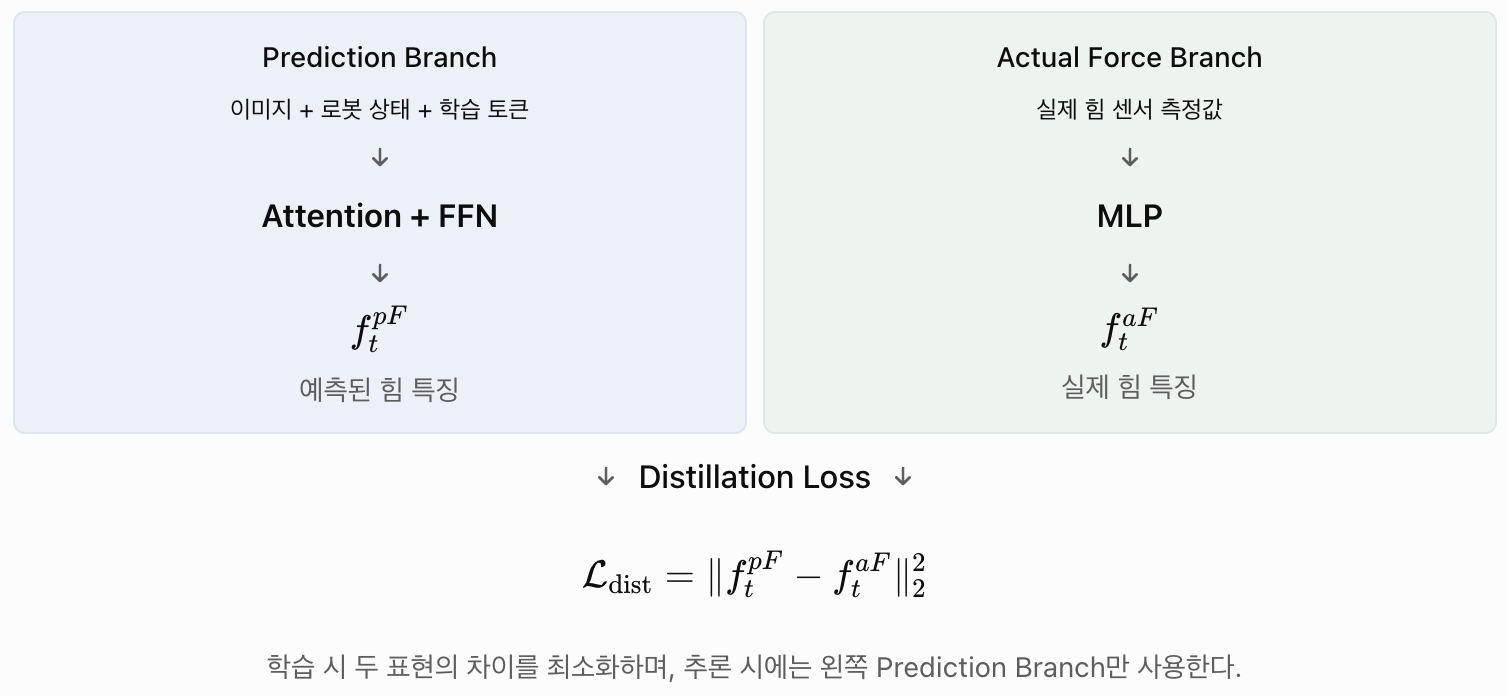
학습할 때는 실제 힘 센서 측정값을 MLP에 통과시켜 만든 특징 벡터를 정답으로 활용한다.
FDM은 이미지와 로봇 상태로부터 예측한 힘 특징이 실제 힘 특징과 비슷해지도록 학습한다.
하지만 학습이 끝나면 실제 힘 센서는 더 이상 사용하지 않는다.
여기서 실제 힘 센서를 feature 벡터로 바꾼 것을 시간을 고려해 기호를 표현하면 \(f_t^{aF}\)이다.
실제 학습에 사용하는 증류 손실은 다음과 같다. (L2거리로 정의)
8. 모달리티 결합
VLM으로부터 생성한 이미지 토큰, 언어 토큰, 로봇 상태 토큰, 예측 힘 토큰을 하나의 토큰 시퀀스로 연결한다.
각 토큰의 차원이 \(D\)로 동일하므로 다음과 같이 결합할 수 있다.
- 여기서 토큰 1개는 learnable 힘 토큰이다.
VLM 내부에서는 사전학습된 시각-언어 지식을 보존하기 위해 VLM의 파라미터를 동결한다.
로봇 상태 토큰과 예측 힘 토큰이 시각 및 언어 정보 흐름에 간섭하지 않도록 Attention Masking 전략을 적용한다.
논문에서는 이를 다음과 같이 두 가지로 구분해서 생각한다.
| 구분 | 포함된 정보 | 역할 |
|---|---|---|
| Perceptual Stream | 이미지, 언어 | 현재 상황과 명령 이해 |
| Control Stream | 로봇 상태, 예측 힘 | 제어에 필요한 물리 정보 처리 |
- \(X^{\mathrm{percept}}=[f_t^V,f^L]\)
- \(X^{\mathrm{control}}=[f_t^S,f_t^{pF}]\)
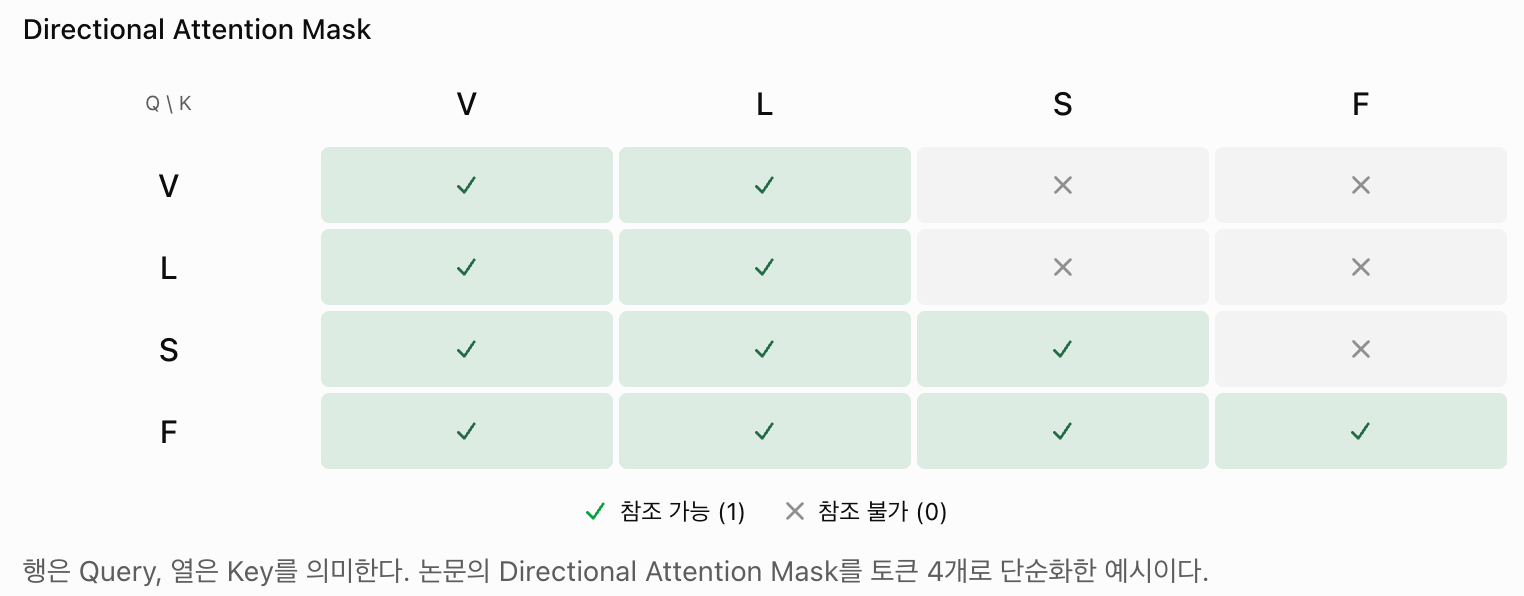
예를 들어 이미지 토큰 \(V\)는 이미지와 언어는 참조할 수 있지만 로봇 상태나 힘 토큰은 참조하지 못한다.
반면 예측 힘 토큰 \(F\)는 이미지, 언어, 로봇 상태 및 자신의 토큰을 참조할 수 있다.
따라서 기존 시각-언어 표현력은 유지하면서, 제어에 필요한 토큰에는 여러 모달리티의 정보를 융합할 수 있다.
그래서 기존 VLM이 이미지와 언어를 처리할 때는 상태와 힘 토큰의 영향을 받지 않도록 한다.
기존 VLM은 이미지·언어에 대해서는 좋은 표현력을 가지고 있지만, 로봇 상태 및 힘과의 관계는 학습하지 않았으므로 새로운 토큰을 넣는 것만으로 해당 정보를 효과적으로 처리한다고 보장할 수 없긴하다..
최종 행동을 결정하는 Action Expert는 이미지, 언어, 로봇 상태, 힘 정보를 모두 활용할 수 있다.
9. Action Expert를 이용한 행동 생성
앞 단계의 VLM은 이미지, 언어, 상태, 힘 정보를 처리하여 특징 벡터를 출력한다.
하지만 이 특징 자체가 로봇의 행동 명령은 아니다.
따라서 Action Expert라는 별도 모델을 사용하여 이러한 특징을 실제 로봇이 수행해야 할 행동으로 변환한다.
이때 Conditional Flow Matching은 초기 노이즈로부터 목표 행동 시퀀스를 생성하는 과정을 학습하는 방법이다.
즉, VLM은 상황에 관한 특징을 제공하고, Action Expert는 그 특징을 조건으로 로봇 행동을 생성한다.
결합된 멀티모달 특징 \(f_t^{fs}\)를 VLM에 통과시킨 뒤, 그 결과를 Action Expert 정책 \(\pi_\theta\)에 입력하여 현재 시점부터 향후 \(H\)개 시점까지의 행동 시퀀스를 생성한다.
여기서 \(\pi_\theta(\cdot)\)는 Action Expert 정책 헤드를 나타낸다.
예를 들어 \(H=4\)라면, 한 번의 추론으로 다음 4개 행동을 예측한다: \([a_t,a_{t+1},a_{t+2},a_{t+3}]\)
이를 Action Chunking이라고 한다.
현재 행동 하나만 예측하는 대신, 앞으로 수행할 여러 행동을 한 번에 예측하는 방식이다.
이러한 구조를 통해 사전학습된 VLM의 풍부한 의미적 표현 능력을 활용하는 동시에, 힘 증류를 통해 안정적이고 작업에 관련된 물리적 추론 능력을 추가함으로써, 추가적인 센서 없이도 강건성과 효율성을 모두 확보할 수 있다.
10. 센서 잡음에 대한 강건성
실제 힘 센서 데이터에는 잡음이 포함될 수 있다. FDM은 해당 센서 값을 그대로 사용하는 대신 이미지와 로봇 상태에서 힘 특징을 예측하므로, 반복적으로 나타나는 의미 있는 접촉 정보에 집중할 수 있다.
11. Query, Key, Value 정의
논문의 수식은 다음과 같다.
- Query: 힘을 예측하려는 Learnable Token \(p\)하나
- Key: Learnable Token + 이미지 토큰 + 로봇 상태 토큰 전체
- Value: 위 전체 토큰에서 생성한 특징 벡터
그럼 차원이 왜 저렇게 되는지 봐보자.
예를들어 다음과 같은 네 개의 토큰이 있다고 \(D=4\)라고 가정하자.
- \(p\): 힘 예측용 Learnable Token
- \(v_1\): 이미지 첫 번째 토큰
- \(v_2\): 이미지 두 번째 토큰
- \(s_1\): 로봇 상태 토큰
(1) Query 생성
여기서는 전체 토큰이 아니라 Learnable Token \(p\)만 사용한다.
이므로 (\(W_Q\)의 차원은 2라고 가정)
따라서 Query는 1개이고, 그 특징 차원은 2이다.
(2) Key 생성
Key는 네 개의 토큰 전체에서 생성한다.
Key는 4개이고 그 특징 차원은 2이다.
(3) Value 생성
Value 역시 네 개의 토큰 전체에서 생성한다.
Value는 4개이고 그 특징 차원은 2이다.
| 구분 | 행렬 크기 | 의미 |
|---|---|---|
| Query | \(1\times2\) | 힘 토큰 1개 |
| Key | \(4\times2\) | 전체 토큰 4개 |
| Value | \(4\times2\) | 전체 토큰 4개 |
Query와 Key를 곱해 Attention Score를 구한다
행렬 차원을 대입해서 Attention score를 구하면
\(1\times4\) 로 나온다.
Query가 하나이므로, 그 Query가 네 개의 Key를 각각 비교한 결과가 나오는 것.
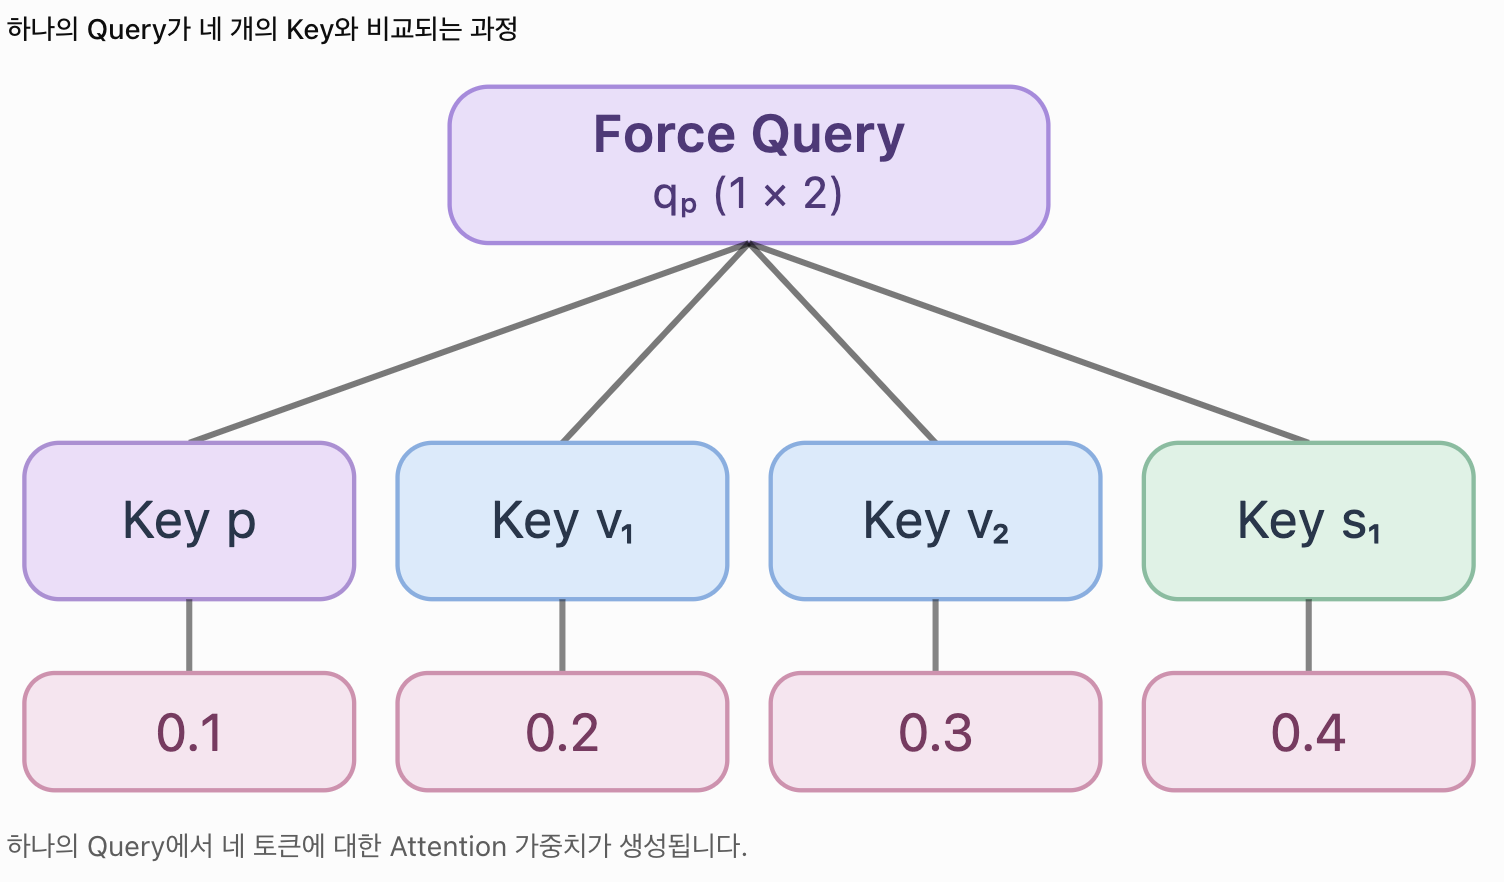
예를 들어 Score가 Softmax를 통과한 후,
로 계산되었다고 하자.
그러면 힘 예측 토큰은 네 개 토큰 각각에 이러한 가중치를 부여하게 된다.
예를들어
라고 하면, (\(\sqrt 2\)는 \(d_k=\)2 차원이라서)
Softmax 결과는,
가 된다.
앞에서 계산한 Attention 가중치를 Value에 곱하면: \( Z=\alpha V \)
Example)
행렬곱을 계산하면,
이를 벡터별로 풀어서 쓰면,
원래 네 개의 토큰에 들어 있던 정보가 Query가 결정한 가중치에 따라 하나의 특징 벡터로 합쳐졌다.
즉, 출력 토큰이 1개인(차원은 \(d_k=\)2 였기 때문) 이유는 Query가 하나이기 때문이다.
그런데 Head가 H개면 어떻게 될까?
Multi-Head Attention에서는 각각의 Head가 서로 다른 가중치 행렬을 사용한다.
그리고 각 Head에서 별도로 계산한다.
예를 들어 Head가 3개이고 각 Head의 Value 차원이 2(\(d_k=2\))라면,
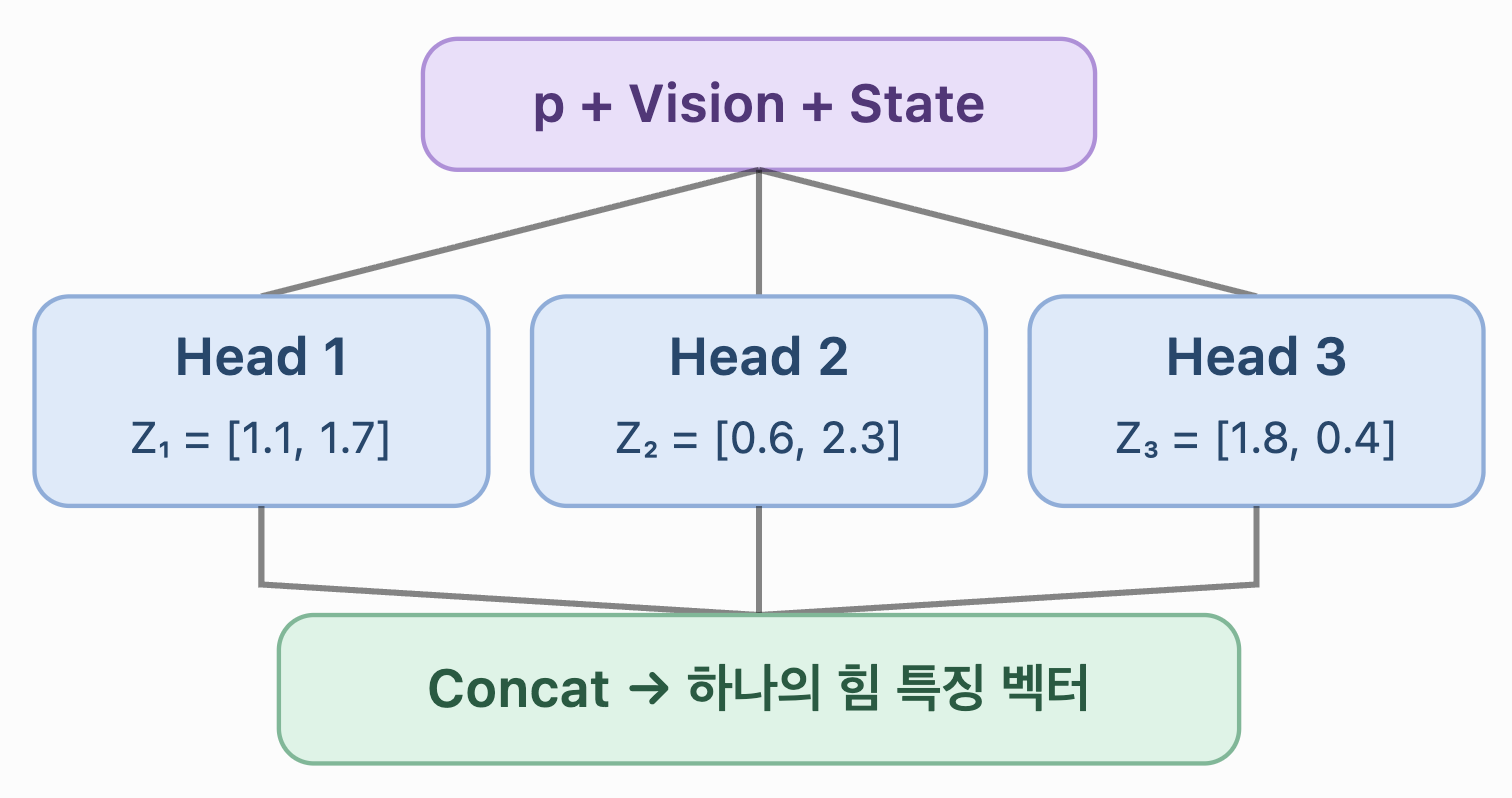
각 Head에서 다음처럼 서로 다른 결과가 나올 수 있다.
이것들을 행렬로 모으면,
따라서 \(Z\in\mathbb R^{H\times d_k}\) 가 된다.
중요한 것은 Head가 3개라고 해서 최종 출력 토큰이 3개라는 뜻이 아니다.
여기서는 각 Head가 하나의 출력 벡터를 만들었고, 일반적인 Multi-Head Attention에서는 이를 이어 붙였기 때문이다.
그리고 일반적인 Multi-Head Attention에서는 이를 이어 붙인다.(concat)
이후 출력 Projection \(W_O\)로 변환하여 하나의 힘 예측용 토큰 표현을 만든다.
각 Attention Head의 출력 \(Z_1,\ldots,Z_H\)를 결합하고 출력 투영 행렬 \(W_O\)를 적용한 뒤, 원래 학습 가능한 토큰 \(p\)를 더한다. (residual connection 때문)
(일반적으로는 residual connection으로 입력토큰 [X:시각, 언어, 상태, 힘 토큰]이 되지만 여기서는 힘 토큰만 더 해준다.)
이후 Layer Normalization과 Feed-Forward Network를 통과시켜 최종 예측 힘 토큰 \(f_t^{pF}\)를 생성한다.
기존의 Self-Attention과 다른 점은?
일반적인 Self-Attention에서는 입력 토큰이 4개라면 출력도 4개가 된다.
하지만 이번 수식에서는 출력이 하나이다.
| 구분 | 일반적인 Self-Attention | 현재 FDM 수식 |
|---|---|---|
| Query | 모든 토큰 4개 | 힘 토큰 1개 |
| Key | 모든 토큰 4개 | 모든 토큰 4개 |
| Value | 모든 토큰 4개 | 모든 토큰 4개 |
| Attention 크기 (Head별) | \(4\times4\) | \(1\times4\) |
| 출력 토큰 수 | 4개 | 1개 |
즉, FDM은 힘 토큰에 해당하는 Query만 사용해 필요한 정보를 집약한 출력을 얻는 형태이다.
여기서
로 해석할 수 있다..
예를 들어,
- \(p\): 학습을 통해 얻은 힘 예측용 기본 표현
- \(\Delta p_t\): 현재 물체의 변형, 로봇의 관절 상태 등에서 Attention으로 수집한 정보
즉, 매 순간 변하지 않는 \(p\)에 현재 상황에 따라 달라지는 \(\Delta p_t\)를 더해 힘 예측용 표현을 업데이트하는 것이다.
다만 \(p\)가 실제 힘의 평균값이나 기준 힘을 의미한다는 뜻은 아니며 학습된 특징 벡터일 뿐이다.
왜 Key와 Value에도 p를 포함할까?
힘 토큰 \(p\)를 Key와 Value에도 포함하면, 모델은 이미지·로봇 상태에서 얻은 정보뿐 아니라 학습된 힘 토큰 자체의 정보도 Attention을 통해 선택적으로 결합할 수 있기 때문에 포함한다.
핵심 방법정리
| 구분 | FDM | Attention Masking |
|---|---|---|
| 목적 | 예측 힘 토큰 생성 | 기존 VLM 보호 및 정보 융합 |
| 입력 | 학습 토큰, 이미지, 상태 | 이미지, 언어, 상태, 예측 힘 |
| 핵심 방법 | Single-Query Multi-Head Attention | Directional Masked Self-Attention |
Loss
FD-VLA는 두 가지 목표를 동시에 학습한다.
첫 번째는 로봇이 전문가처럼 올바른 행동을 생성하는 것이다.
두 번째는 이미지와 로봇 상태만으로 실제 힘과 관련된 특징을 예측하는 것이다.
따라서 행동 예측 성능만 학습하는 것이 아니라, 힘에 관한 정보도 학습하도록 별도의 손실을 추가한다.
위에서 구했던 \(\mathcal L_{\mathrm{dist}}\)를 대입하면
\(\lambda\)는 힘 지도학습의 영향력을 조절하는 가중치이다.
Experiments
앞에서는 FD-VLA의 구조와 학습 방법을 설명했다. 이제 실제 로봇을 이용해 기존 모델보다 성능이 좋은지, 그리고 힘 센서 없이도 작업을 수행할 수 있는지를 검증한다.
Setup
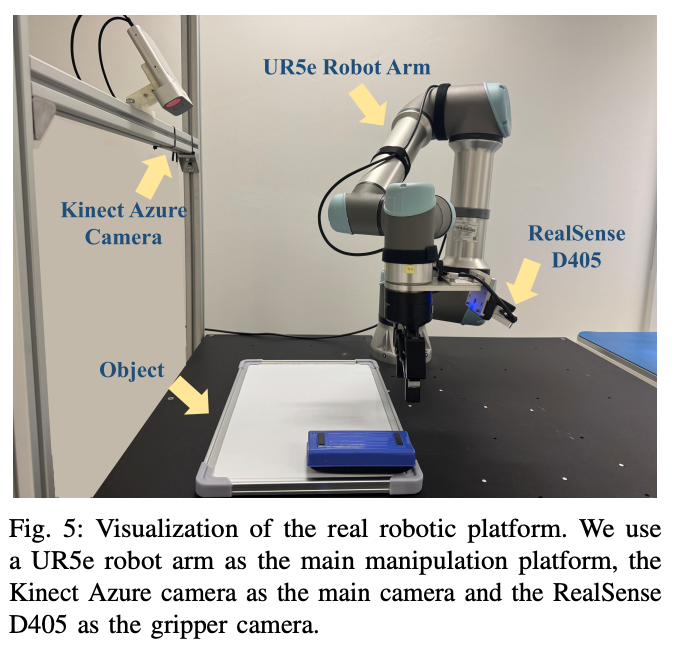
실험에서는 UR5e 로봇팔을 주요 조작 플랫폼으로 사용하고, Azure Kinect 카메라로 전체 장면의 RGB 이미지를 획득하며, RealSense D405 카메라로 로봇 그리퍼 주변의 RGB 이미지를 획득한다.
Task
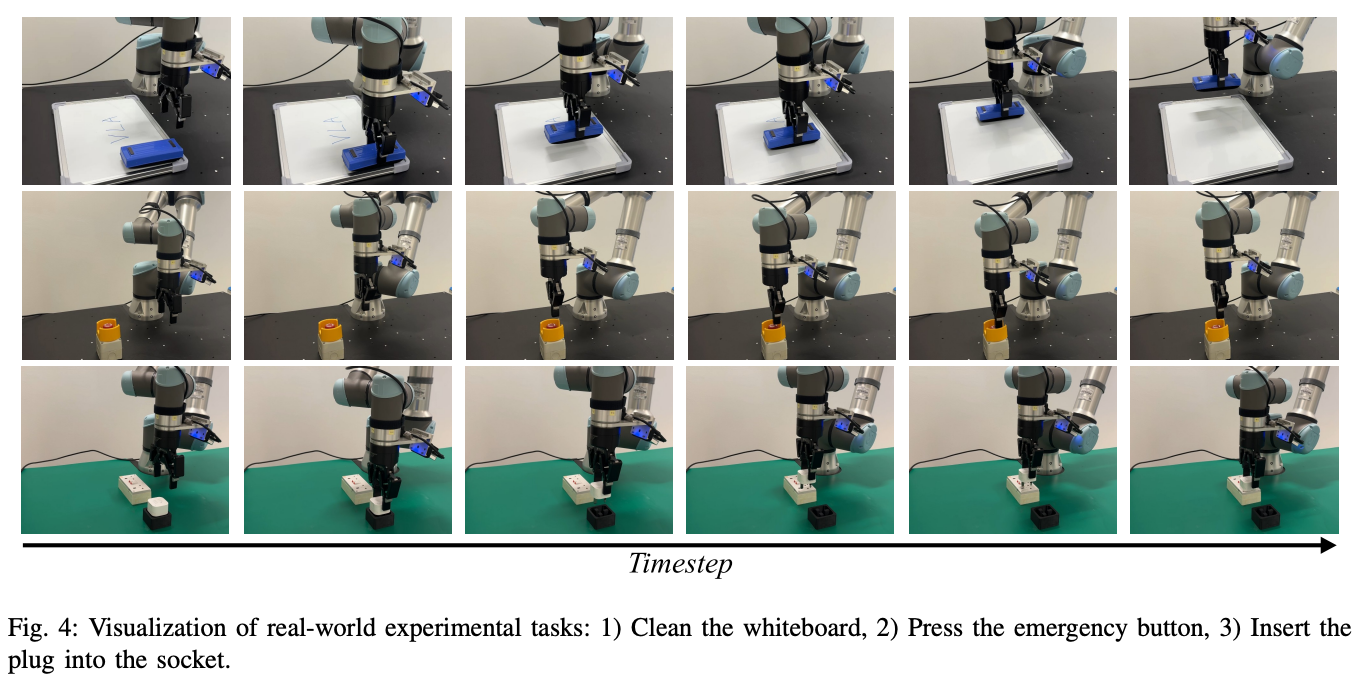
FD-VLA의 효과를 평가하기 위해, 접촉이 중요한 세 가지 서로 다른 로봇 조작 작업에 대한 실험을 수행하였다.
지우개가 화이트보드에 계속 접촉하도록 유지하면서 움직여야 한다. 접촉이 부족하면 글씨가 지워지지 않고, 힘이 과도하면 불필요한 압력이 발생할 수 있다.
- 화이트보드 지우기 작업은 보드에 보이는 모든 표시가 완전히 지워진 경우에만 성공으로 판정하였다.
버튼의 위치를 정확히 찾아 누르는 것뿐 아니라 스프링 저항을 이겨낼 만큼 충분한 힘을 가해야 한다.
- 비상 버튼 누르기 작업은 버튼이 끝까지 눌리고, 다시 튀어 오르지 않은 상태로 유지되어야 성공으로 판정하였다.
플러그와 소켓의 위치 및 방향을 정확히 맞추어야 하며, 삽입 과정에서 발생하는 접촉 저항을 고려해 힘을 조절해야 한다.
- 플러그 삽입 작업은 플러그가 소켓 내부에 완전히 삽입되어 올바른 정렬과 삽입이 이루어진 경우 성공으로 판정하였다.
실제 힘 데이터 수집
데이터 수집 과정에서는 사람이 SpaceMouse라는 3D 입력 장치를 이용해 UR5e 로봇팔을 직접 조작하여 다양한 작업을 수행하도록 한다.
이 과정에서 로봇이 관측한 이미지, 로봇의 상태, 실제 힘 센서 측정값, 사람이 수행한 행동을 함께 기록한다.
수집한 데이터는 두 가지 목적으로 사용된다.
- 힘 예측 학습: UR5e에 내장된 힘 센서의 측정값을 FDM의 Actual Force Branch에 입력하여, 힘을 예측하는 Prediction Branch의 지도 신호로 활용한다.
- 모방학습: 사람이 로봇을 조작하며 수행한 행동을 정답으로 사용하여, 로봇이 동일한 작업을 스스로 수행하도록 학습한다.
각 작업에 대해 50개의 전문가 시연 데이터를 수집하였다. (총 150개)
평가
각 작업에서 학습에 사용하는 시연 데이터는 50개이고, 학습이 끝난 모델을 실제 로봇에서 30회씩 테스트했다.
성공률은 다음과 같이 계산한다.
예를 들어 30번 중 21번 성공했다면 성공률은 70%이다.
FD-VLA의 성능을 확인하기 위해 기존 로봇 행동 생성 모델들(DP3, π₀, SmolVLA)과 비교했다.
- DP3는 제안 모델과 비슷한 파라미터 규모를 가지는 Diffusion 기반 제어 프레임워크로, 정밀한 이동 궤적 생성에 뛰어난 비교 모델로 선정하였다.
- π₀는 훨씬 큰 모델 용량과 강력한 언어 조건부 제어 능력을 가진 최신 VLA 모델의 대표적인 사례
- FD-VLA는 SmolVLA를 기반으로 FDM 등을 추가한 구조다. SmolVLA와 비교하면 힘 증류 및 관련 구조를 추가했을 때 성능이 얼마나 달라지는지 확인할 수 있다.
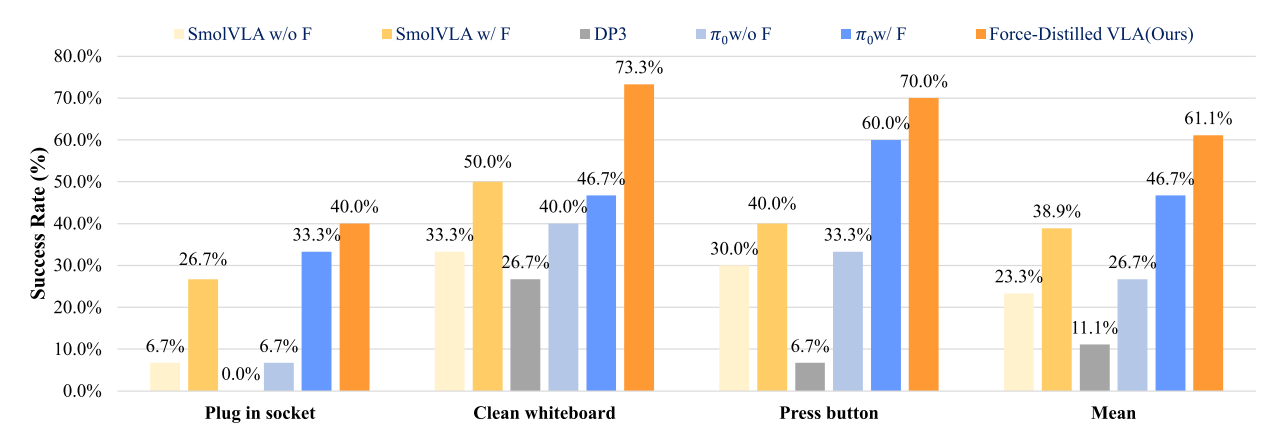
그림 6은 접촉이 중요한 세 가지 로봇 조작 작업에 대한 성공률을 보여준다.
화이트보드 지우기 작업에서 FD-VLA는 73.3%의 성공률을 달성하였으며, 이는 다른 모든 비교 모델보다 최소 23.3%p 높은 결과이다.
모든 작업에서 FD-VLA는 평균 성공률 61.1%로 가장 높은 성능을 달성했으며, 힘 인코딩이 없는 SmolVLA(23.3%), DP3(11.1%)뿐만 아니라 약 10배 많은 파라미터를 가진 π₀보다도 높은 성능을 보였다.
실제 힘을 직접 입력한 모델과 비교
실제 힘 센서를 추가한 결과, SmolVLA는 15.6%p, π₀는 20.0%p 성능이 향상되었다.
이는 힘 정보가 로봇 조작에 유용하다는 것을 보여준다.
하지만 FD-VLA는 실제 힘을 직접 입력한 두 모델보다도 높은 61.1%의 성공률을 기록했다.
원시 힘 입력의 한계
실제 힘 센서 데이터를 추가한다고 해서 모델이 그 정보를 반드시 효과적으로 활용하는 것은 아니다.
센서 데이터에 잡음이 포함되어 있다면 모델은 유용한 접촉 정보와 불필요한 잡음을 함께 처리해야 한다.
저자들은 실제 힘 센서 값에 포함된 잡음이나 불필요한 정보 때문에 정책이 힘 정보를 효과적으로 활용하기 어려웠을 것이라고 해석한다.
반면 Learnable Token을 통해 생성한 특징은 이미지 및 로봇 상태를 조건으로 만들어지기 때문에, 작업에 필요한 정보에 집중할 가능성이 있다.
Ablation Study
저자들은 FD-VLA의 높은 성능이 정말 FDM과 Learnable Token 덕분인지 확인하려고 한다.
이를 위해 실제 힘 센서를 직접 사용하는 방식과, 이미지 및 로봇 상태로부터 힘 토큰을 예측하는 방식을 비교한다.
본 실험에서는 접촉이 중요한 세 가지 작업에 대해 세 종류의 모델을 비교하였으며, 각 모델은 기존 주요 실험과 동일한 초기화 조건, 시간 제한, 성공 기준 아래에서 각각 30회의 독립적인 Rollout으로 평가하였다.
1. Without FDM
FDM의 Attention 구조를 제거하고, 힘 센서로부터 측정한 값을 MLP로 변환하여 VLA에 사용한다.
2. FDM with Force Token
이 모델에서는 FDM의 Attention 구조는 그대로 유지한다.
하지만 원래 Query로 사용하던 Learnable Token \(p\)대신 실제 힘 센서에서 얻은 특징 \(f_t^{aF}\)를 사용한다.
기존 FD-VLA의 예측 방식은 다음과 같다.
반면 두 번째 방식은 개념적으로 다음과 같이 나타낼 수 있다.
실제 힘 정보를 Query로 사용하여 이미지와 로봇 상태의 정보를 융합한다는 것이다.
3. FDM with Learnable Token
세 번째 모델은 학습 가능한 토큰을 사용하는 제안 방법, 즉 FD-VLA이다.
Table I — Ablation Study 실험 결과
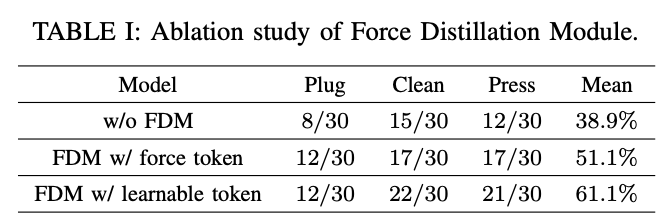
여기서 두 가지를 확인할 수 있다.
- FDM을 추가하면 평균 성공률이 38.9%에서 51.1%로 12.2%p 증가한다.
- 실제 힘 토큰 대신 Learnable Token을 사용하면 성공률이 51.1%에서 61.1%로 10.0%p 증가한다.
특히 플러그 삽입 작업에서는 두 FDM 방식 모두 12/30으로 동일하다. Learnable Token의 추가적인 성능 향상은 화이트보드 지우기와 버튼 누르기에서 나타났다.
FDM을 추가했을 때의 효과
단순히 힘 센서 데이터를 MLP로 변환해서 사용하는 것보다, FDM의 Attention을 통해 이미지와 로봇 상태 정보를 함께 융합하는 것이 더 높은 성능을 나타냈다.
저자들은 FDM의 Early Fusion, 즉 VLM에 입력하기 전에 여러 모달리티를 먼저 융합하는 과정이 효과적이라고 해석한다.
Model Generalization (모델 일반화 성능)
로봇이 학습할 때는 흰색 배경에서 작업했지만, 실제 환경에서는 배경 색상이나 조명이 달라질 수 있다.
이때 학습 환경과 다른 이미지가 입력되더라도 기존 작업을 정상적으로 수행할 수 있다면 시각적 일반화 성능이 좋다고 볼 수 있다.
이러한 문제를 검증하기 위해 두 가지 대표적인 시나리오를 사용한다.
첫째, 학습 환경과 배치 및 텍스처가 다른 새로운 배경(Novel Background)이고,
둘째, 조명과 대비 및 색상 분포가 변화하는 시각적 교란(Visual Perturbations)이다.
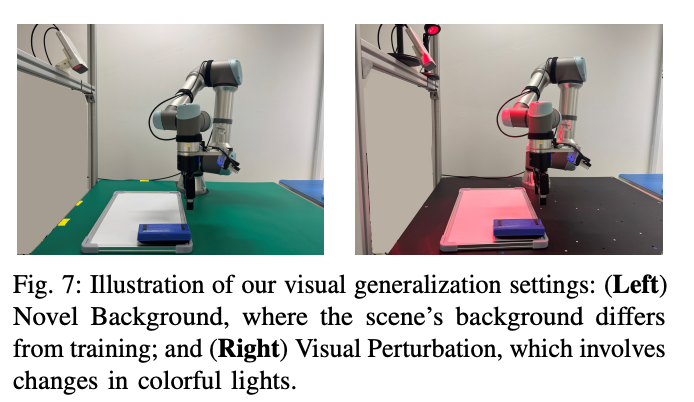
그림 7에서 보이는 것처럼 이러한 실험 조건은 실제 환경에서 흔히 발생하는 문제를 반영하며, 로봇이 학습 데이터의 제한된 시각적 환경을 벗어나서도 동작할 수 있어야 함을 보여준다.
저자들은 배경이나 조명이 달라져도 FD-VLA가 작업을 수행하는 모습을 관찰했다고 설명한다.
다만 저자들은 성능 저하가 크지 않다고 설명할 뿐, 구체적인 성공률이나 감소 폭은 제시하지 않았다.
따라서 이는 FD-VLA가 배경의 색상이나 조명 같은 표면적인 특징보다, 실제 작업 수행에 필요한 물체의 구조와 상태를 학습했을 가능성을 보여준다는 의미다.
Conclusions
향후에는 본 프레임워크를 다중 로봇 협업으로 확장하고, 확장 가능하면서 범용적인 조작 시스템으로 발전시키고자 한다.
Comment