
서론
- Vitjan Zavrtanik, Matej Kristan, Danijel Skočaj; Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2021, pp. 1-10.
DRÆM – A Discriminatively Trained Reconstruction Embedding for Surface Anomaly Detection. - 전체 번역: DRÆM – A discriminatively trained reconstruction embedding for surface anomaly detection 논문 전체 번역
- https://arxiv.org/pdf/2108.07610.pdf
목차
Overall
- 기존에는 정상 이미지만을 학습하여 정상 이미지가 입력으로 들어왔을 때 유사한 이미지를 생성하는 것을 목표로하였다.
- 따라서 정상 이미지에 대해서는 잘 생성하지만 비정상 이미지에 대해서는 제대로 생성하지 못할 것이다 라는 컨샙으로 네트워크를 설계하였다.
- 그러나 이를 surface anomaly detection에 적용하였더니 이미지의 비정상적인 부분이 정교할 수록 학습 데이터의 분포에 가까운 아주 유사한 이미지 라는 것이다.
- 따라서 비정상 이미지도 정상 이미지처럼 생성해 낸다는 문제가 발생했다.
- 이러한 문제를 해결하기 위해 정상 이미지를 비정상 이미지로 만들기 위해 합성 기법을 사용해 모델이 비정상 이미지에 대해서도 학습할 수 있게 하였으나, 이번에는 합성 이미지에 overfiting이 되어 실제 비정상 이미지에 대해서는 잘 구분하지 못한다는 것이다.
- 본 논문은 위 문제를 해결하고자 Reconstruction subnetwork의 subspace를 학습에 사용하고 합성된 비정상 이미지와 정상이미지를 합성하여 두 이미지에 차를 구해 이상치를 더 도드라지게 하는 두 가지의 방법을 discriminative subnetwork에 적용한다.
- DRÆM은 2개의 Auto-Encoder 형태로 구성되어있으며 각각을 Reconstruction subnetwork와 Discriminative subnetwork 순으로 이루어져 있다.
- 전반적인 이해를 바탕으로 아래 자세히 봐보자.
Introduction & Related Work
background Research
- Recent surface anomaly detection methods rely on generative models to accurately reconstruct the normal areas and to fail on anomalies.
- 최근 surface anomaly detection방법들이 generative model을 활용하여 정상적인 이미지에 대해서는 정확하게 reconstruction하고 비정상적인 이미지에서는 실패하는 방식으로 네트워크가 설계되었다.
Recent Research
- Reconstructive methods, such as Autoencoders [5, 1, 2, 26] and GANs [24, 23], have been extensively explored since they enable learning of a powerful reconstruction subspace, using only anomaly-free images.
- AutoEncoder와 GANs와 같은 Reconstructive 방법은 정상적인 이미지만을 가지고 강력한 reconstruction subspace(부분공간)을 학습할 수 있음으로 광범위하게 탐구되었다.
- These methods are trained only on anomaly-free images, and often require hand-crafted post-processing steps to localize the anoma- lies, which prohibits optimizing the feature extraction for maximal detection capability.
- 이러한 방법은 이상치가 없는 이미지(anomaly-free images)에 대해서만 학습해야 하고 이상치(anomaly)가 어디에 위치하는지 식별하기 위해 서는 사람이 손수 후처리 단계를 요구한다. 그러나 손수 후처리 과정이 모델의 학습 과정에 포함되어 있지 않기 때문에 이상치의 위치를 감지에 필요한 중요한 feature extraction을 최적화하지 못하게 된다.
- Significant effort has thus been recently invested in designing robust surface anomaly detection methods that preferably require minimal supervision from manual annotation.
- 그래서 최근에는 최소한의 라벨링으로 Robust한 surface anomaly detection 설계에 상당한 노력이 이뤄진다.
Propose
In addition to reconstructive approach, we cast surface anomaly detection primarily as a discriminative problem and propose a discrimi- natively trained reconstruction anomaly embedding model (DRÆM).
- 우리는 앞서 설명한 reconstructive 접근 방식 뿐만 아니라 discriminative 접근 방식도 사용하여 surface anomaly detection을 다루는 DRÆM에 대해 소개한다.
The method enables direct anomaly localization without the need for additional complicated post-processing of the network output and can be trained using simple and general anomaly simulations.
- 이 방법을 사용하면 네트워크의 output을 가지고 복잡한 후처리 작업 없이 이상치가 어디에 위치하는지 식별할 수 있으며 이 방법을 통해 쉽게 이상치를 탐지해 낼 수 있으며 더 좋은 성능을 보인다.
DRÆM
- DRAEM은 reconstruction방법과 discriminative 방법을 같이 사용하는 네트워크로 구성된다.
- 정상적인 이미지를 판별하기 위해 기존의 학습 데이터(정상이미지)도 보고 학습 데이터에서 약간 벗어난 데이터(just-out-of-distribution) 즉, 정상적인 분포에서 약간 벗어난 패턴을 학습에 사용하여 다양한 상황을 학습하도록 만든다.
- 따라서 실제 Target Domain에 해당하는 비정상적인 이미지를 정확하게 반영하지 않아도 어느정도 잘 감지할 수 있다는 것이 컨샙이다.
- just-out-of-distribution의 분포를 학습시키기 위해서 본 논문에서는 simulator를 사용한다.
- 아래 그림은 DRÆM의 전반적인 구조이다.
- 그럼 Reconstruction subnetwork의 입력으로 들어가기 전에 사용되는 Anomaly generation의 simulator에 대해 알아보자.
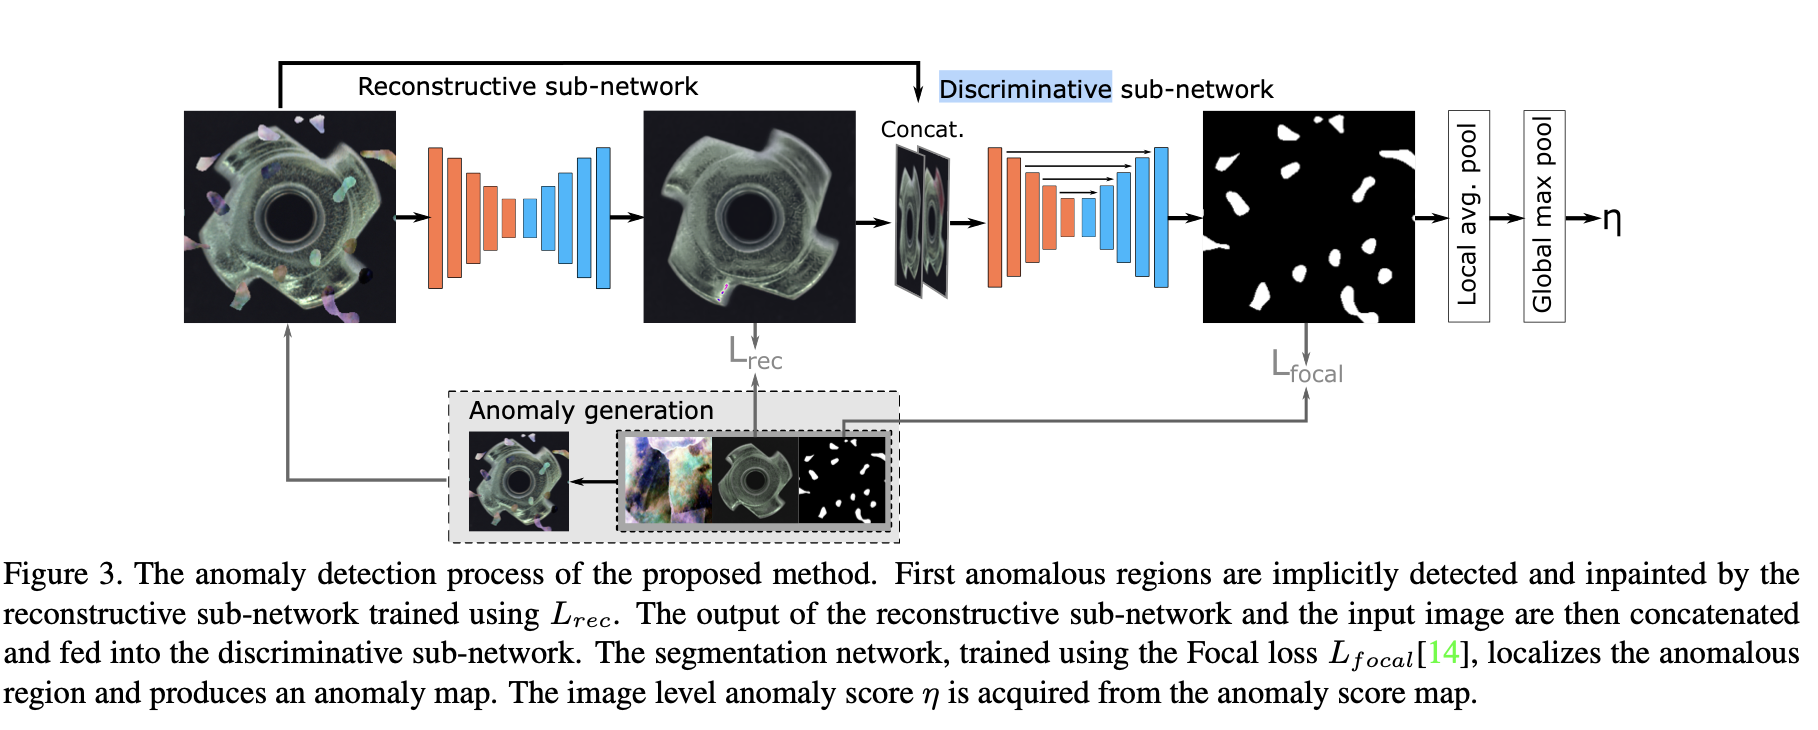
Anomaly generation
- reconstrcution방법은 simulator로 부터 나온 이미지를 원본 이미지와 유사하게 생성해 하는 것을 목적으로 한다.
- 아래 그림은 위 그림에서 Anomaly generation인 simulator의 역할이다.
- \(P\)는 Perlin noise generator를 사용하여 다양한 이상 패턴을 얻기 위해 노이즈 이미지를 생성한다.
- 그런 다음 uniform randomly하게 threshold를 sampling하고 앞서 생성한 랜덤 노이즈(\(P\))에 대한 이미지를 이진화하여 anomaly map인 \(M_a\) 와 \(\overline{M_a}\) 를 생성한다.(\(\overline{M_a}\) 는 \(M_a\)를 반전시킨 anomaly map)
- 이미지 이진화는 이미지의 각 픽셀 값을 임계값과 비교하여 0 또는 1로 변환하는 과정이다. 임계값보다 높은 픽셀 값은 1로, 임계값보다 낮은 픽셀 값은 0으로 변환된다.
- 그 다음 이미지 \(A\)(원래 입력 이미지(\(I\))와 무관한 데이터)에 RandAugment를 적용한다.
- 그리고 RandAugment를 적용한 후 위에서 생성한 \(M_a\) 와 합성해 마스킹한다.
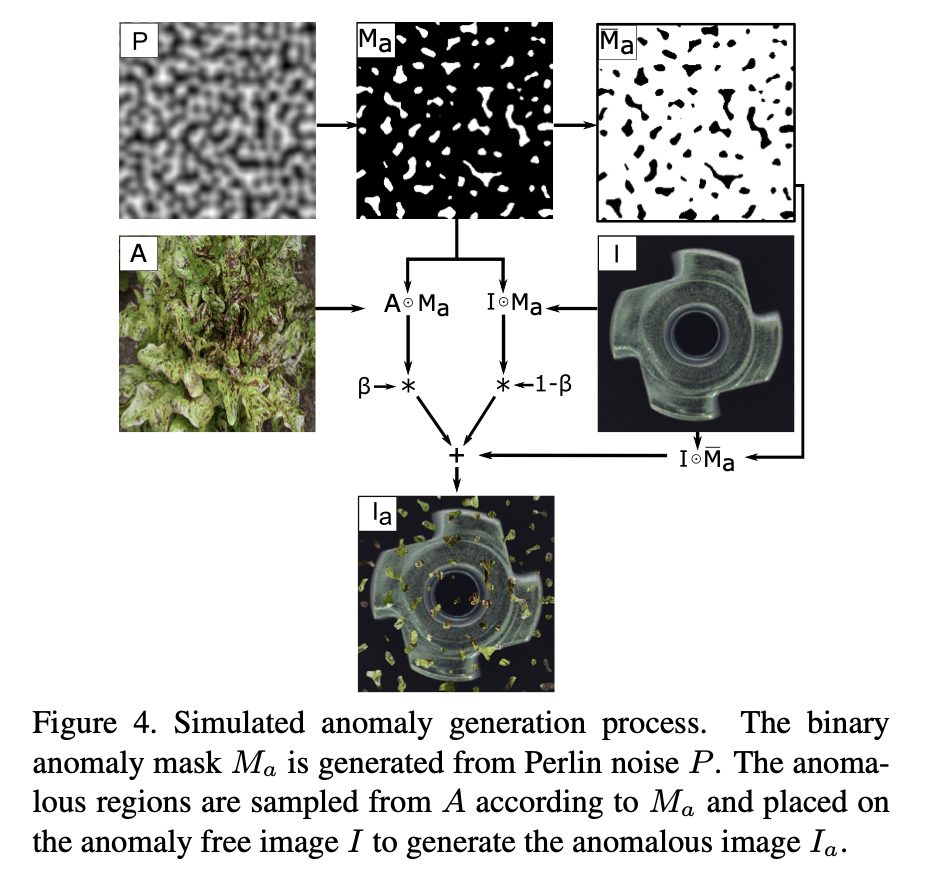
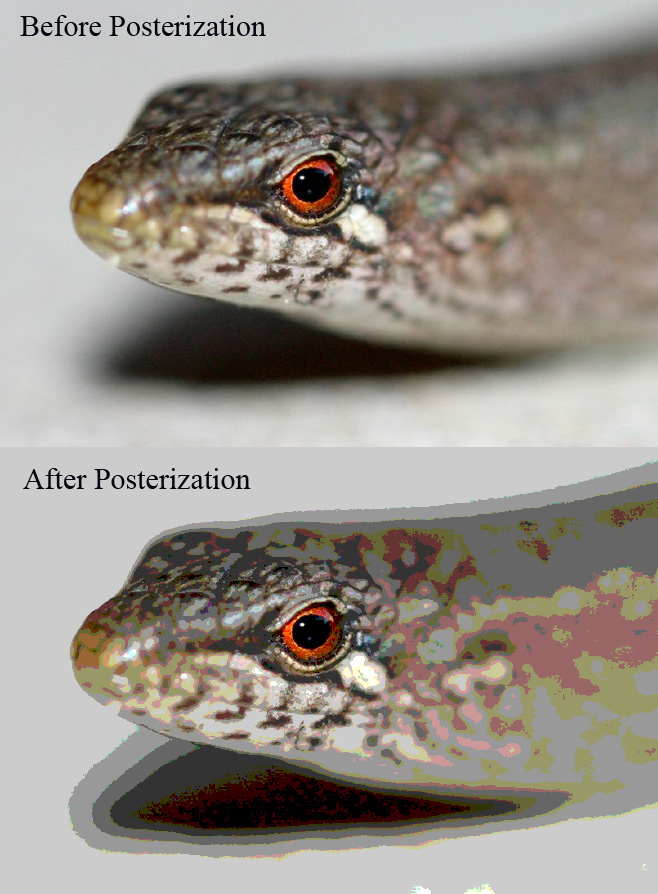
- \(A\)에 RandAugment는 {posterize, sharpness, solarize, equalize, brightness change, color change, auto-contrast} 중에서 랜덤하게 3개를 sampling하여 적용한다.
- posterize: 사용하는 색상의 수를 강제적으로 줄여줌으로써 이미지의 색상을 단순화시키는 동시에 이로 인해 포스터로 그린 듯한 단순한 느낌이 나도록 하는 효과로 아래 그림과 같다.
- sharpness(선명도), solarize(과대 노출), equalize(평활화), brightness change(밝기 변경), color change (색상 변경), auto-contrast(명암 자동 조절)
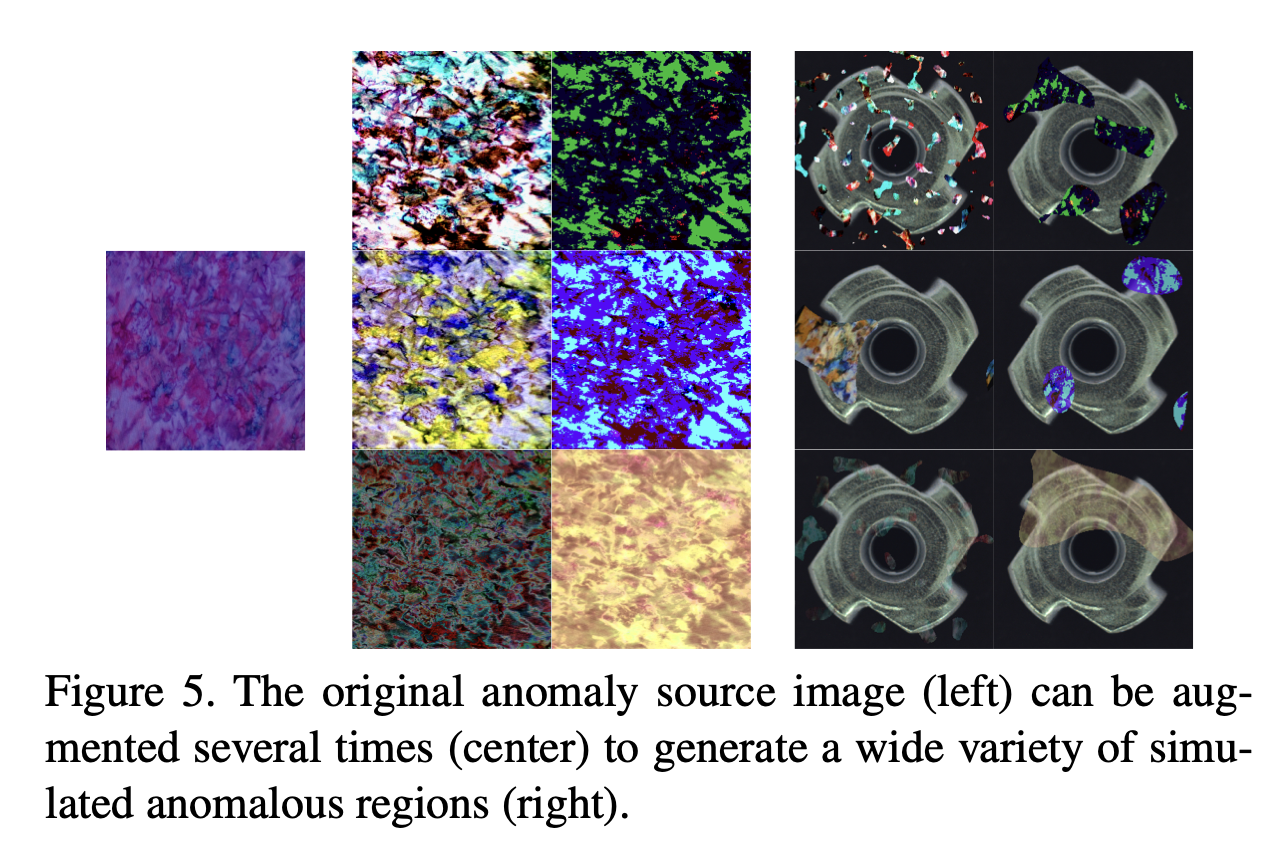
- 아래 그림에서 왼쪽 이미지는 anomaly source image(\(A\))로 입력 이미지(\(I\))와 전혀 다른 분포에서 뽑은 데이터이다.
- 가운데 이미지는 anomaly source image(\(A\))를 Augmentation한 결과이다.
- 오른쪽 이미지는 anomaly source image(\(A\))에 Augmention을 적용하고 anomaly map(\(M_a\))과 element-wise multiplication한 후 \(I \)와 혼합되어 원본 이미지 분포에서 약간 벗어난 비정상 이미지를 만들어 낸다.
- 이러한 작업을 통해 훈련된 네트워크의 decision boundary을 강화하는 데 도움이 된다.
- 앞서 설명했듯이 surface anomaly detection task에서는 비정상 이미지는 정상 이미지의 분포가 매우 비슷해 비정상 이미지도 정상 이미지로 잘 생성해 낸다는 문제가 있어 이를 해결하기 위해 사전에 네트워크에 실제 비정상 이미지는 아니지만 그와 유사한 비정상 이미지를 학습시키려는 것이다.
- \(A\)와 \(I\)를 혼합된 이미지를 \(I_a\)라고 하며 정의는 다음과 같다.
- β는 \(I\)와 \(\overline{M_A}\)의 이미지 혼합에서 사용되는 불투명도 파라미터로 만약 A의 불투명도 파라미터 β가 0.7이라면, 최종 이미지는 \(A\)의 70%와 \(I\)의 30%를 합친 결과가 된다. 이는 A가 최종 이미지에 더 큰 영향을 미친다는 것을 의미한다. (⊙는 element-wise multiplication연산)
- β parameter는 [0.1, 1.0]에서 균일하게 랜덤으로 샘플링 된다.
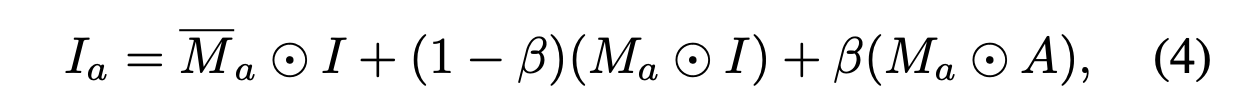
Reconstructive subnetwork
- 이 네트워크의 역할은 입력 이미지에서 이상치를 찾아내고, 그 이상치 부분을 '정상' 샘플의 분포와 가까운 패턴으로 reconstruction하는 것이다. 즉, 네트워크는 이상치를 '보정'하려고 시도한다.
- 따라서 네트워크는 simulator에서 얻은 인공적으로 손상된 이미지(정상 이미지를 비정상 이미지로 변환한) \(I_a\)에서 원본 이미지 \(I\)을 reconstruction하도록 훈련된다.
- reconstruction을 base로 하는 anomaly detection방법에서는 L2 Loss가 사용되어 원본 이미지와 reconstruction된 이미지 사이의 픽셀 간 차이의 제곱을 계산하여 손실을 측정하는데 이는 인접한 픽셀 간에 독립성이라는 가정이 전제되어 있어 인접한 픽셀간의 상관관계를 고려하지 않는다는 것이다.
- 따라서 상관관계를고려하는 패치 기반 SSIM(Structural Similarity Index Measure)가 사용된다.
- SSIM은 두 이미지가 얼마나 구조적으로 유사한지를 측정하는 방법으로 인접한 픽셀들 사이의 상관관계를 고려하여 이미지의 전반적인 구조를 보존하려는 것이다.
- SSIM에 아래와 같은 추가적인 수식을 적용함으로써 SSIM Loss를 구성한다.
- SSIM Loss에 대해서는 여기에서 자세히 설명한다.
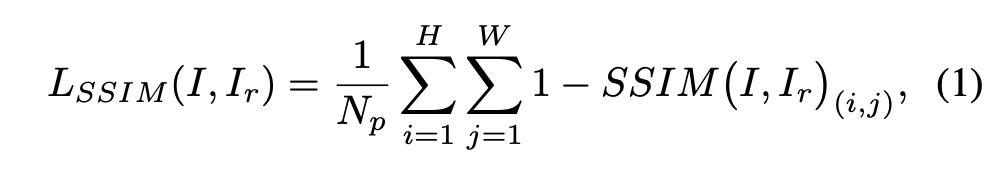
- \(H\)와 \(W\)는 Image \(I\)의 세로, 가로. \(N_p\)는 \(I\)의 픽셀 수. \(I_r\)은 reconstruction subnetwork로 부터 출력된 이미지, \((i, \;j)\)는 이미지 픽셀을 중앙으로 하는 좌표 값
- SSIM loss는 최종적으로 reconstruction subnetwork의 loss의 component로 아래와 같이 사용된다.
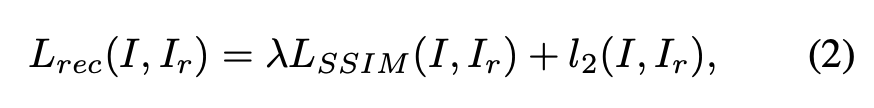
λ는 l2와 SSIM loss 사이를 조절하는loss balancing hyper-parameter이다.
Discriminative subnetwork
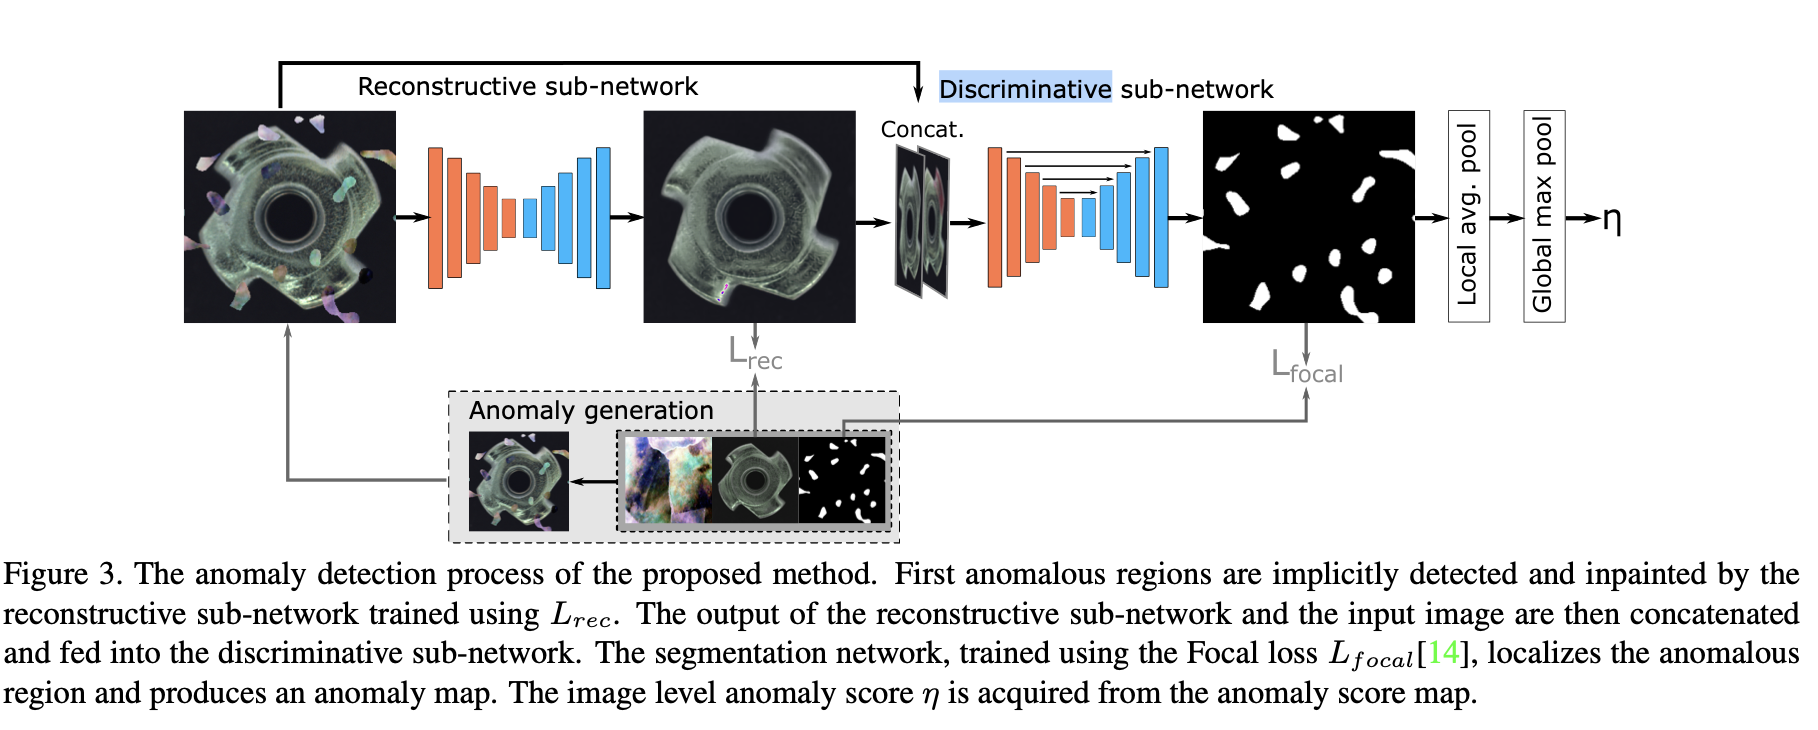
- Discriminative subnetwork는 U-Net 구조를 사용한다.
- Discriminative subnetwork의 Input인 \(I_c\)는 reconstructive subnetwork의 출력을 \(I_r\)이라 하면 \(I_r\)과원본 입력이미지인 \(I\)의 channel-wise concatenation으로 정의된다.
- 이렇게 하면 정상 이미지와 비정상 이미지의 차이 극명하게 표현할 수 있다.
- reconstructive subnetwork는 normality-restoring특성에 의해 정상 이미지로 복원하려 한다.
- normality-restoring특성은 이상치가 없는 이미지로(정상 이미지) 복원하는 능력을 의미하는데 reconstructive subnetwork는 입력 이미지에 이상치가 있더라도 그것을 무시하고 이상치가 없는 이미지를 복원하려고 시도한다.
- 따라서 입력 이미지가 이상치가 있는 이미지라면 reconstructive subnetwork로 복원된 이미지와 입력 이미지의 차이가 크게 나타날 것다. 왜냐하면 reconstructive subnetwork는 이상치를 무시하고 이상치가 없는 이미지를 복원하려고 시도하기 때문이다.
- 그리고 두 이미지의 차이를 가지고 segmentation network를 사용해 input이미지와 동일한 크기의
anomaly score map(\(M_o\))을 출력한다. - 그리고 이미지에 있는 이상치들에 대하여 각 픽셀별로 이상 점수를 anomaly segmentation map(\(M_o\))을 활용하여 나타낸다.
- discriminative subnetwork의 loss는 Focal Loss를 사용하여 맞추기 어려운 이상치에 대한 robustness를 높이는데 주력한다.
- 두 subnetworks의 reconstructive 및 segmentation의 목표를 모두 고려할 때, DRAM 훈련에 사용되는 최종 loss는 다음과 같다.
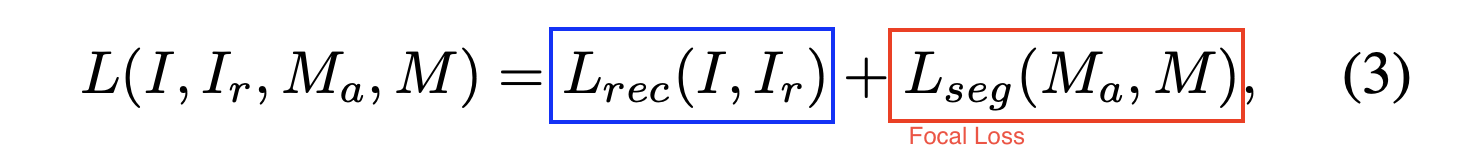
- 여기서 \(M_a\)
는 ground truth에 해당하고 \(M\)은 네트워크의 output anomaly segmentation masks이다.
Surface anomaly localization and detection
- 이전 연구에서, Image-level anomaly classification에서의 결과는 direct score estimation method를 능가하는 결과를 보지 못했다.
- 이미지 수준의 이상 분류(Image-level anomaly classification): 전체 이미지를 기반으로 이상을 분류하는 방법으로 예를 들어, 공장에서 생산되는 제품의 이미지를 분석하여 제품에 결함이 있는지 없는지를 판단하는 것이 이에 해당된다.
- 직접 점수 추정 방법(Direct score estimation method): 이상 점수 맵에서 최대 이상 점수를 추출하여 이미지 전체의 이상 점수를 계산하는 방법으로 픽셀 수준에서 이상을 탐지하므로, 이상이 발생한 구체적인 위치를 파악하는 데 유용하다.
- 따라서 직접 점수 추정 방식을 사용하기 위해 Discriminative subnetwork의 출력인 pixel-level anomaly detection mask \(M_o\)는 이미지 전체에 대한 anomaly score map을 사용한다.
- Anomaly score map(\(M_o\))은 convolution layer에서 mean filter를 사용하여 이상치에 대한 정보를 더 극대화 시킨다. mean filter(kernel)은 픽셀 값을 해당 픽셀 주변의 값들의 평균으로 대체하는 방식이다.
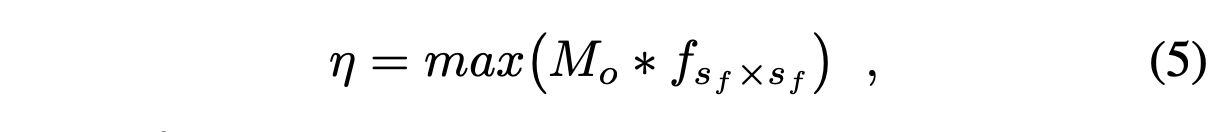
- mean filter가 적용된 \(M_o\)에 최대값을 취하여 최종적으로 anomaly score η를 계산한다. 즉, 이미지 전체에서 가장 높은 anomaly score를 가진 픽셀의 점수를 이미지 전체의 anomaly score로 사용한다.
- \(f_{sf\times sf}\)는 \(sf\times sf\) 크기의 mean filter라는 것을 의미하고 *은 CNN 연산자를 의미한다.
Experiments
Image-level AUROC is used for anomaly detection and a pixel-based AUROC for evaluating anomaly localization.
We thus additionally report the pixel-wise average precision metric (AP), which is more appropriate for highly imbalanced classes and in particular for surface anomaly detection, where the precision plays an important role.
Datasets
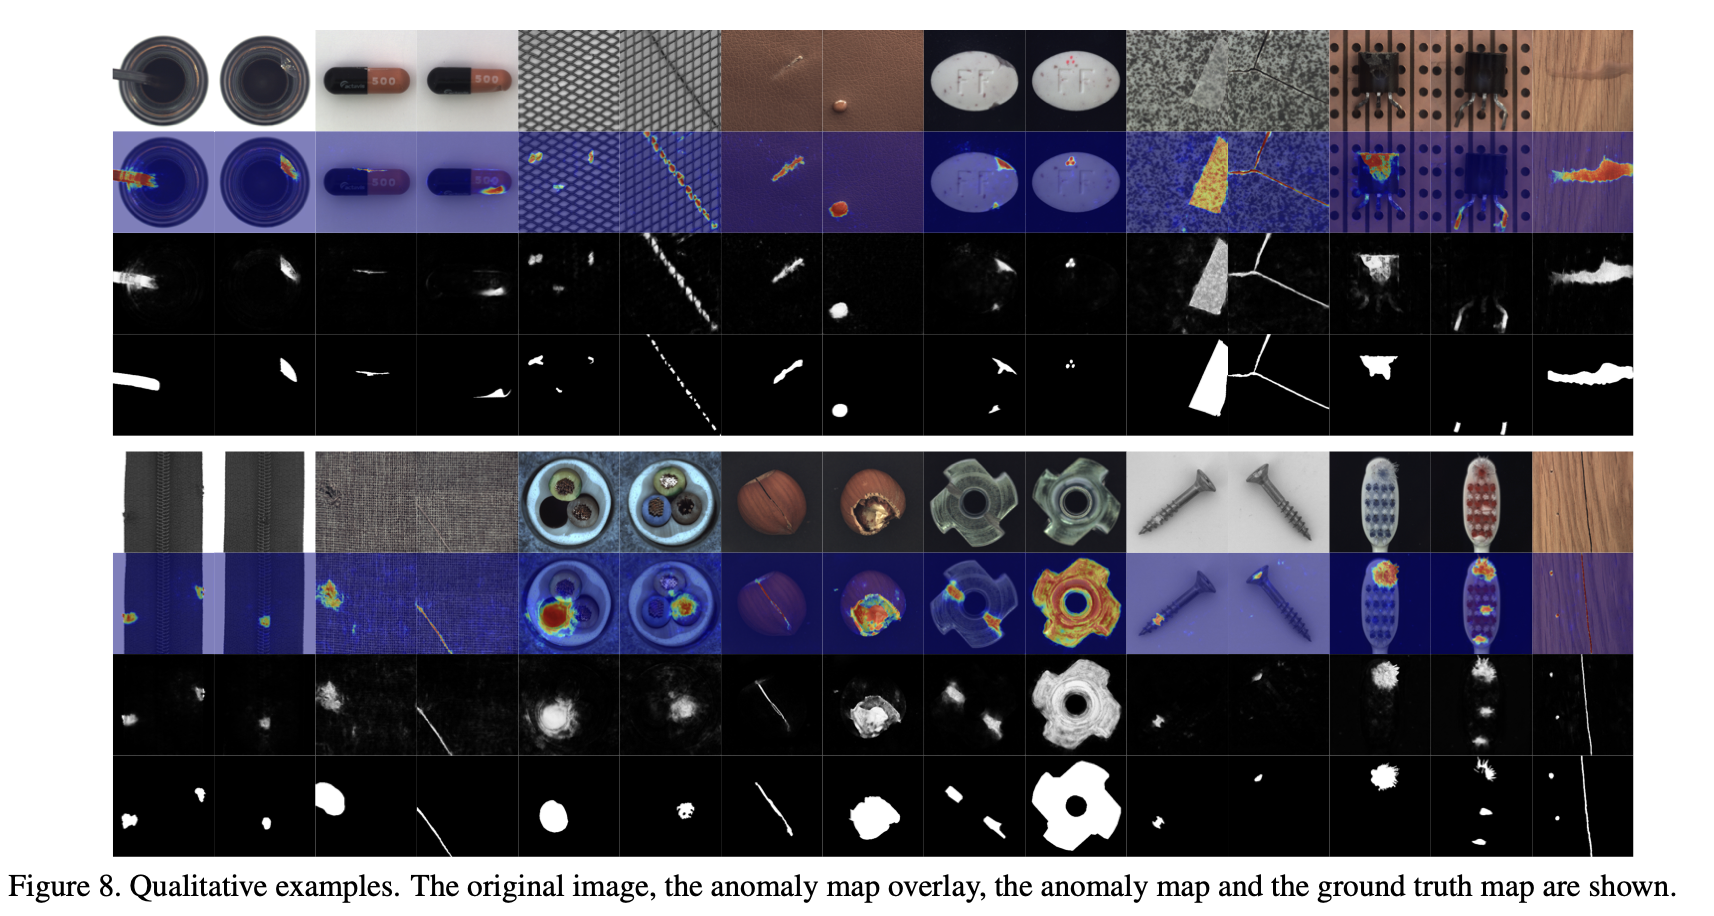
MVTec(15 classes)
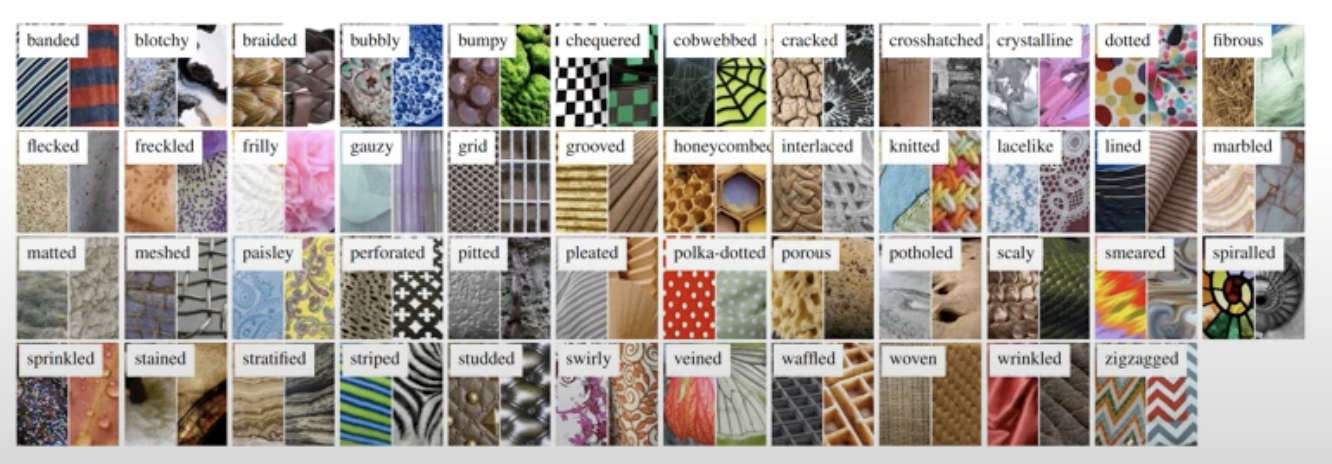
DTD(Describable Textures Dataset)
Use Anomaly source dataset. Consisting of 5640 images, organized according to a list of 47 terms (categories).
Setting
The network is trained for 700 epochs on the MVTec anomaly detection dataset.
The learning rate is set to \(10^{-4}\) and is multiplied by 0.1 after 400 and 600 epochs.
Image rotation in the range of (−45, 45) degrees is used as a data augmentation method on anomaly free images during training to alleviate overfitting due to the relatively small anomaly-free training set size.
Surface Anomaly Detection
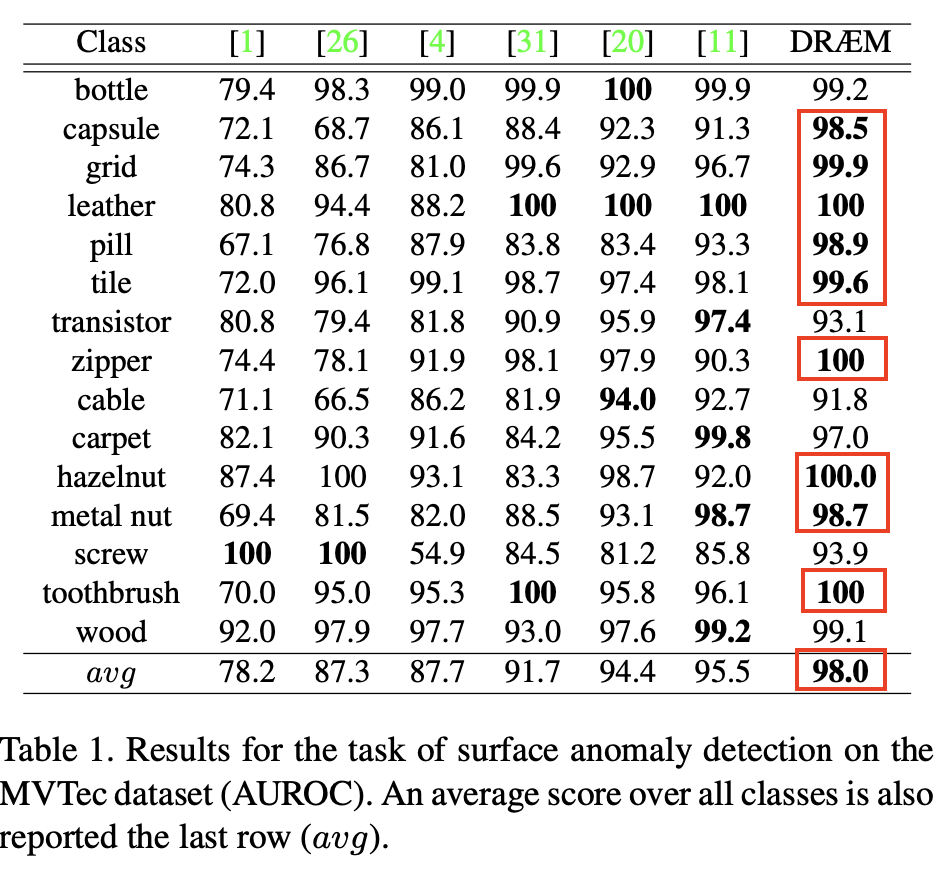
AUROC를 지표로 하여 나타난 결과로 MVTec dataset에서 15개의 class중 9개의 class에 대해서 가장 높은 성능을 달성 했다. [1] GANomaly, [26] DAGAN, [4] Student-Teacher AD, [31] RIAD, [20] Gaussian AD, [11] Padim 순으로 비교하면 된다.
Anomaly localization
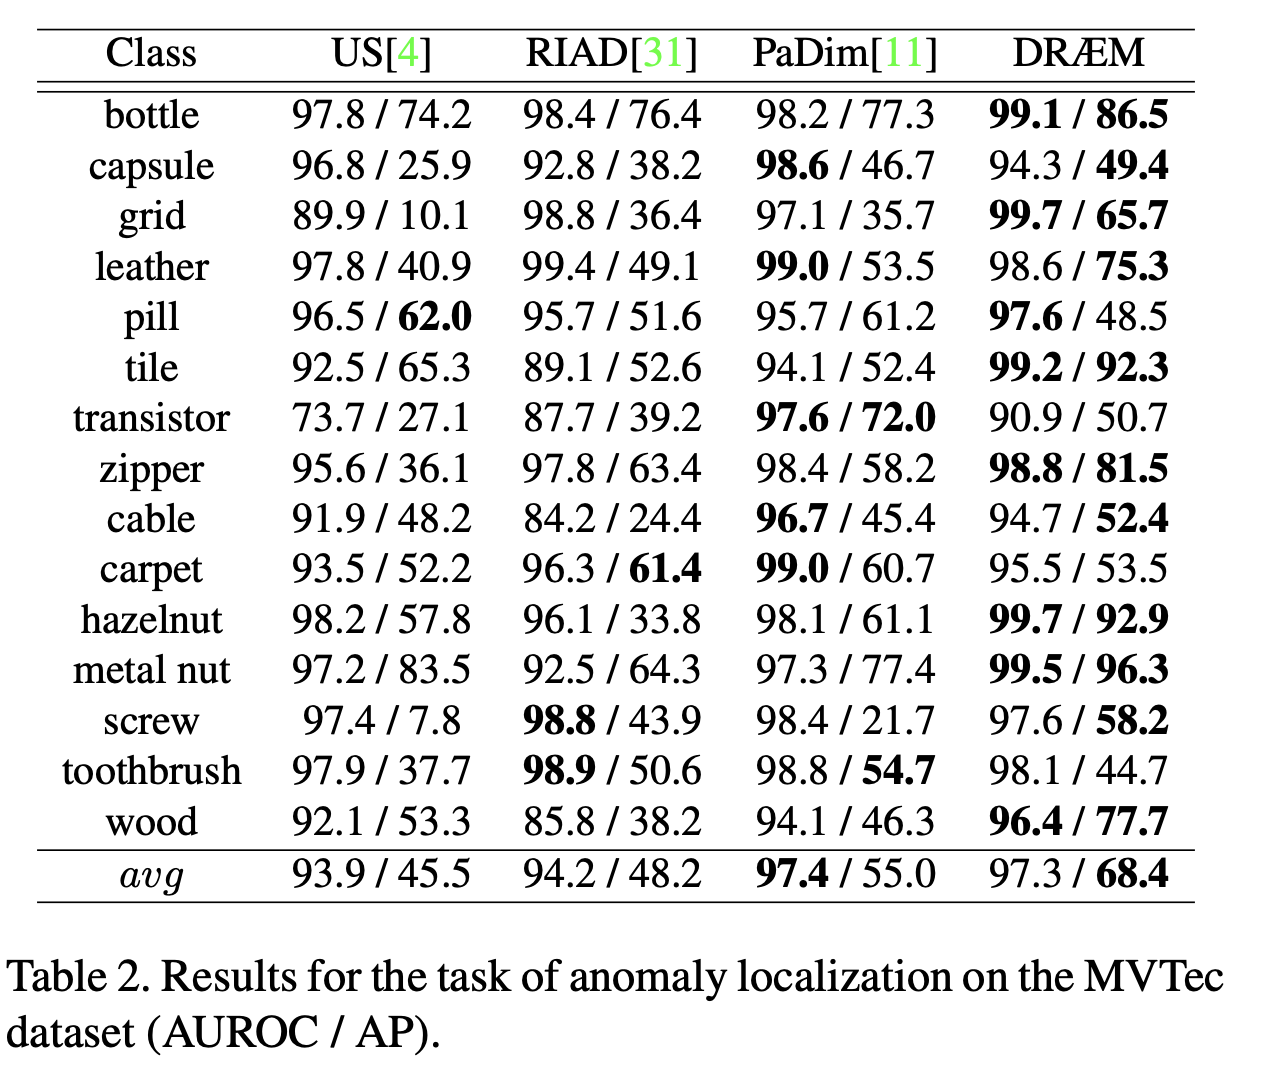
Anomaly localization에서의 MVTec dataset의 결과로 평가 지표는 (AUROC/ AP) 이다.
15개의 class중 11개의 class에서 가장 높은 AP(Average Precision)스코어를 얻었다.
Ablation Study
Architecture
- Disc. 를 보면 Reconstruction Subnetwork를 제거한 후 Discriminative subnetwork만을 학습시켜 평가한다. 성능 하락이 보이는데 그 이유는 simulated anomalies에 discriminative subnetwork가 overfitting되기 때문이다.
- Recon. -AE에서는 reconstructive subnetwork만을 남기고 discriminative subnetwork 제거하여 성능을 평가하고 있다..
- Recon-AE(MSGMS)에서는 유사도 함수를 SSIM이 아닌 MS-GMS로 사용하였을 때의 성능지표이다. 그러나 기존 SSIM을 Draem에 적용한 것이 더 높은 성능을 보였다.
- Bozicet al. 에서는 DRÆM의 backbone을 최신 SOTA supervised surface anomaly detection network로 대체하고, 평가했으나 성능이 크게 떨어졌다. 그 이유는 정상이나 이상치의 모습 자체를 학습하는 것보다 기존 Draem에서 소개되었던 정상이미지와 비정상이미지가 얼마나 벗어났는지를 학습하는 것이 더 효과적이다라는 것을 보여준다.
- DRAEM_no_aug, DRAEM_aug에서는 크게 차이가 나지 않으나 β(the opacity parameter)를 적용한 것과는 꽤나 차이가 있음을 볼 수 있다.
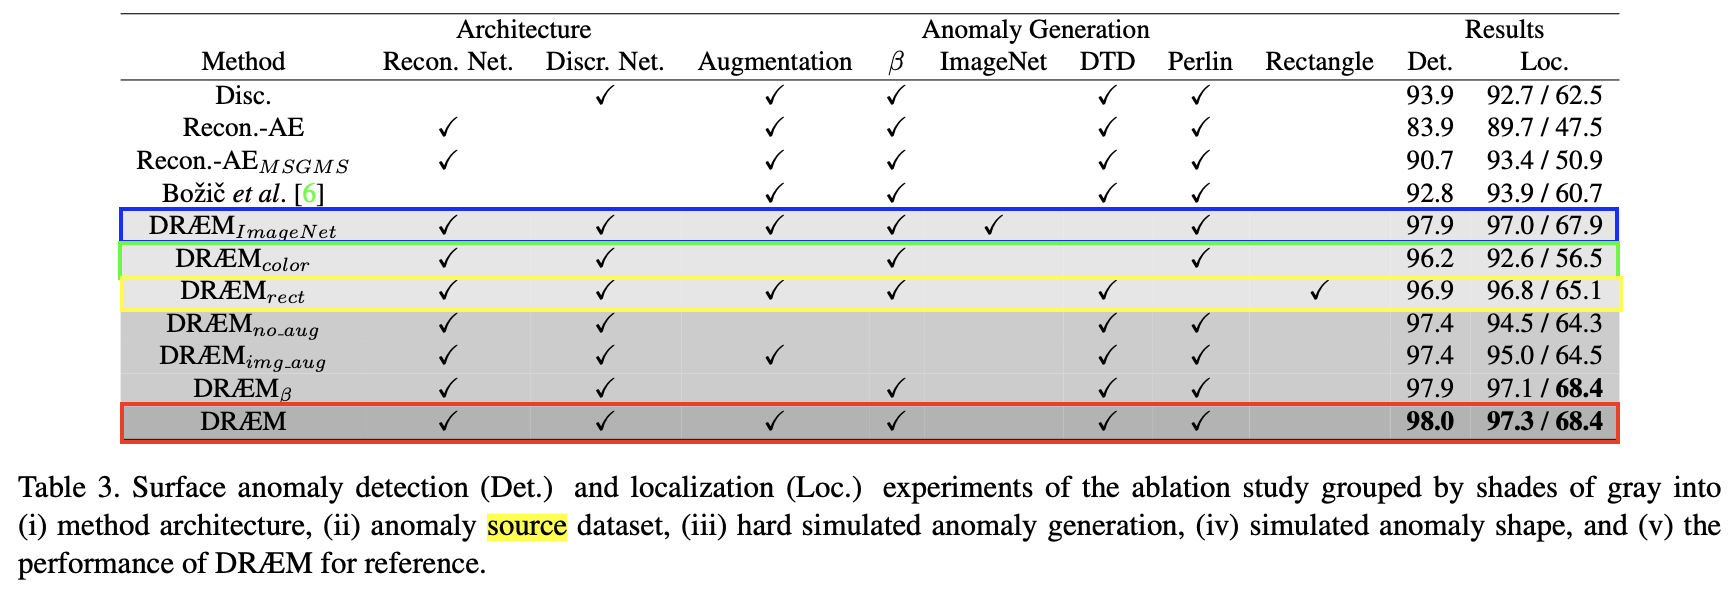
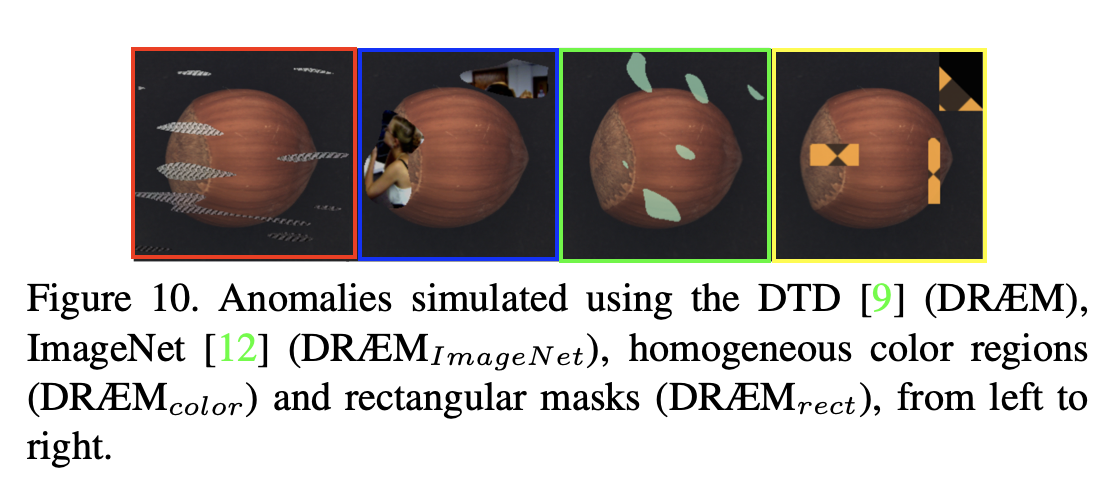
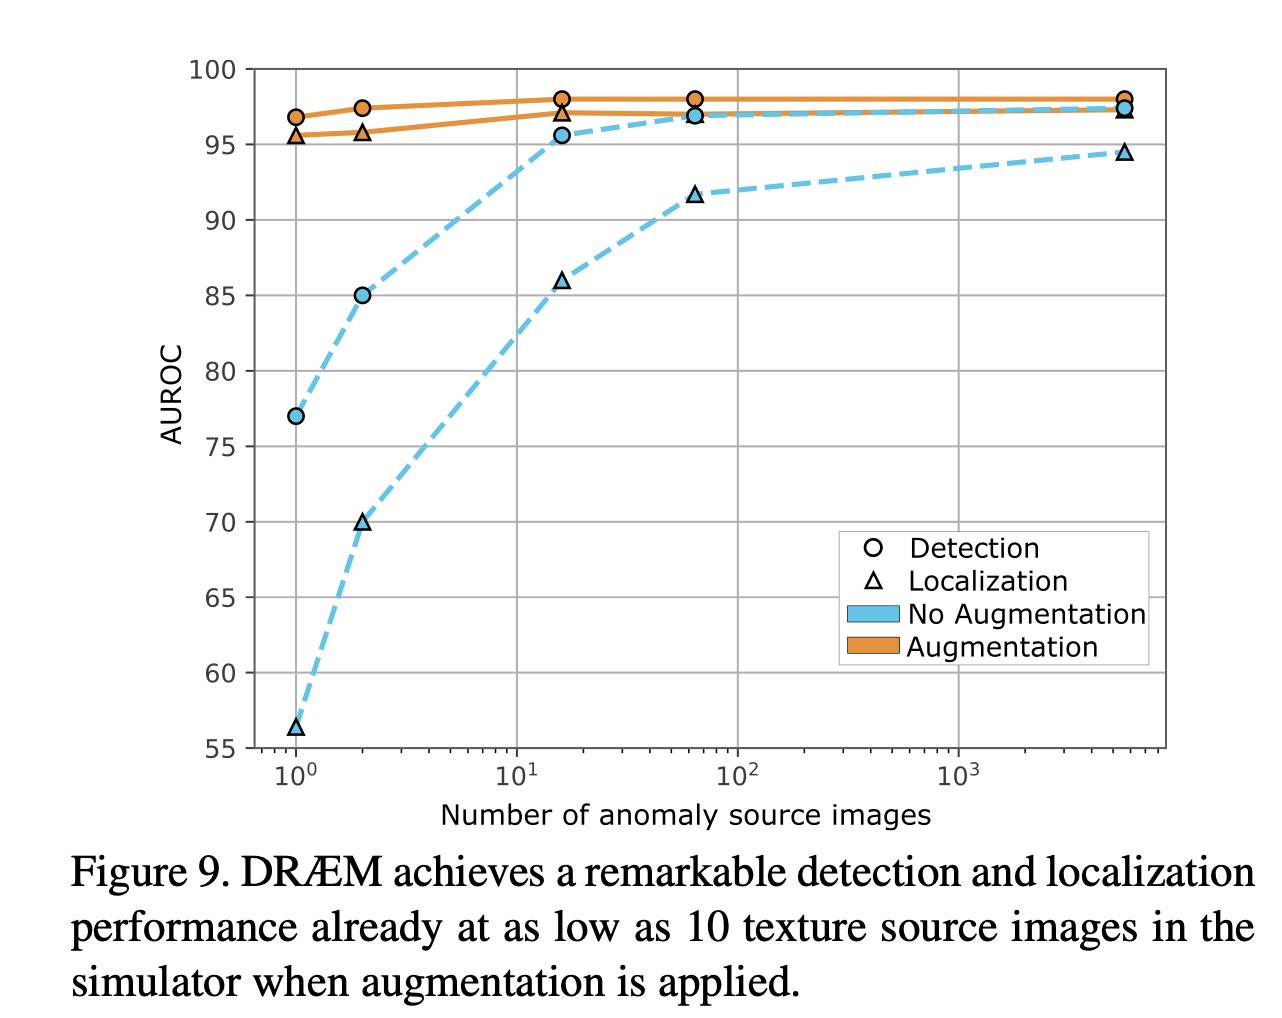
아래 색깔친 박스는 Texture source image from an anomaly source image dataset에 따른 실험한 결과를 보여준다.
- 아래 그림에서 빨강박스는 DRAEM에 Texture source dataset으로
DTD dataset을 적용한 결과 - 파란색 박스는 DRAEM에 Texture source dataset으로
ImageNet을 적용한 결과 - 초록색 박스는 DRAEM에
random하게 sampling된 색으로 적용한 결과 - 노란색 박스는 DRAEM에 random하게 sampling된 직사각형을 적용한 결과이고 이 결과가 Navie DRAEM과 비교해 볼 때 약간의 성능차이만 있었기 때문에 Simulated로 부터 나온 Anomaly의 모양이 실제 Anomaly모양과 비슷하지 않아도 된다는 것이다.
Anomaly source dataset으로 이용되는 데이터 크기에 따른 성능을 평가한 결과이다.
위 결과에서 볼 수 있듯이 β(the opacity parameter)와 Augmentation의 성능에 크게 영향을 주고 있으며 적은 수의 Texture source image로도 높은 성능을 달성할 수 있다고 말한다.
Comparison with supervised methods
We thus compare DRÆM with the supervised methods on the DAGM dataset [28] that contains 10 textured object classes.
DAGM dataset
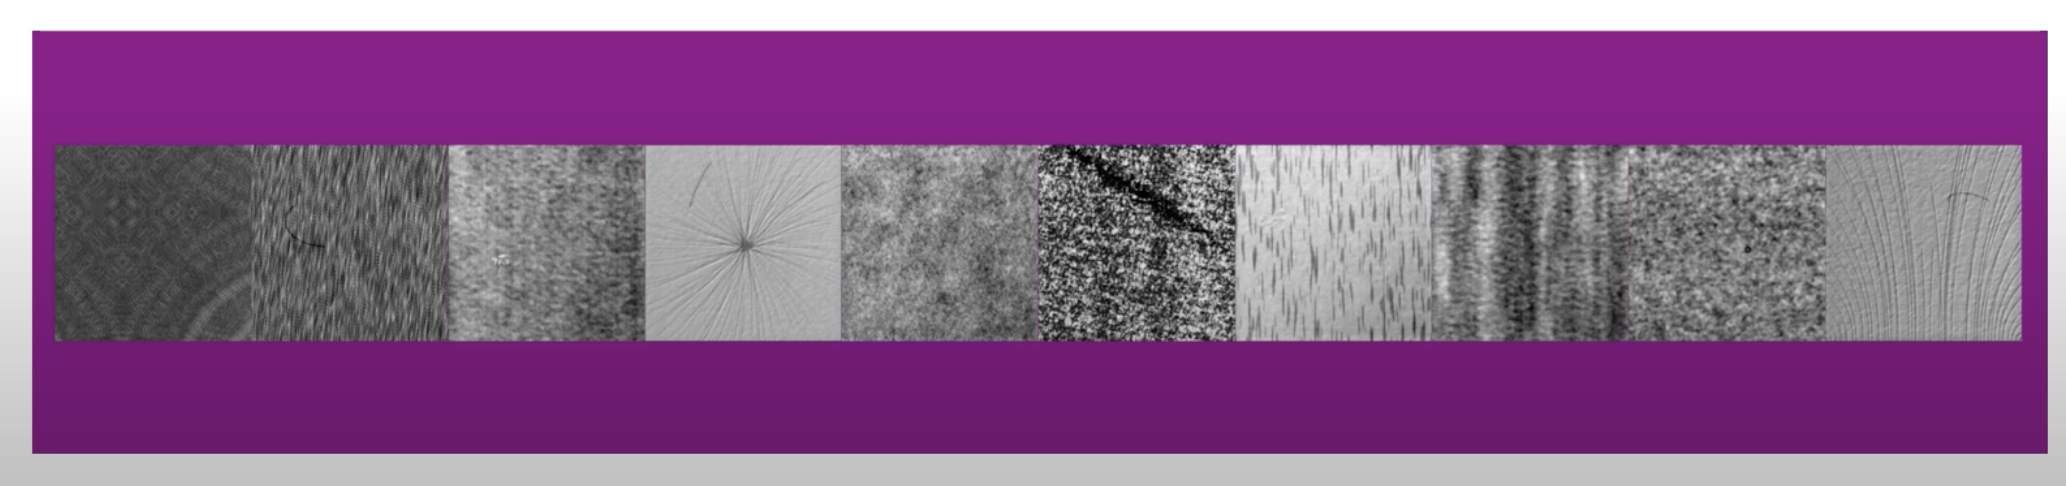
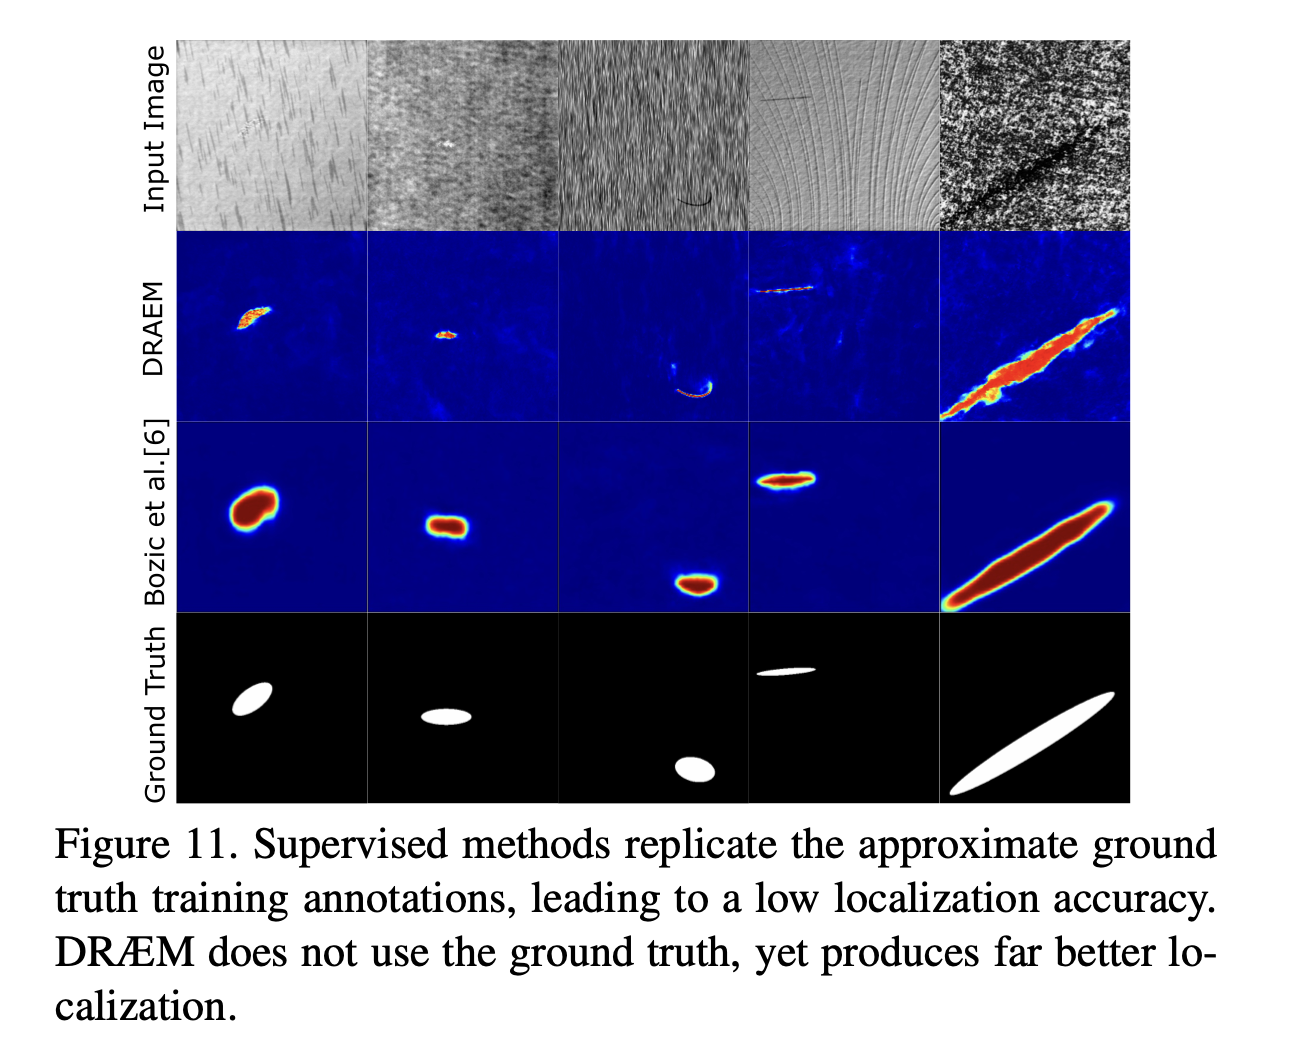
Supervised Learning에서의 Draem은 surface anomaly을 대략적으로 타원의 형태로 cover하고 있는 모습을 볼 수 있다.(Bozic et al.)
그 이유는 대략적으로 라벨링(coarsely annotated) 되었기 때문에, 테스트 이미지에서도 anomaly한 부분을 정확하게 segmentation하기는 어렵다. 아래 보면 Ground Truth를 정답으로 학습하여 테스트한 Bozic et al.행의 결과와 unsupervised로 학습된 DRAEM의 결과 차이를 보면 알 수 있다.
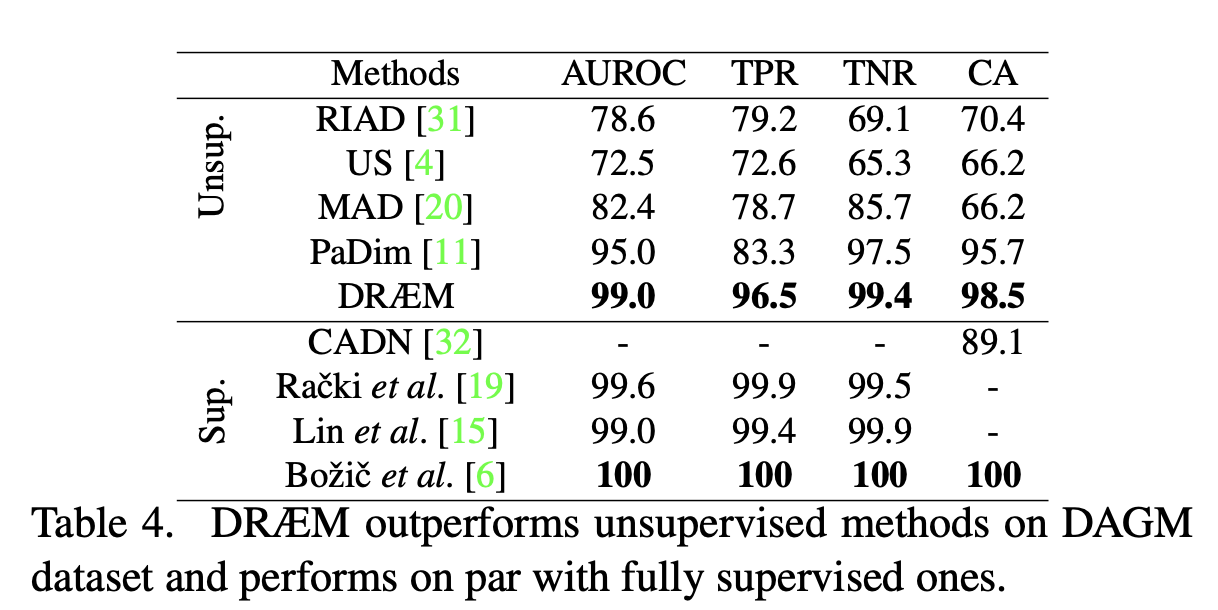
또한 Unsupervised Learning이 Supervised Learning과 거의 준하는 결과를 보여준다.
Comment