
서론
기존 LLM의 Unlearning은 특정 지식을 잊은 것처럼 행동하도록 만들지만 내부의 잠재 능력은 여전히 남아 있어 조금의 Fine-tuning만으로도 해당 지식이 복구되는 문제가 있다.
본 논문에서는 이러한 문제를 해결하기 위해 Unlearning과 Knowledge Distillation을 결합한 UNDO 방법을 제안한다.
핵심 아이디어는 Teacher의 Hidden Representation이 아닌 출력(Output)만을 Student에게 증류하여, 원치 않는 잠재 능력의 전달을 최소화하는 것이다.
구체적으로 기존 모델을 Unlearning한 뒤 노이즈를 추가한 모델 복사본을 Student로 사용하고, Unlearning된 Teacher의 출력으로 Student를 학습시킨다. 이를 통해 기존 Unlearning보다 Fine-tuning을 통한 지식 복구에 강건한 모델을 만들 수 있으며, WMDP 벤치마크에서도 그 효과를 검증하였다.
본론
LLM은 방대한 데이터로 사전학습되는 과정에서 유용한 지식뿐만 아니라 위험한 지식까지 습득할 수 있다.
이를 방지하기 위해 학습 전 데이터를 필터링하는 것이 이상적이지만, 데이터의 규모가 방대하여 완벽한 필터링은 현실적으로 어렵다.
이러한 문제를 해결하기 위해 Unlearning 연구가 등장했다. 그러나 기존 RLHF와 Unlearning 방법은 위험한 지식 자체를 제거하기보다 모델이 해당 지식을 사용하지 못하도록 행동을 억제하는 데 그치는 경우가 많다.
따라서 소수의 Fine-tuning만으로도 제거했다고 생각한 능력이 다시 복구되는 문제가 발생한다.
본 논문에서는 이러한 한계를 해결하기 위해 Unlearning과 Knowledge Distillation을 결합한 UNDO 방법을 제안한다.
구체적으로 기존 모델을 Unlearning한 뒤, 해당 모델의 복사본에 노이즈를 추가하여 Student를 생성하고, Unlearning된 Teacher의 출력(Output)을 Student에게 증류한다.
이를 통해 원하는 행동은 유지하면서 원치 않는 잠재 능력의 전달을 최소화한다.
실험 결과, UNDO는 위험한 데이터를 제외하고 처음부터 학습한 Oracle 모델에 근접하는 재학습 공격 저항성을 달성했으며, 더 적은 연산 비용으로 유사한 강건성을 확보할 수 있었다.
Oracle Model: 제거하고 싶은 위험한 지식을 처음부터 학습하지 않은 모델이다.
Robust Unlearning
Robust Unlearning은 유지하고 싶은 능력(Retain)은 보존하면서, 제거하고 싶은 능력(Forget)은 재학습 공격에도 쉽게 복구되지 않도록 하는 것을 목표로 한다.
1. 구성 요소
- Reference Model: 유지할 능력과 제거할 능력을 모두 가진 원본 LLM
- Retain Set: 유지하고자 하는 능력을 나타내는 데이터셋
- Forget Set: 제거하고자 하는 능력을 나타내는 데이터셋
- Training Data: Unlearning 및 Distillation 등에 활용하는 un-labeled 데이터셋
- Oracle Model: 제거 대상과 관련된 데이터를 처음부터 제외하고 학습한 모델로, Unlearning 성능을 비교하기 위한 이상적인 기준(Gold Standard)
- Reference Model: 유지해야 할 능력과 제거해야 할 능력을 모두 학습한 원본 모델
2. 평가 방법
- Retain Evaluation: 유지해야 할 능력이 얼마나 보존되었는가?
- Elicited Forget Evaluation: Fine-tuning 공격 이후 제거한 능력이 얼마나 복구되는가?
즉, Retain 성능은 높게 유지하면서 Elicited Forget 성능을 최소화하는 것이 목표이다.
Elicitation Mechanism (숨겨진 능력 유도 방법)
Unlearning의 강건성을 평가하기 위해 Relearning Attack(재학습 공격)을 활용한다.
Relearning Attack은 Forget Set으로 모델을 Fine-tuning하여 제거된 능력을 다시 복구하려는 공격이다.
연구자는 이 공격을 수행한 후 제거된 능력이 얼마나 복구되었는지 측정하여 Unlearning의 강건성을 평가한다.
- Unlearning 수행 → Forget 성능 5%
- Relearning Attack 수행 → Forget 성능 80%
- 평가 → 제거된 능력이 쉽게 복구되므로 강건성이 낮음
서로 다른 Learning Rate로 Relearning Attack을 수행하고, Forget 성능이 가장 높게 복구된 결과(Worst Case)를 최종 평가에 사용한다.
기존 Unlearning의 강건성을 평가하기 위해 Relearning Attack(재학습 공격)을 활용한다.
Relearning Attack은 제거하고 싶은 Forget Set을 활용해 모델을 Fine-tuning하여 제거된 능력을 다시 복구하려는 공격이다.
이 공격을 수행한 후 제거된 능력이 얼마나 복구되었는지 측정하여 Unlearning의 강건성을 평가한다.
- Unlearning 수행 → Forget 성능 5%
- Relearning Attack 수행 → Forget 성능 80%
- 평가 → 공격으로 능력이 쉽게 복구되므로 강건성이 낮음
서로 다른 Learning Rate로 Relearning Attack을 수행하고, Forget 성능이 가장 높게 복구된 결과(Worst Case)를 최종 평가에 사용한다.
| Learning Rate | 공격 후 Forget 성능 |
|---|---|
| 0.00001 | 15% |
| 0.0001 | 45% |
| 0.001 | 80% |
위 경우 Elicited Forget Performance는 80%이며 제거하려던 능력이 상당 부분 복구되었으므로 강건성이 낮다고 평가한다.
Unlearning의 두 가지 접근 방식
Unlearning은 제거 대상에 따라
- Privacy Unlearning
- Capabilities-focused Unlearning
으로 구분할 수 있다.
1. Privacy Unlearning (데이터 중심)
특정 학습 데이터의 영향을 모델에서 제거하는 것이 목적이다.
예를 들어 전체 학습 데이터 100만 개 중 개인정보 1만 개를 삭제해야 한다면, 나머지 99만 개로 처음부터 학습한 모델과 동등한 결과를 얻는 것을 목표로 한다.
2. Capabilities-focused Unlearning (능력 중심)
특정 데이터가 아닌 모델이 습득한 특정 능력 자체를 제거하는 것이 목적이다.
본 논문은 이 방식에 집중하며, 제거하고 싶은 능력을 나타내는 Forget Set을 활용하여 Unlearning을 수행한다.
Distillation Robustifies Unlearning
Oracle Model은 처음부터 위험한 데이터를 제외하고 학습해야 하므로 비용이 많이 듭니다. 따라서 일반적인 Unlearning 방법을 적용한 모델을 Teacher로 사용해도 Distillation의 효과가 유지되는지 확인합니다.
Unlearning Methods (기존 Unlearning 방법)
Distillation이 특정 Unlearning 방법에서만 효과가 있는지 확인하기 위해 서로 다른 세 가지 Unlearning 알고리즘을 사용한다.
| 방법 | 수정 대상 | 핵심 아이디어 |
|---|---|---|
| GradDiff | Gradient | Forget Loss는 높이고 Retain Loss는 낮춤 |
| MaxEnt | 출력 확률 분포 | Forget 데이터에 대한 예측을 불확실하게 만듦 |
| RMU | Hidden Representation | Forget 데이터의 내부 표현을 교란 |
Method A: Gradient Difference (GradDiff)
Gradient를 이용한 Unlearning
Unlearning 방법 중 하나인 Gradient Difference(GradDiff)는 Forget 데이터는 잘못 예측하도록, Retain 데이터는 잘 예측하도록 서로 반대되는 방향으로 모델을 학습시킨다.
파라미터 θ를 가진 모델에서 GradDiff는 다음 목적함수를 최소화하며, 두 Loss는 모두 Cross-Entropy Loss를 사용한다.
- \(-\mathcal{L}_{\text{forget}}\): Forget Loss를 최대화 → 제거할 지식을 잘 예측하지 못하게 함
- \(+\mathcal{L}_{\text{retain}}\): Retain Loss를 최소화 → 유지할 지식은 잘 예측하도록 함
따라서 모델이 위험한 질문의 정답을 예측할 확률은 낮추고, 일반적인 질문의 정답을 예측할 확률은 유지하도록 학습한다.
Method B: Maximizing Entropy (MaxEnt)
출력의 불확실성을 높이는 방법
Maximizing Entropy(MaxEnt)는 Retain 데이터에 대한 성능은 유지하면서 위험한 질문에 대해 모델이 특정 정답을 높은 확률로 예측하지 못하도록 출력 확률 분포를 균등하게 만드는 방법이다.
MaxEnt는 다음 목적함수를 최소화하며, \(L_{\text{uniform}}\)은 Forget 데이터의 출력 확률 분포를 균등 분포에 가깝게 만드는 KL Divergence 항이고, \(L_{\text{retain}}\)은 Cross-Entropy Loss이다.
- \(\mathcal{L}_{\text{uniform}}\): Forget 데이터의 출력 확률을 균등하게 만듦
- \(\mathcal{L}_{\text{retain}}\): Retain 데이터의 정답 예측 능력을 유지함
GradDiff와 MaxEnt의 차이
- GradDiff는 정답을 틀리도록 학습하고, MaxEnt는 정답을 확신하지 못하도록 학습
| 방법 | A | B | C | D |
|---|---|---|---|---|
| 기존 모델 | 90% | 5% | 3% | 2% |
| GradDiff | 5% | 50% | 30% | 15% |
| MaxEnt | 25% | 25% | 25% | 25% |
Method C: Representation Misdirection for Unlearning (RMU)
RMU는 모델 내부의 Hidden Representation 자체를 변경하여 위험한 지식의 표현을 교란한다.
RMU는 다음 목적함수를 최소화한다.
\(L_{\text{misdirect}}\)는 Forget 데이터에 대한 특정 Layer의 내부 Activation을 무작위 방향으로 이동시키기 위해 MSE Loss를 사용하고, \(L_{\text{preserve}}\)는 Retain 데이터에 대한 내부 Activation이 원본 모델과 유사하게 유지되도록 MSE Loss를 사용한다.
\(\mathcal{L}_{\text{misdirect}} = \operatorname{MSE}(h_{\theta}(x_f),c)\)
- \(h_{\theta}(x_f)\): Forget 데이터를 입력했을 때 현재 모델의 Hidden Representation
- \(c\): 무작위 방향으로 설정한 목표 벡터
위험한 지식과 관련된 내부 표현을 원래 위치에서 벗어나도록 학습
| 구분 | GradDiff | MaxEnt | RMU |
|---|---|---|---|
| 핵심 접근 | Gradient 조작 | 출력 확률 분포 조정 | 내부 표현 조작 |
| Forget 목표 | 정답 예측 Loss 증가 | 출력 분포 균등화 | Hidden Representation 교란 |
| Retain 목표 | 정답 예측 Loss 감소 | 정답 예측 Loss 감소 | 원본 Hidden Representation 유지 |
| 주요 Loss | Cross-Entropy | KL Divergence + CE | MSE |
| 특징 | 정답을 틀리게 학습 | 정답을 확신하지 못하게 학습 | 내부 표현을 다른 방향으로 이동 |
다음 스탭은 다음과 같은 Unlearning된 Teacher를 준비한다.
- GradDiff: Gradient를 조작하여 Unlearning
- MaxEnt: 출력 확률 분포를 조작하여 Unlearning
- RMU: 내부 표현을 조작하여 Unlearning
그리고 unlearning된 모델을 Teacher로 사용하고 무작위 초기화된 Student를 Teacher의 출력 확률 분포에 맞춰 학습한다.
이러한 방법을 본 논문에서는 이 방법을 Unlearn-and-Distill이라고 부른다.
그리고 세 가지 모델에 동일한 재학습 공격을 수행하여 어떤 모델에서 제거된 능력이 가장 느리게 복구되는지 비교한다.
| 비교 모델 | 설명 |
|---|---|
| Unlearning-only | Unlearning만 적용한 모델 |
| Unlearn-and-Distill | Unlearning 이후 Distillation까지 적용한 모델 |
| Oracle | 위험한 데이터를 제외하고 처음부터 학습한 모델 |
언어와 수학 문제에서 Relearning Attack을 수행하면서, Fine-tuning이 진행될수록 제거된 능력이 얼마나 빠르게 복구되는지 그래프로 비교한다.
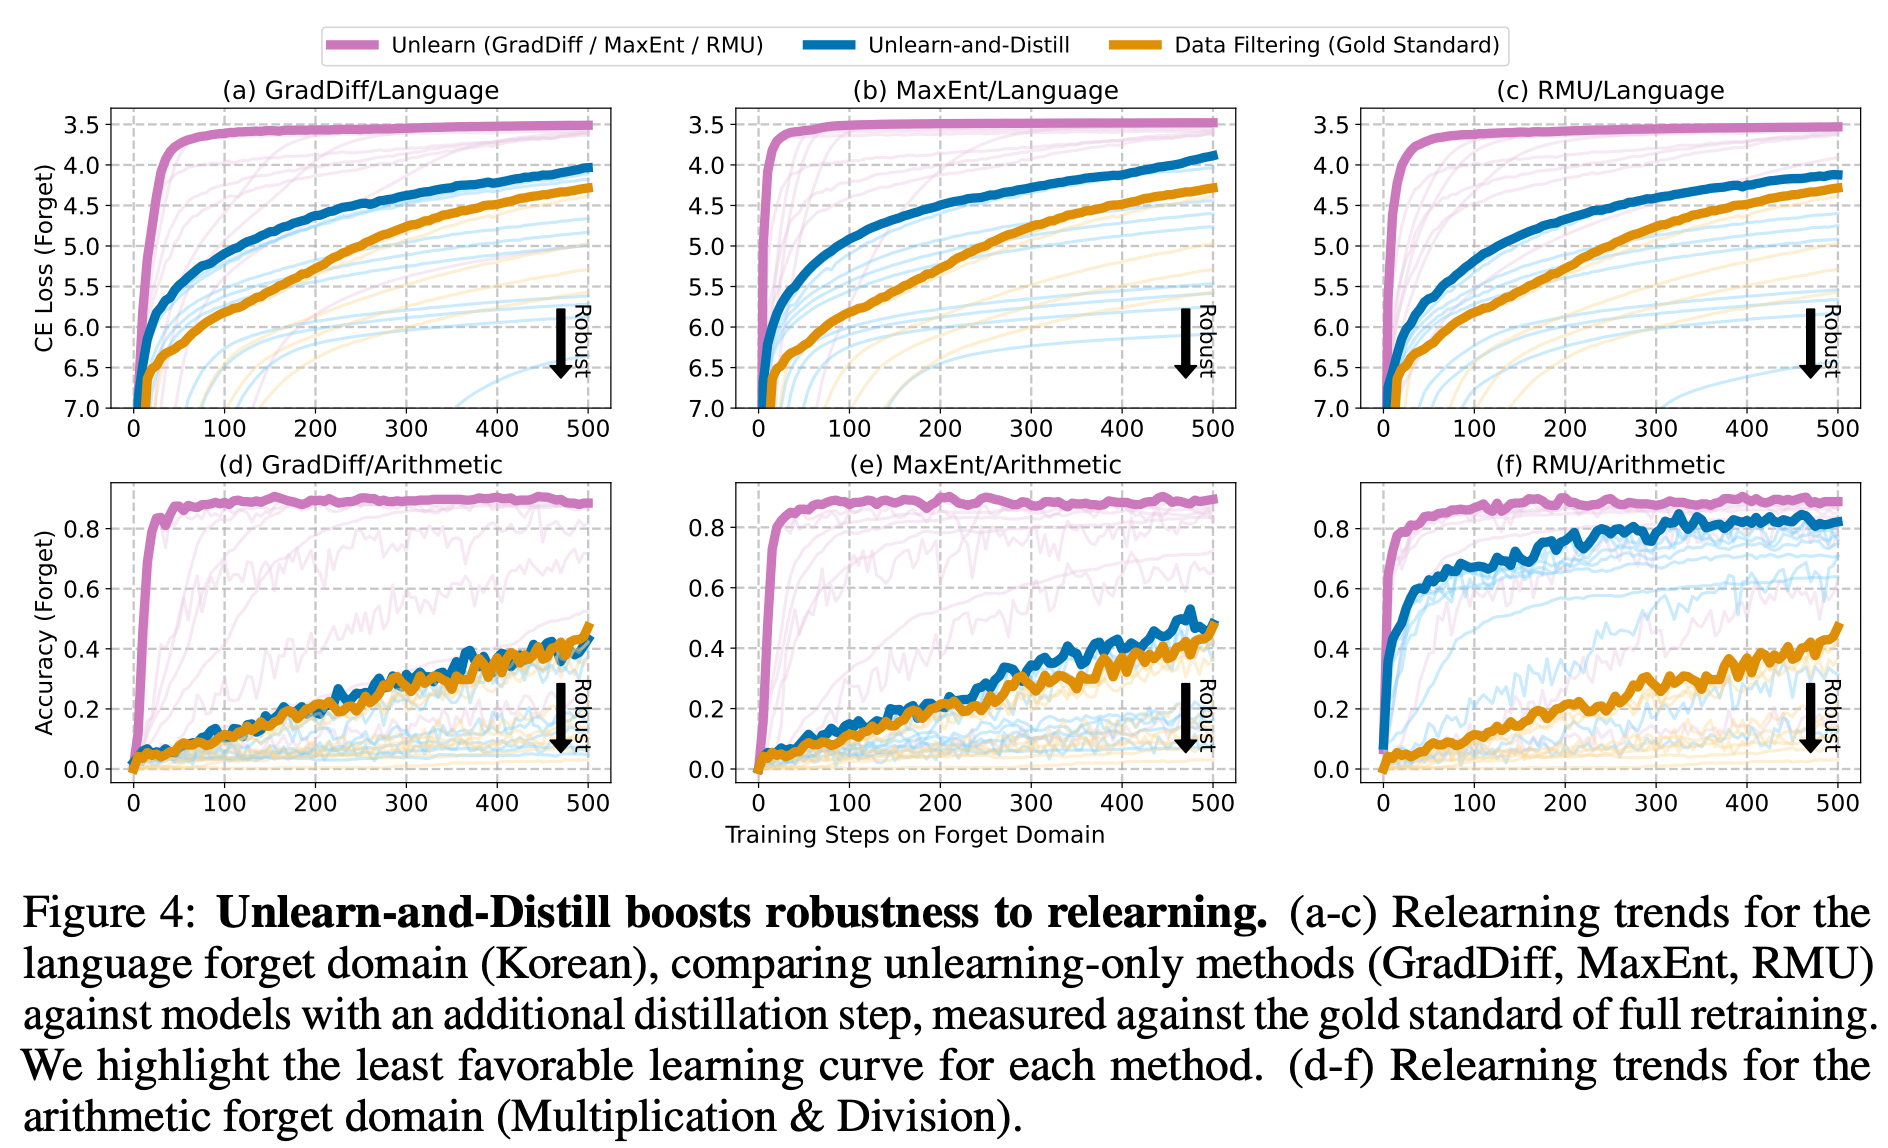
| 색상 | 모델 | 의미 |
|---|---|---|
| 🟣 보라색 | Unlearn | Unlearning만 적용 |
| 🔵 파란색 | Unlearn-and-Distill | Unlearning 이후 Distillation |
| 🟠 주황색 | Data Filtering | 한국어 데이터를 제외하고 처음부터 학습 |
- X축: Relearning Attack의 Fine-tuning Step
- Y축: Forget 데이터에 대한 Cross-Entropy Loss
- CE Loss가 높을수록 제거 대상 능력을 잘 수행하지 못함
- CE Loss가 낮아질수록 제거 대상 능력이 복구됨
여러 Learning Rate로 공격했을 때, 제거된 능력이 가장 잘 복구되는 공격 결과를 굵은 선으로 표시한 것.
Fine-tuning을 진행할수록 Forget 성능이 빠르게 증가한다면 Unlearning의 강건성이 낮다는 의미이다.
반대로 Forget 성능이 천천히 증가할수록 재학습 공격에 강건한 모델이라고 볼 수 있다.
Unlearning만 수행하면 Fine-tuning으로 지식이 빠르게 복구되지만, Distillation을 추가하면 복구 속도가 현저히 느려진다.
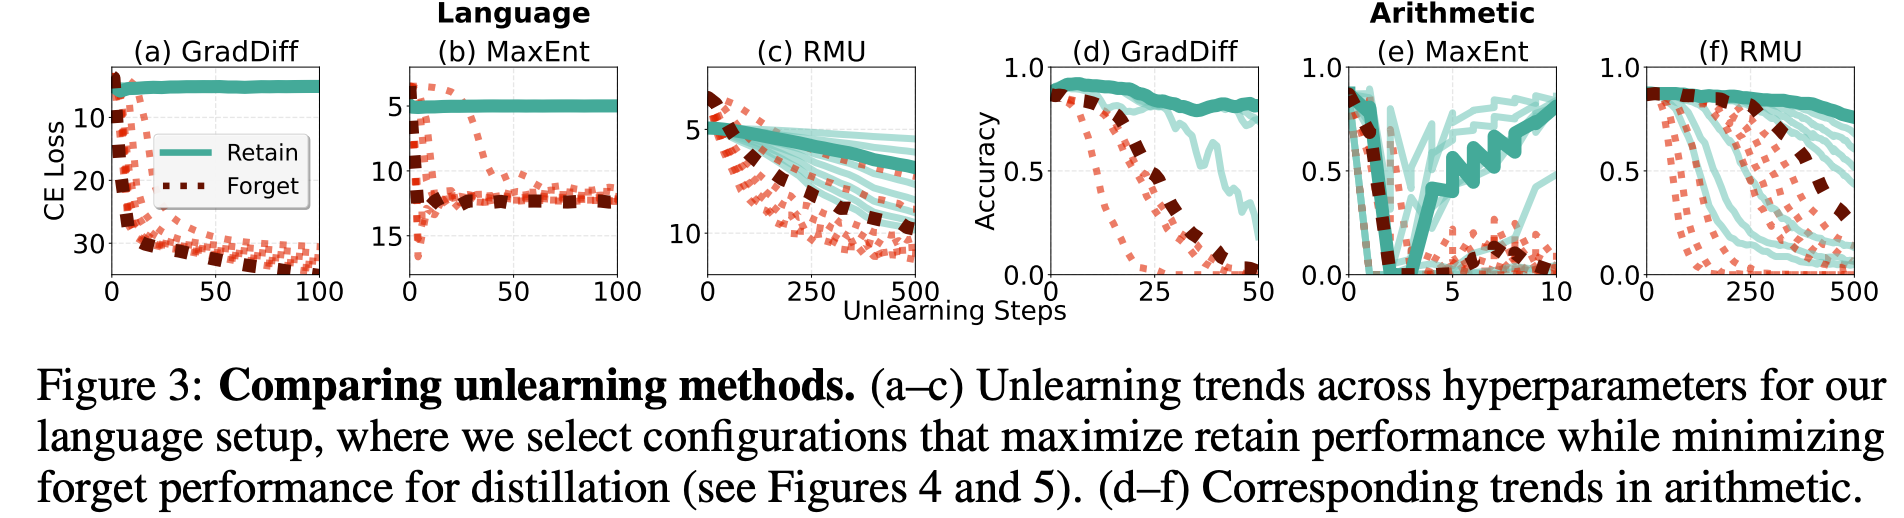
두 방법의 Unlearning 직후 성능을 비교하면 다음과 같다.
Figure 3에서 RMU는 Retain Accuracy 62%, Forget Accuracy 6.8%를 기록한 반면, MaxEnt는 Retain Accuracy 80%, Forget Accuracy 1.3%로 더 우수한 성능을 달성했다.
| 방법 | Retain Accuracy ↑ | Forget Accuracy ↓ |
|---|---|---|
| RMU | 62% | 6.8% |
| MaxEnt | 80% | 1.3% |
- RMU: 유지해야 할 능력도 많이 손상되고, 제거해야 할 능력도 상대적으로 많이 남음
- MaxEnt: 유지할 능력은 더 잘 보존하면서 제거할 능력은 더 효과적으로 억제함
MaxEnt가 RMU보다 초기 Unlearning 성능이 좋았다.
학습 데이터 구성: 언어 실험에서는 사전학습 데이터의 약 50%가 유지할 능력(Retain)에, 나머지 50%가 제거할 능력(Forget)에 기여하도록 구성했다.
그러나 무작위 초기화 모델을 처음부터 Distillation해서 학습시키는 데는 큰 연산 비용이 발생합니다.
이를 해결하기위해 Student를 반드시 처음부터 학습해야 하는지, 아니면 기존 모델의 파라미터를 일부 활용하면서 강건성을 확보할 수 있는지 확인한다.
UNDO 알고리즘 제안
기존 모델에 Unlearning을 수행하여 제거 대상 능력이 출력되지 않도록 억제한다.
Teacher의 가중치를 복사한 다음 노이즈를 추가하여 기존에 남아 있던 잠재 능력을 약화시킨다.
노이즈로 손상된 Student를 Unlearning된 Teacher의 출력에 맞춰 학습시켜, 유지해야 할 능력은 회복하면서 제거 대상 능력은 복구하지 않도록 유도한다.
노이즈 강도를 조절하면 기존 모델을 얼마나 유지할지, 얼마나 새롭게 초기화할지 결정할 수 있다.
- 교란이 작음 → 기존 지식 유지가 쉬워 학습 비용이 적음
- 교란이 큼 → 잠재 능력의 흔적을 더 많이 제거할 가능성이 있지만 학습 비용 증가
수식
| 기호 | 의미 |
|---|---|
| \(\theta_{\text{perturbed}}\) | 노이즈가 적용된 Student 파라미터 |
| \(\theta_{\text{suppressed}}\) | Unlearning된 Teacher 파라미터 |
| \(\alpha\) | 기존 파라미터와 노이즈의 혼합 비율 |
| \(\beta\) | 노이즈 크기 조절 계수 |
| \(N\) | 무작위로 생성한 노이즈 |
\(\alpha\)가 커질수록 기존 Teacher 파라미터의 영향은 줄어든다.
그리고 신경망 가중치 초기화에 사용하는 Xavier 방식으로 노이즈를 생성한다.
| α | Student 초기 파라미터 | 의미 |
|---|---|---|
| 0 | \(1.0\theta\) | 기존 모델 그대로 사용 |
| 0.25 | \(0.75\theta+0.25N\) | 기존 파라미터 대부분 유지 |
| 0.5 | \(0.5\theta+0.5N\) | 기존 파라미터와 노이즈 혼합 |
| 0.75 | \(0.25\theta+0.75N\) | 노이즈 영향이 더 큼 |
| 1.0 | \(N\) | 완전한 무작위 초기화 |
UNDO의 핵심은 반드시 랜덤 노이즈를 추가하는 것이 아니라, 기존 모델의 파라미터를 손상시키는 것
Experimental Setup
실험에서는 세 가지 Unlearning 방법 중 MaxEnt를 적용한 모델을 Teacher로 사용
이후 Teacher의 가중치에 노이즈를 추가해 Student를 초기화하고, Teacher와 Student의 출력 분포가 유사해지도록 학습
노이즈 크기 계수 \(\beta\)는 0.1로 고정하고, \(\alpha\)를 변경하면서 Student의 초기화 정도가 강건성과 학습 비용에 어떤 영향을 주는지 확인한다.
Distillation을 학습 중 다음 두 조건 중 하나를 먼저 만족하면 학습을 종료한다.
- Student의 Retain 성능이 Teacher의 95% 이상에 도달
- 사전학습 데이터 전체를 1 Epoch 학습 완료
언어 능력은 가중치를 \(\alpha=0.2\)로 조금만 교란해도 지식 복구가 어려워졌지만, 산술 능력은 \(\alpha\geq0.55\)로 더 강하게 교란해야 효과가 뚜렷하게 나타났다.
또한 혼합 계수 \(\alpha\)의 변화는 노이즈 크기 \(\beta\)보다 강건성에 더 큰 영향을 미치며, \(\beta\)의 영향은 상대적으로 작았다.
Limitations
UNDO는 가중치 교란으로 원치 않는 능력의 복구를 어렵게 만들지만, 이 과정에서 일반적인 능력도 손상되므로 충분한 Distillation이 필요하다. WMDP 실험에서는 Distillation 데이터가 부족해 Retain 성능을 충분히 복원하지 못했을 가능성이 있으며, 이 때문에 기존 방법 대비 뚜렷한 우위를 보이지 못했다.
왜냐하면
- Unlearning을 통해 기존 LLM에서 위험한 능력을 억제한다.
- Noise를 주어 모델의 가중치를 교란한다.
- \(\theta_{\text{student}}=(1-\alpha)\theta_{\text{teacher}}+\alpha\beta N\)
그런데 여기서 문제가 발생한다.
가중치를 교란하면 위험한 지식뿐만 아니라 유지해야 할 일반적인 지식도 함께 손상된다.
예를들면
| 능력 | Unlearning된 Teacher | Noise 적용 Student |
|---|---|---|
| 일반 지식(MMLU) | 60% | 35% |
| 위험 지식(WMDP) | 5% | 3% |
위험한 능력은 억제되었지만 일반적인 능력까지 크게 감소한다.
따라서 본 논문에서는 Distillation으로 일반적인 능력을 복원하면 되지 않을까? 라고 생각한다.
그런데 여기서 Distillation에 사용할 데이터와 학습량이 부족하면 손상된 일반적인 능력을 충분히 복원하지 못할 수 있다는 문제가 발생한다.
예를들면
| 능력 | Teacher | Noise 적용 Student | Distillation 후 Student |
|---|---|---|---|
| MMLU | 60% | 35% | 55% |
| WMDP | 5% | 3% | 4% |
논문에서는 UNDO 적용 모델의 MMLU 성능이 평균 4.88%p 감소했다고 보고한다.
실제 실험에서는
① 언어·산술 실험 (합성 데이터)
- 직접 만든 비교적 단순한 모델을 사용
- Distillation에 충분한 학습 데이터를 활용
- 따라서 손상된 Student의 Retain 능력을 효과적으로 복원할 수 있었음
② WMDP 실험 (실제 LLM)
- 실제 사전학습된 Gemma-2-2B 모델 사용
- 모델이 학습한 지식이 방대하고 복잡함
- Distillation 데이터는 기존 사전학습 데이터 규모의 0.015%에 불과
- 따라서 손상된 Student의 일반적인 능력을 충분히 복원하지 못했을 가능성이 있음
(부록) 추가 Unlearning 방법
Relearning Attack은 Fine-tuning을 통해 가중치를 변경하여 제거된 능력을 복구한다. SAM은 가중치가 조금 변경되어도 Unlearning 효과가 유지되는 평탄한 Loss 영역을 찾아 학습한다.
기존 Unlearning은 모델의 출력만 억제할 수 있기 때문에, RepNoise는 내부의 Hidden Representation까지 교란하여 제거된 능력이 쉽게 복구되지 않도록 학습하는 방법
기존 LLM:
\(\text{한국어 입력} \rightarrow \text{Hidden Representation} \rightarrow \text{정확한 한국어 출력}\)
일반적인 Unlearning 이후
\(\text{한국어 입력} \rightarrow \text{한국어 정보가 남아 있는 Hidden} \rightarrow \text{잘못된 출력}\)
내부에는 한국어 관련 표현이 남아 있지만 최종 출력만 억제된 상태.
RepNoise 적용 이후
\(\text{한국어 입력} \rightarrow \text{교란된 Hidden Representation} \rightarrow \text{부정확한 출력}\)
수식:
\(\mathcal L_{\text{noise}}= D\left( P(h_l(x_{\text{forget}})), \mathcal N(0,I) \right) \)
- \(P(h_l(x_{\text{forget}}))\): Forget 데이터로부터 생성되는 내부 표현의 분포
- \(\mathcal N(0,I)\): 표준 정규분포
- \(D\): 두 분포의 차이를 측정하는 함수
Comment