
서론
이번장은 1장의 마지막 질문인 \(Z_\theta=\int f_\theta(x)dx\) 라는 적분을 실제로 어떻게 다룰 것인가?에 대해서 이여서 다뤄본다. 이를 해결하기 위한 방법
- ① 이미 풀린 꼴을 이용하는 방법(가우시안)
- ② 표본 평균으로 적분을 근사하는 방법(몬테카를로)
를 다뤄본다.
본론
1장에서 어디서 막혔는가?
1장에서 신경망은 복잡한 데이터 분포의 모양을 표현할 수 있다는 것을 보았다. 하지만 신경망의 출력 \(f_\theta(x)\)는 모양일 뿐 확률이 아니다. 확률밀도가 되려면 전체 넓이가 1이어야 하므로
처럼 전체 넓이 \(Z_\theta\)로 나누어야 한다. 문제는 고차원에서 이 적분을 직접 계산할 수 없다는 것이었다. 칸을 하나씩 세는 방법밖에 없는데, 차원이 오르면 칸의 수가 지수적으로 늘어나기 때문이다.
그러니 막힌 곳은 결국 하나다. 적분을 어떻게 계산할 것인가. 적분을 다루는 길은 크게 둘이다.
- 적분의 답을 정확히 알고 있는 구조를 쓴다 → 가우시안
- 표본을 여러 개 뽑아 그 평균으로 적분값을 근사한다 → 몬테카를로
첫 번째 길: 적분이 이미 풀려 있는 구조를 사용한다
가우시안이 유용한 이유는 한 번 적분을 풀어 놓으면 이후 무슨 연산을 해도(늘리고, 곱하고, 더해도) 다시 가우시안이 나오기 때문이다.
가우시안의 확률밀도함수는
이다. 여기서 . \(t=\dfrac{x-\mu}{\sigma}\)로 치환하면 \(dx=\sigma\,dt\)이고
가 된다. 중심 \(\mu\)는 평행이동이라 넓이를 바꾸지 않고, 폭 \(\sigma\)는 가로로 늘리는 것이라 넓이에 \(\sigma\)배만 한다. 그래서 모든 가우시안의 넓이는 결국 딱 하나의 적분
에 \(\sigma\)를 곱한 것으로 귀결된다. 이 \(I\) 하나만 구하면 어떤 \(\mu,\sigma\)에 대해서도 넓이가 \(\sigma I\)로 나온다.
그리고 \(I=\sqrt{2\pi}\)라는 것을 보이면 \(\sigma I=\sqrt{2\pi}\,\sigma=\sqrt{2\pi\sigma^2}\)이 되어 밀도함수 앞의 계수가 정확히 설명된다. 그래서 이 적분이 핵심이다.
이제 적분의 값을 계산하는 핵심적인 부분인 \(I\)에 대해서 알아보자.
이고, 이 값은 \(I=\sqrt{2\pi}\) 라는 것을 알아내면 된다.
이 적분은 1차원에서는 풀리지 않는다. \(e^{-x^2/2}\)의 원시함수를 우리가 아는 함수(다항식, 지수, 로그, 삼각함수)의 조합으로 쓸 수 없기 때문이다. 그래서 차원을 하나 올린다.
\(I\)는 숫자 하나이므로 적분변수 이름은 상관없다. 두 적분을 구분하기 위해 하나는 \(x\), 다른 하나는 \(y\)로 쓰면
첫 번째 적분은 \(y\)와 무관하고 두 번째는 \(x\)와 무관하므로 하나의 이중적분으로 합칠 수 있다.
지수의 곱은 지수의 합이므로
이제 이것은 \(xy\)평면 전체 위에서 곡면 \(z=e^{-(x^2+y^2)/2}\) 아래에 쌓인 부피를 구하는 문제가 됐다.
\(x^2+y^2\)은 점 \((x,y)\)에서 원점까지 거리 \(r\)의 제곱이다. 따라서
함수값은 \(x,y\)가 각각 얼마인지와 무관하고 원점에서의 거리 \(r\)만으로 정해진다. 예를 들어 \((3,4)\), \((5,0)\), \((0,-5)\), \((-3,4)\)는 전부 거리 5이므로 함수값이 모두 \(e^{-25/2}\)로 같다. 같은 원 위의 점들은 함수값이 전부 동일하다. 이것이 회전대칭이다. 원점에서 \(r=0\)이라 높이 \(e^0=1\)로 최대이고, 멀어질수록 높이가 0으로 떨어지는 종 모양 곡면이다.
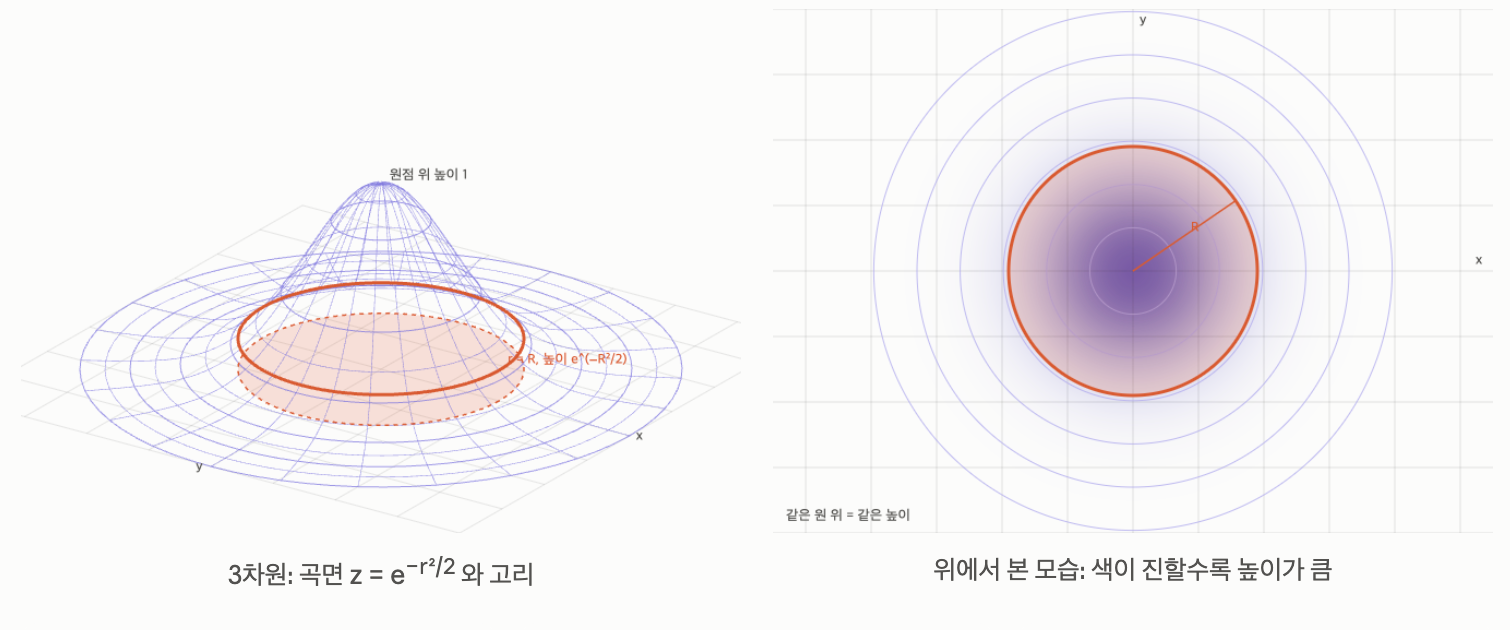
이런 성질을 회전대칭이라고 하고, 3차원으로 그려보면 원점 위에 종(bell) 모양 언덕이 있는데 어느 방향에서 봐도 똑같은 모양이다.
함수가 \(r\)에만 의존한다면, \(x, y\)좌표로 계산하는 것보다 극좌표 \((r, \theta)\) 로 계산하는 게 단순하다. 따라서 극좌표로 바꾸면 넓이 요소가 \(dx\,dy = r\,dr\,d\theta\) 가 된다.
두 적분의 순서는 바꿔도 되므로(피적분함수가 양수이고 전체 적분값이 유한하다는 조건 아래에서 성립한다), \(\theta\) 적분을 안쪽으로 가져와 먼저 처리하는 편이 쉽다.
안쪽 괄호를 보자. \(\theta\)에 대해 적분하는 동안 \(r\)은 고정된 상수다. 그런데 피적분함수 \(e^{-r^2/2}\,r\)에는 \(\theta\)가 아예 들어 있지 않다. 즉 \(\theta\) 입장에서는 그냥 상수를 \(0\)부터 \(2\pi\)까지 적분하는 것이다. 상수 \(c\)를 구간 길이 \(L\)만큼 적분하면 \(cL\)이므로
이제 남은 것은 \(r\)에 대한 적분 하나다.
원래 \(e^{-x^2/2}\)는 원시함수가 없어서 못 풀었다. 그런데 지금 피적분함수는 \(e^{-r^2/2}\)가 아니라 \(e^{-r^2/2}\cdot r\)이다. 극좌표 넓이 요소 \(r\,dr\,d\theta\)에서 딸려 나온 \(r\)이 하나 더 붙어 있다. 이 \(r\)이 있으면 풀린다.
\(e^{-r^2/2}\)를 \(r\)로 미분하면 연쇄법칙에 의해
이므로, \(r\,e^{-r^2/2}\)는 \(-e^{-r^2/2}\)의 도함수다.
\(u=\dfrac{r^2}{2}\)로 둔다. 양변을 \(r\)로 미분하면 \(\dfrac{du}{dr}=r\), 즉
이다. 피적분함수의 \(r\,dr\)이 통째로 \(du\)로 바뀐다. 적분 구간도 바꾼다. \(r=0\)이면 \(u=0\), \(r\to\infty\)이면 \(u\to\infty\).
\(e^{-u}\)의 원시함수는 \(-e^{-u}\)이므로
\(u\to\infty\)에서 \(e^{-u}\to0\)이고, \(u=0\)에서 \(e^0=1\)이다. 따라서
앞에서 본 대로 일반 가우시안의 넓이는 \(\sigma I\)였으므로
이고, 밀도함수 앞의 계수 \(\dfrac{1}{\sqrt{2\pi\sigma^2}}\)는 정확히 이 넓이로 나눈 것이다.
차원이 올라가도 공식은 그대로다
지금까지 \(\sqrt{2\pi}\)를 구할 때의 \(x\)는 숫자 하나였다. 그런데 1장에서 우리가 다루려던 데이터는 숫자 하나가 아니다. \(28\times28\) 흑백 이미지 한 장은 픽셀 값 784개다. 그러니 데이터 하나는
라는 숫자 784개의 묶음, 곧 784차원 벡터다. 이미지의 확률을 말하려면 밀도 \(p(\mathbf{x})\)는 이 784개 숫자 전체를 입력으로 받아야 한다.
먼저 각 축이 서로 독립이라고 가정해보자.
\(d\)차원 벡터를 \(\mathbf{x}=(x_1,x_2,\dots,x_d)\)\(i\)번째 성분 \(x_i\)를 \(i\)번째 축의 값이다.
예를들어 이미지라면 \(x_1\)은 첫 번째 픽셀의 밝기, \(x_2\)는 두 번째 픽셀의 밝기다.
\(d\)개 축이 전부 서로 독립이면 결합확률밀도는 각 축의 밀도를 곱한 것과 같다.
그리고 각 \(x_i\)가 평균 \(\mu_i\) 분산 \(\sigma_i^2\)를 가진 가우시안이라면
이다. 따라서 전체 \(d\)차원 밀도는
가 된다.
예를들어 \(d=2\)라면
여기서 앞의 정규화 상수끼리 모으고, 지수함수끼리 모으면 된다.
지수 안이 각 축의 "중심에서 떨어진 거리의 제곱"을 폭으로 나눠 더한 것 하나로 묶였다.
앞부분은 전체 밀도의 크기를 1로 맞춰주는 정규화 부분이다: \( \prod_i\sqrt{2\pi\sigma_i^2}\)
이제 식을 행렬과 벡터 형태로 이뤄지도록 바꿔보자.
먼저 평균들을 모아서 \(\boldsymbol{\mu} = (\mu_1,\mu_2,\dots,\mu_d)\) 라고 하자.
그러면 \(\mathbf{x}-\boldsymbol{\mu}\) 는 각 축에서 평균으로부터 얼마나 떨어졌는지를 모은 벡터이다.
현재는 축들이 서로 독립이라고 가정했으므로 공분산 행렬은
처럼 대각선에 각 축의 분산만 들어간다.
가우시안 식에서는 분산이 분모에 있었으므로 역행렬을 사용하면
가 된다.
지수부분은 \(-\sum_i\dfrac{(x_i-\mu_i)^2}{2\sigma_i^2}\)이므로 분모의 2를 밖으로 빼면
정규화 상수 부분은 \(\prod_i\sqrt{2\pi\sigma_i^2}\) 에서 \(\sqrt{2\pi\sigma_i^2}=\sqrt{2\pi}\cdot\sigma_i\) 이므로
제 \(\prod_i\sigma_i\)를 \(\Sigma\)로 쓴다. 대각행렬의 행렬식은 대각선 원소의 곱이므로
따라서
두 부분을 합치면
이것이 \(d\)차원 가우시안의 일반적인 꼴이다.
지금은 \(\Sigma\)가 대각행렬인 경우에서 유도했지만, 이 식은 독립인 경우에 대해서 \(\Sigma\)가 있는 경우(축끼리 관계가 있는 경우)에도 그대로 정의로 쓴다. 그 경우가 왜 여전히 가우시안인지는 2.2절에서 확인한다.
그러면 \(\sum_{i=1}^{d} \frac{(x_i-\mu_i)^2}{\sigma_i^2}\) 를 행렬로 한 번에 \(\boxed{ (\mathbf{x}-\boldsymbol{\mu})^\top \Sigma^{-1} (\mathbf{x}-\boldsymbol{\mu}) }\) 라고 쓸 수 있다.
이 식을 실제로 전개하면 정확히
가 나온다.
이걸 어떻게하고 저렇게하면 최종적으로
으로 나온다.
Comment